
# 勤奋的凯尔森同学10000h刻意练习Day9:支持向量机 —— 谁在"撑"住决策边界?从最大间隔到核技巧
所属专栏: 凯尔森的10000h刻意练习
Slogan: 一个36岁程序员,研究生(学硕),前世界500强top20软件开发Java工程师,用10000小时深耕AI,目标Top10 AI资深工程师,全程日更记录。
两类样本之间能画出无数条把它们分开的直线,凭什么说其中某一条最好?
Day7的逻辑回归用"概率最优"选一条,Day8的决策树干脆用if-else切;而今天的主角SVM支持向量机给出了一个异常简洁的答案——离两边最近的样本都最远的那条。今天就沿着"为什么要间隔最大 → 数据不干净怎么办 → 直线分不开怎么办"这条线,把最大间隔、软间隔、核技巧一路讲透。
昨天(Day8)的决策树和随机森林用if-else切分数据,今天学另一个能处理非线性的经典模型:SVM支持向量机。SVM的核心思想是最大间隔——选离正负样本都最远的决策边界,泛化能力强;支持向量是贴在间隔边界上的少数样本,SVM的决策边界只由它们决定;核技巧让SVM不需要真的做高维映射就能在低维算出高维点积,从而处理非常复杂的非线性边界。
# 1.1 无数条直线里选哪条:最大间隔
# 1.1.1 直觉:最宽的马路
二分类数据中,能把正负样本分开的直线(或超平面)可能有无数条。SVM选离两边最近样本距离最大的那条——就像在两排房子之间修一条最宽的马路,马路的中心线就是决策边界。
负样本 ● ● ● ●
        ╲
         ╲   ← 间隔(margin),越宽越好
          ╲──────────── 决策边界
           ╲
正样本 ○ ○ ○ ○
2
3
4
5
6
# 1.1.2 间隔的数学表达
决策超平面:
两侧的间隔边界:
为什么边界正好取 ,而不是 或别的常数?这是SVM公式里最容易卡住的一点,讲透了后面的目标函数才看得懂。关键在 这对参数有一个缩放自由度:把 和 同时乘以任意正数 ,超平面 和原来的 是同一个平面——就像 和 是同一条直线。既然 的大小可以随便缩放、超平面却不动,那"间隔边界取多少"其实只是个刻度选择,不是物理要求。
具体看:设最近样本的"函数间隔"(没归一化的原始值)为 ,真正的几何间隔是 。把 整体乘 后 、,几何间隔 纹丝不动——所以 取多少都不影响实质,纯粹是个标尺。那不如旋到一个干净的刻度:令 ,把最近样本的函数间隔归一化到1。这就是 的来历。
一个类比:摄氏度把水的冰点定为0、沸点定为100,华氏度却定为32和212——刻度不同,但"今天比昨天热"这件事不变。SVM取 就是选了一种刻度。换成 也完全等价:间隔宽度从 变成 ,最大化它等价于最小化 ,而 最终会被 的缩放吸收掉,最优解一模一样。选1只是为了让目标函数 和约束 的形式最干净。
两个边界之间的距离(间隔):
要最大化间隔,等价于最小化 ,同时要求所有样本被正确分类:
# 1.1.3 支持向量:为什么SVM要叫"支持向量"?
先把名字拆开看:"向量"指样本点(在特征空间里每个样本就是一个向量),"支持"才是这个名字的灵魂。那到底是谁在"支持"什么?
一个生活类比:两拨人面对面站着,中间要拉一条绳当分界。绳的位置由谁决定?不是所有人,而是两边站得离绳子最近的那几个人——他们正用手把绳"撑"在固定位置,后面的人只是远远看着。把其中一个撑绳的人往旁边挪一步,整条绳跟着歪;但把后面看热闹的人挪走十个,绳一点也不动。
负样本侧
  ●   ●     ★   ●        ★ = 支持向量:贴在间隔边界上,撑住决策边界
─────────────────────────  ← 负侧间隔边界 (wᵀx+b = -1)

─────────────────────────  ← 决策边界 (wᵀx+b = 0)

─────────────────────────  ← 正侧间隔边界 (wᵀx+b = +1)
  ●   ★     ●   ●        ● = 普通样本:离边界远,删掉不影响边界
正样本侧
2
3
4
5
6
7
8
9
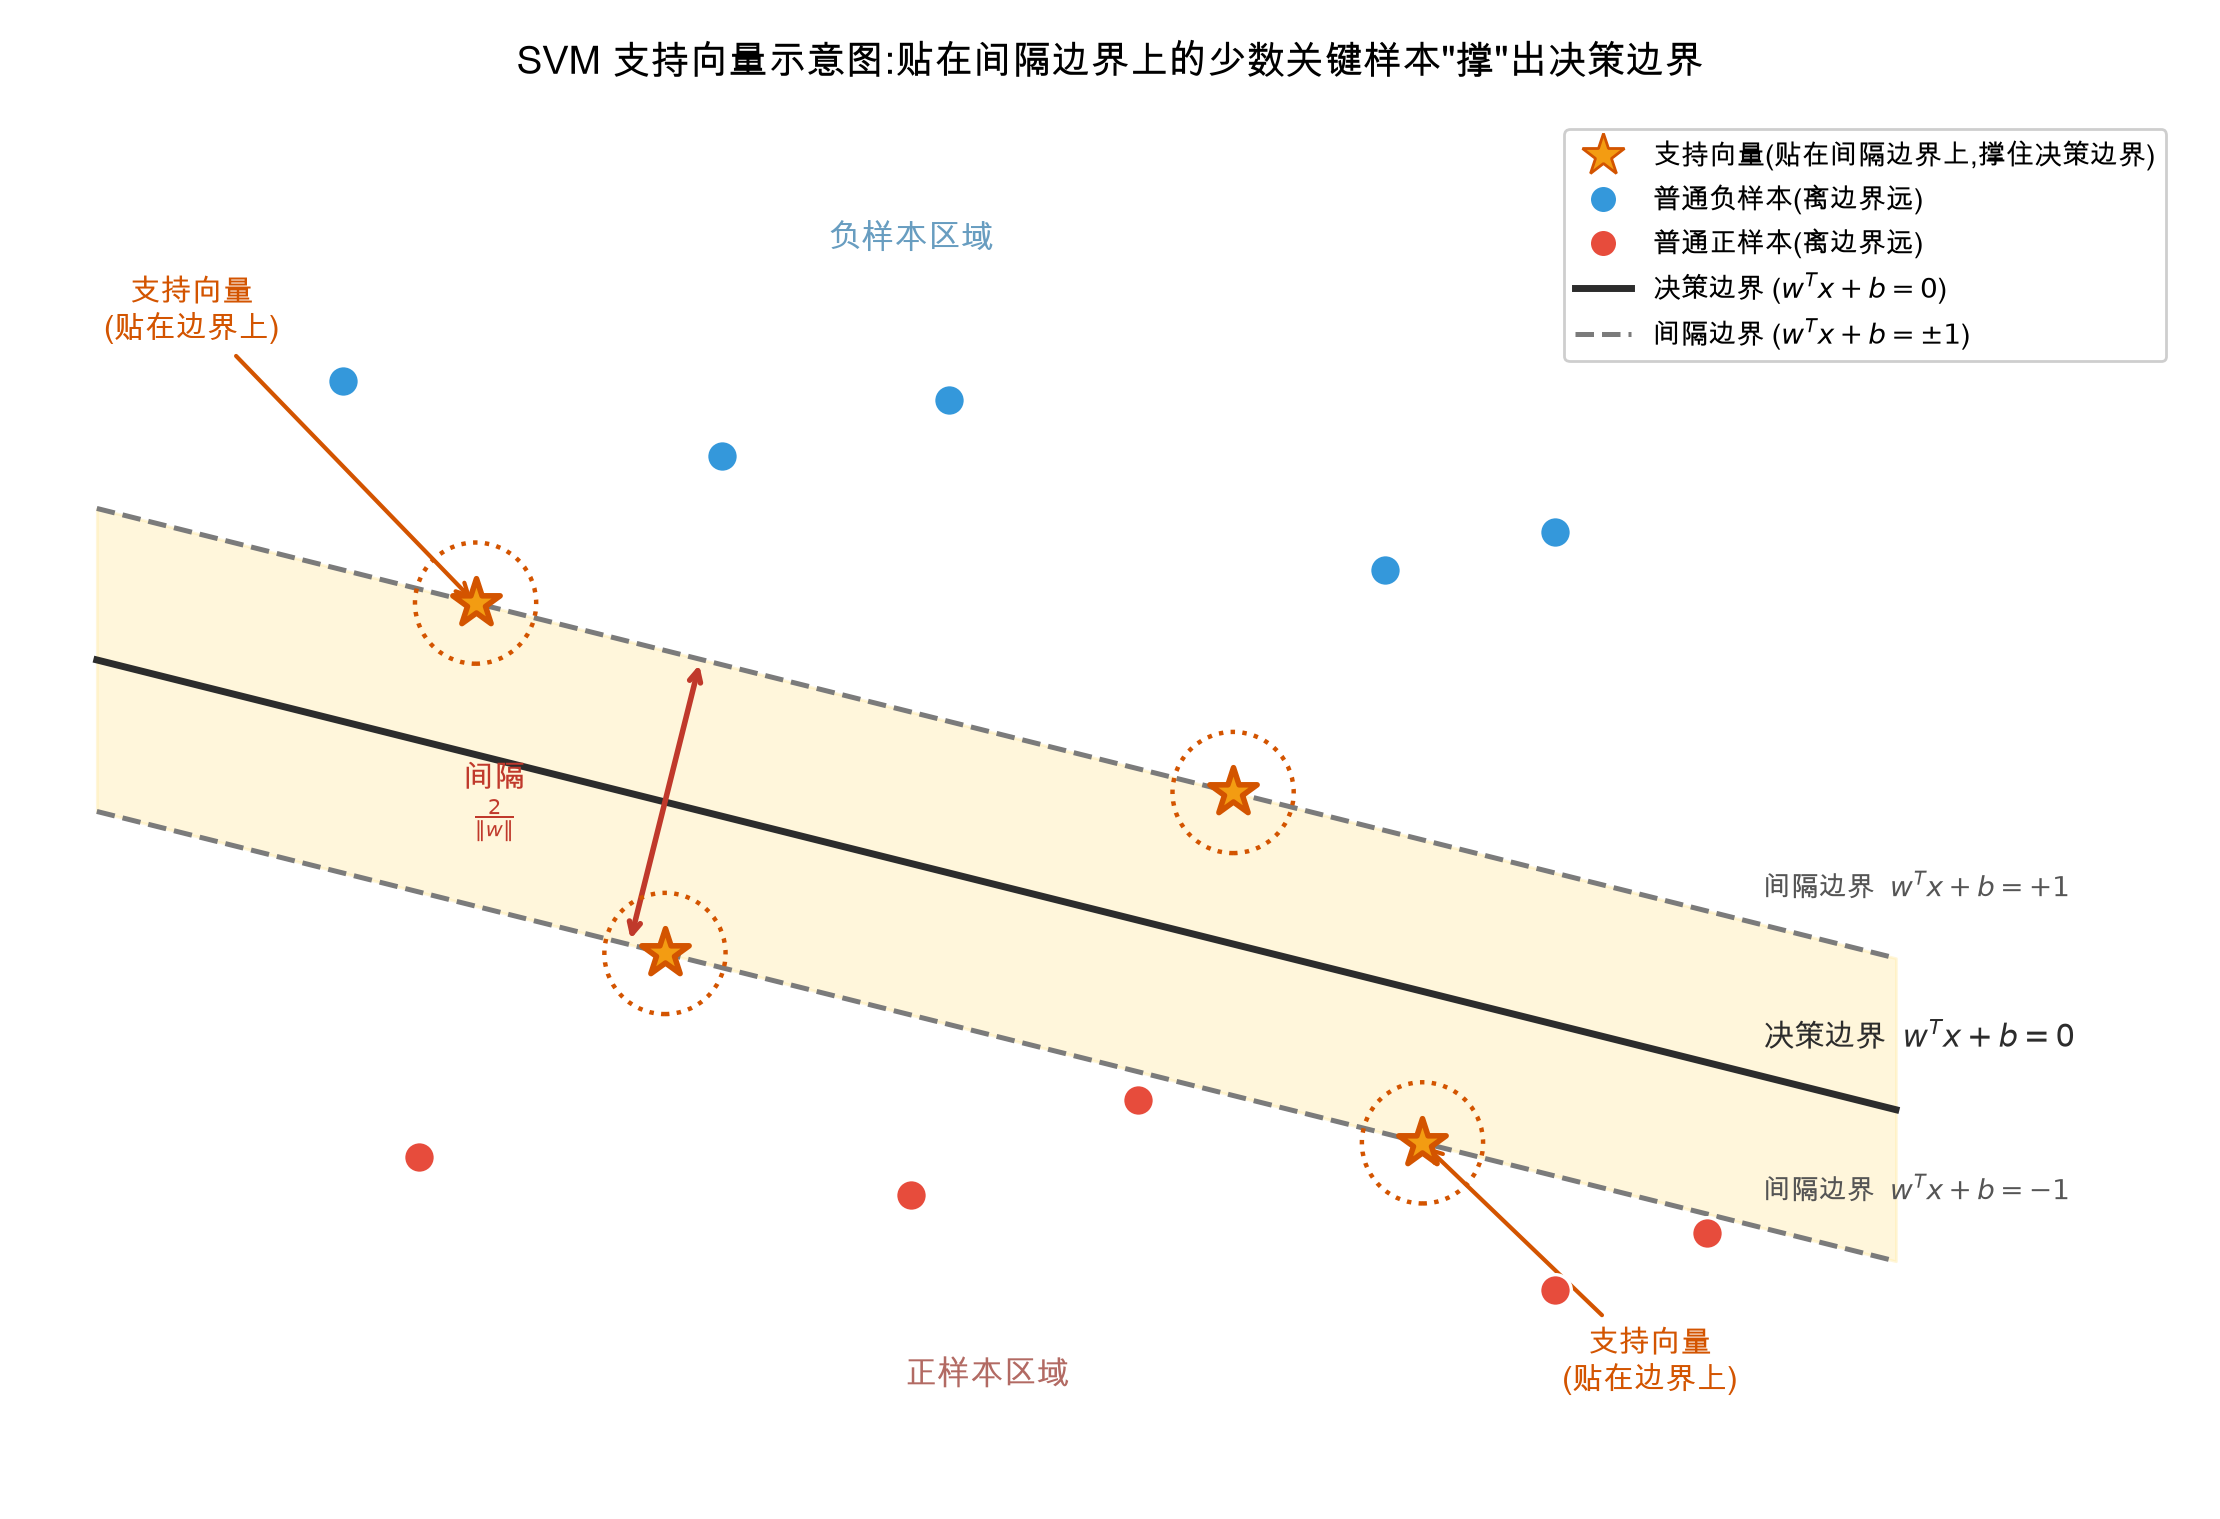
上图把ASCII里抽象的 ★ 和 ● 具象化了:只有贴在虚线(间隔边界)上的几个点被高亮——它们就是支持向量。中间实线是决策边界,由这些支持向量"撑"住位置;其余离边界远的点无论怎么挪动(只要别越过虚线),边界都不动。
支持向量就是那些"撑绳的人"——它们正好贴在间隔边界上,满足 (这个1怎么来的见1.1.2节"缩放自由度"),是离决策边界最近的那批样本。
为什么叫"支持"?因为决策边界真就是被它们"撑"出来的:
- 删掉任意一个支持向量 → 决策边界会移动(它撑的那一侧绳子塌了)
- 删掉任意一个非支持向量 → 边界纹丝不动(后面看热闹的人走光了也没事)
- 移动非支持向量(只要别越过间隔边界) → 边界也不动
这就是SVM最反直觉也最漂亮的性质:200个样本训出来的模型,可能只有20个点真正"有用",剩下180个点白给了。后面1.4节的代码会直接打印 n_support_,你会亲眼看到这个数字往往远小于总样本数。
为什么SVM在小样本上也能很强?答案就在这里——模型记忆的不是全部数据,而是少数几个关键点。只要这些"撑绳的人"位置对,决策边界就稳。逻辑回归、神经网络用所有样本的梯度一起更新权重,样本少时容易被噪声带偏;SVM只关心边界附近的几个点,反而稳。
软间隔下谁算支持向量? 1.2节会引入松弛变量 ,把"贴在边界上"这个硬约束放宽为"贴住或越界"——满足 的样本都算支持向量(正好贴边的,和跨过边界一点点的,都算)。判断标准始终是**"这个点对边界有影响吗"**,有影响的就是支持向量。
# 1.2 数据不干净怎么办:软间隔与松弛变量
现实数据几乎总是有噪声或异常点,硬间隔(要求所有样本正确分类)会导致过拟合。软间隔允许少量样本"越界"或被分错,引入松弛变量 :
约束的含义:样本可以不满足"间隔 ≥ 1",但缺口有多大,就要用多大的 记账。第一项 负责把间隔撑大,第二项 是所有越界样本的总惩罚,超参数 决定这两项谁更重要。
C参数的含义:
| C值 | 效果 |
|---|---|
| C大 | 间隔小,对错误容忍低,可能过拟合 |
| C小 | 间隔大,对错误容忍高,可能欠拟合 |
C是SVM最关键的超参数,需要交叉验证来选。
# 1.2.1 手推hinge loss小例子
软间隔目标函数里的松弛变量 等价于一个"损失"——当样本被分错或离边界太近时才有惩罚。把约束 代入目标、消去 ,得到无约束形式:
其中 就是hinge loss(合页损失)。下面用3个样本手算一遍,看清"分类正确且够远→0、越接近边界→越大、分错→线性增长"。
# 1. 设定数据
3个样本,,得分 :
| 样本i | 标签 | 得分 | 间隔量 |
|---|---|---|---|
| 1 | +1 | +2 | +2 |
| 2 | +1 | +0.5 | +0.5 |
| 3 | -1 | -1 | +1 |
# 2. 逐个算hinge loss
把三个样本的 和 分别代入:
| 样本 | 说明 | ||
|---|---|---|---|
| 1 | 0 | 正类且 ,分对且够远 → 0 | |
| 2 | 0.5 | 正类、 分对但 ,离边界太近 → 0.5 | |
| 3 | 0 | 负类、,正好贴在边界上 → 0 |
# 3. 平均损失
三个样本的损失求平均,得到这批样本的平均hinge loss:
直觉:hinge loss只在"间隔量 "时才产生惩罚——分对还不够,必须离边界够远(间隔 ≥ 1)才算"免罚"。这正是SVM"最大间隔"思想在损失函数上的体现:它不满足于"刚好分对",而要求"分得有把握"。 越大,这一项的权重越高,模型越不能容忍边界附近的样本,间隔就越窄。
# 1.3 直线分不开怎么办:核函数与核技巧
# 1.3.1 问题:线性不可分
很多数据在原空间无法用直线分开。经典的例子是异或问题:四个点 (0,0)→0,(1,1)→0,(0,1)→1,(1,0)→1,任何直线都分不开。
# 1.3.2 核技巧:把数据映射到高维
如果把数据映射到更高维空间,可能就线性可分了。比如异或问题,加一个特征 ,在三维空间里就能用平面分开。用代码验证一下——二维空间线性模型只能猜对一半,加上 后准确率立刻100%:
from sklearn.svm import LinearSVC
import numpy as np

# 异或四个点:(0,0)->0, (1,1)->0, (0,1)->1, (1,0)->1
X_xor = np.array([[0, 0], [1, 1], [0, 1], [1, 0]], dtype=float)
y_xor = np.array([0, 0, 1, 1])

print("原二维空间:", LinearSVC(C=10).fit(X_xor, y_xor).score(X_xor, y_xor))
# 升维:[x1, x2] -> [x1, x2, x1*x2]
Phi = np.c_[X_xor, X_xor[:, 0] * X_xor[:, 1]]
print("加 z=x1*x2 后:", LinearSVC(C=10).fit(Phi, y_xor).score(Phi, y_xor))
2
3
4
5
6
7
8
9
10
11
原二维空间: 0.5
加 z=x1*x2 后: 1.0
2
注意起作用的不是 这一个轴(点 (0,0) 的 也是0),而是三维空间里存在一个能把两类分开的平面——模型学到的权重是 。
直接映射到高维的问题:维度爆炸,计算点积 非常贵。异或只加1维无所谓,但RBF核对应的映射是无穷维的,真去展开 根本算不动。
核技巧:我们不需要真的做映射,只需要一个函数 ,直接在原空间算高维点积。这就是核函数。
# 1.3.3 常用核函数
| 核函数 | 公式 | 适用场景 |
|---|---|---|
| 线性核 | 特征多、样本多,接近线性可分 | |
| 多项式核 | 图像处理(d一般2~3) | |
| RBF核(高斯核) | 通用,默认首选 | |
| Sigmoid核 | 类似神经网络 |
RBF核的直觉:RBF核把每个样本映射到无穷维空间,等价于一个无限维的多项式核。参数 控制单个样本的影响范围:
- 大:影响范围小,决策边界复杂,可能过拟合
- 小:影响范围大,决策边界平滑,可能欠拟合
sklearn里 gamma 默认 'scale',自动取 ——特征缩放后方差约为1,所以二维数据上默认约等于0.5。下一节用一组扫描直观看看gamma大小的后果。
# 1.4 半月数据实战:线性核vs RBF核
原理就绪,用sklearn跑一遍完整流程。先用 make_moons 造一组半月形非线性数据并画出来,这是检验核SVM的经典数据集:
import numpy as np
import matplotlib.pyplot as plt
from sklearn.svm import SVC
from sklearn.datasets import make_moons
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import Pipeline

# 造非线性数据:半月形
# 调用make_moons生成特征矩阵X(形状200×2)和标签向量y(形状200,取值0/1)
# n_samples=200:总共生成200个样本点,两个类别各占100个。noise=0.15:给数据添加的高斯噪声强度。
X, y = make_moons(n_samples=200, noise=0.15, random_state=42)

plt.scatter(X[y==0, 0], X[y==0, 1], label='类别0', alpha=0.7)
plt.scatter(X[y==1, 0], X[y==1, 1], label='类别1', alpha=0.7)
plt.legend()
plt.show()
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
# 1.4.1 线性SVM
先用线性核打底,看看不用核技巧时能做到什么程度。注意SVM对尺度敏感,先用StandardScaler缩放:
# 线性核:只能处理线性可分数据
# kernel='rbf':指定使用径向基函数(RBF,高斯核),这是最常用的非线性核。它的作用是隐式将数据映射到无限维特征空间,让原本二维线性不可分的双月数据,在高维空间中变得线性可分。这就是SVM的「核技巧」——不用手动构造高维特征,通过核函数直接计算高维空间的向量内积
# C=10.0:惩罚系数,控制对误分类样本的惩罚力度。C越大,模型越倾向于尽可能正确分类所有样本,决策边界越复杂。
# gamma=0.1:RBF核的核心超参数,控制高斯核的「带宽」,决定单个样本对周围区域的影响范围。
lin_svm = Pipeline([
    ('scaler', StandardScaler()),
    ('svc', SVC(kernel='linear', C=1.0))
])
lin_svm.fit(X, y)
print("线性核准确率:", lin_svm.score(X, y))
# named_steps['svc']从流水线中取出SVC模型对象
# n_support_是一个数组,分别记录每个类别的支持向量数量
print("支持向量数:", lin_svm.named_steps['svc'].n_support_.sum())
2
3
4
5
6
7
8
9
10
11
12
13
线性核准确率: 0.845
支持向量数: 66
2
直线再怎么摆也切不开两条弯月,84.5% 基本就是线性核在这份数据上的天花板。注意200个样本里有66个是支持向量——拿不准的边界点都被"记"在模型里了。
# 1.4.2 RBF核SVM
同一份半月数据换成RBF核再训一次,对比两者的准确率:
# RBF核:处理非线性
rbf_svm = Pipeline([
    ('scaler', StandardScaler()),
    ('svc', SVC(kernel='rbf', C=10.0, gamma=0.1))
])
rbf_svm.fit(X, y)
print("RBF 核准确率:", rbf_svm.score(X, y))
print("支持向量数:", rbf_svm.named_steps['svc'].n_support_.sum())
2
3
4
5
6
7
8
RBF 核准确率: 0.92
支持向量数: 61
2
同一份数据只换了个核,准确率0.845 → 0.92,弯月的形状被学出来了。
**gamma到底怎么影响边界?**与其死记"大gamma过拟合",不如扫一遍(C固定10):
for g in [0.01, 0.1, 1, 100]:
    m = Pipeline([('scaler', StandardScaler()),
                  ('svc', SVC(kernel='rbf', C=10.0, gamma=g))]).fit(X, y)
    n_sv = m.named_steps['svc'].n_support_.sum()
    print(f"gamma={g:6} 训练准确率={m.score(X, y):.4f} 支持向量数={n_sv}")
2
3
4
5
gamma=  0.01 训练准确率=0.8450 支持向量数=73
gamma=   0.1 训练准确率=0.9200 支持向量数=61
gamma=     1 训练准确率=0.9950 支持向量数=21
gamma=   100 训练准确率=1.0000 支持向量数=188
2
3
4
反直觉的点:gamma=100时训练准确率100%,看着最强,但200个样本里188个成了支持向量(94%)——模型几乎把每个点都"记"成了边界,本质上和Day8里不剪枝的决策树把训练集背下来是一回事。支持向量占比突然飙升,是过拟合的明确信号:gamma大到每个样本各自圈一块地盘,边界碎成一团。真正该选的是0.1~1这种"准确率高、支持向量还少"的区间。
注:本节准确率是在训练集上算的,
make_moons只是用来观察边界形状的玩具数据;真实评估请像1.7节那样划分训练/测试集。
# 1.4.3 可视化决策边界
光看准确率不够直观。下面写一个网格着色函数,把模型在整个平面上的预测区域画出来,对比两种核的边界形状:
def plot_decision_boundary(model, X, y):
    # X[:, 0]是第一个特征(横轴),X[:, 1]是第二个特征(纵轴)。取每个特征的最小/最大值,各自向外扩展0.5,是为了让所有样本点不贴在图的边缘,留出一点空白边距
    x1_min, x1_max = X[:, 0].min() - 0.5, X[:, 0].max() + 0.5
    x2_min, x2_max = X[:, 1].min() - 0.5, X[:, 1].max() + 0.5
    # np.linspace(...)在范围内均匀取200个点。np.meshgrid把这两组坐标交叉组合,生成200×200=40000个网格点,覆盖整个画图区域
    # 返回的xx1、xx2都是形状(200,200)的二维数组,同一个位置(i,j)上的xx1[i,j]和xx2[i,j]就构成一个平面坐标点
    xx1, xx2 = np.meshgrid(np.linspace(x1_min, x1_max, 200),
                           np.linspace(x2_min, x2_max, 200))
    # xx1.ravel()、xx2.ravel()把200×200的网格拉平成一维(各40000个元素)
    # np.c_[...]:按列拼接两个一维向量,形成40000×2的数组,每一行对应一个网格点的坐标,符合模型输入格式
    # model.predict(...):输出所有网格点的预测标签(0或1),存入一维数组Z
    Z = model.predict(np.c_[xx1.ravel(), xx2.ravel()])
    # 把一维的预测结果Z,重新变回和xx1一样的200×200二维矩阵,让每个预测值和网格坐标一一对应,满足后续绘图的格式要求
    Z = Z.reshape(xx1.shape)
    # plt.contourf():填充等高线函数,根据Z的取值(0和1),把平面划分为两种颜色的区域
    plt.contourf(xx1, xx2, Z, alpha=0.3)
    # edgecolor='k':给每个点加黑色边框,让样本点在彩色背景上更清晰易辨
    plt.scatter(X[:, 0], X[:, 1], c=y, edgecolor='k')
    plt.show()

plot_decision_boundary(rbf_svm, X, y)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
把参数换成 plot_decision_boundary(lin_svm, X, y) 再画一次,两张图放一起对比最直观:线性核的边界是一条笔直的色带,硬从两个月牙中间切过去,两端各错一片;RBF核的边界是一条弯曲的带子,顺着月牙的形状绕过去。这张图比准确率数字更能说明"核"到底干了什么。
# 1.5 SVM反过来做回归:SVR
SVM也能做回归,叫SVR。思路反过来:在间隔带内的样本不算损失,只惩罚带外的样本。
from sklearn.svm import SVR

# 造数据(注意:这里会覆盖1.4节的X、y,1.7节会重新加载iris,互不影响)
np.random.seed(42)
# 生成100个一维特征样本,数值范围为 [-3,3],形状为100行1列,符合sklearn模型的输入格式
X = np.random.rand(100, 1) * 6 - 3
# 构造回归目标值,基础函数为二次函数0.5x²+x+2,叠加标准差为0.5的高斯噪声,形成带噪声的非线性回归数据。X.ravel()将二维特征数组展平为一维,和标签维度匹配
y = 0.5 * X.ravel()**2 + X.ravel() + 2 + np.random.randn(100) * 0.5

svr = Pipeline([
    ('scaler', StandardScaler()),
    ('svr', SVR(kernel='rbf', C=1.0, epsilon=0.1))
])
svr.fit(X, y)
# 在 [-3,3]区间内均匀生成200个采样点,reshape为二维数组,符合模型的输入要求。
X_plot = np.linspace(-3, 3, 200).reshape(-1, 1)
# 用训练好的SVR模型预测所有采样点的回归值
y_pred = svr.predict(X_plot)
# 绘制原始样本的散点图,alpha=0.5设置点的透明度,体现数据分布的密度
plt.scatter(X, y, alpha=0.5)
# 绘制红色的回归拟合曲线,线宽设置为2,清晰展示模型的拟合趋势
plt.plot(X_plot, y_pred, 'r-', linewidth=2)
plt.show()
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
画出来是一条顺着抛物线弯曲的平滑曲线。和Day8的回归树对比着看很有意思:回归树的预测是阶梯状且不能外推,RBF-SVR是平滑曲线,训练集范围内插值很自然(但它同样不擅长外推到训练范围之外)。
epsilon 是间隔带的宽度,带内不损失。
epsilon参数详解:
epsilon()定义了一条宽度为 的"不惩罚带"——落在带内的样本(预测值与真实值之差 )损失为0。- 大→容忍带宽→支持向量少→模型平滑→可能欠拟合。
- 小→容忍带窄→支持向量多→模型贴合数据→可能过拟合。
C在SVR里同样控制正则化强度:C大→越不能容忍带外误差→拟合更激进;C小→更平滑。
SVC与SVR的对偶关系——SVM在分类和回归上是对称的,只是"间隔带"的含义反过来:
| SVC(分类) | SVR(回归) | |
|---|---|---|
| 间隔带内 | 样本在带内()→ 分对了,不算错 | 预测离真值在 内 → 不算损失 |
| 间隔带外 | 落进带内或越界 → hinge loss惩罚 | 超出 → -insensitive loss惩罚 |
| 目标 | 最大化分类间隔 | 最大化回归"平坦带" |
| 松弛变量 | 衡量"分得不够远"的程度 | 衡量"超出容忍带"的程度 |
一句话概括:SVM分类是"间隔带内不算错",SVR回归是"间隔带内不算损失"——两者都在最小化 的同时用松弛变量惩罚"越界"的样本,只是一个惩罚分类不对/不够远,一个惩罚回归误差超 。
from sklearn.svm import SVR
from sklearn.metrics import mean_squared_error

# 调大C让模型更愿意拟合带外样本(注意:注释别写反,调小C才是抑制过拟合)
svr = Pipeline([
    ('scaler', StandardScaler()),
    ('svr', SVR(kernel='rbf', C=100, gamma=0.1, epsilon=0.1))
])
svr.fit(X, y)
print("SVR 均方误差:", mean_squared_error(y, svr.predict(X)))
2
3
4
5
6
7
8
9
10
SVR 均方误差: 0.1939
噪声本身的标准差是0.5(理论MSE下限约0.25),0.1939说明模型已经把抛物线信号基本提干净了。
epsilon扫描验证"带宽 → 支持向量数"(C固定100):
for eps in [0.05, 0.1, 0.5, 1.0]:
    m = Pipeline([('scaler', StandardScaler()),
                  ('svr', SVR(kernel='rbf', C=100, gamma=0.1, epsilon=eps))]).fit(X, y)
    print(f"epsilon={eps:5} 训练MSE={mean_squared_error(y, m.predict(X)):.4f} "
          f"支持向量数={m.named_steps['svr'].n_support_[0]}")
2
3
4
5
epsilon= 0.05 训练MSE=0.1914 支持向量数=91
epsilon=  0.1 训练MSE=0.1939 支持向量数=82
epsilon=  0.5 训练MSE=0.1971 支持向量数=25
epsilon=  1.0 训练MSE=0.2082 支持向量数=4
2
3
4
带宽从0.05放到1.0,MSE只涨了0.017,支持向量却从91个暴跌到4个——大部分样本落进"不惩罚带"后就被模型忽略了。这正是 的调节逻辑:要模型平滑、稀疏,就放大带宽;要它深耕每个点,就收窄。
# 1.6 SVM的优缺点与使用建议
# 1.6.1 优点
- 在小数据集上表现优秀
- 核函数能处理非线性
- 高维空间下表现好(特征数 > 样本数时)
- 决策边界只由支持向量决定,可解释性不错
# 1.6.2 缺点
- 样本数大时训练慢( 到 )
- 需要做特征缩放
- 超参数C和gamma需要调参
- 多分类靠拆成二分类实现:sklearn的
SVC底层默认一对一(OvO), 个类别要训 个分类器(就是Day7讲的OvO);decision_function_shape='ovr'只是把OvO的票数整形成OvR形式的输出,类别特别多时可以改用LinearSVC(原生OvR)或OneVsRestClassifier
# 1.6.3 使用建议
- 必须做特征缩放:SVM对特征尺度敏感,不缩放会导致某些特征主导距离计算。
- 先试线性核:如果特征数很多(>1000),线性核往往足够好,且训练快。
- 再试RBF核:中小数据集的通用首选核,但用1.7节的网格搜索让数据自己决定,别默认它一定赢。
- 网格搜索调参:C和gamma一起搜,用交叉验证。
# 1.7 鸢尾花三分类实战:让网格搜索替你挑核
最后在鸢尾花三分类任务上端到端走一遍:用Pipeline串起特征缩放与SVC,再用网格搜索同时挑选核函数、C和gamma。把 StandardScaler 放进Pipeline(而不是先对全量数据缩放)是Day6反复强调的铁律——网格搜索内部要做5折交叉验证,缩放器必须在每一折的训练部分上fit,否则验证折的均值/方差泄漏进预处理,分数会虚高。
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split, GridSearchCV
from sklearn.svm import SVC
from sklearn.preprocessing import StandardScaler
from sklearn.pipeline import Pipeline
from sklearn.metrics import classification_report

iris = load_iris()
X_train, X_test, y_train, y_test = train_test_split(
    iris.data, iris.target, test_size=0.2, random_state=42, stratify=iris.target
)

# 流水线:缩放 + SVM
pipe = Pipeline([
    ('scaler', StandardScaler()),
    ('svc', SVC())
])

# 网格搜索:线性核vs RBF核,不同C和gamma
param_grid = [
    {'svc__kernel': ['linear'], 'svc__C': [0.1, 1, 10, 100]},
    {'svc__kernel': ['rbf'], 'svc__C': [0.1, 1, 10, 100], 'svc__gamma': [0.001, 0.01, 0.1, 1]}
]

grid = GridSearchCV(pipe, param_grid, cv=5, scoring='accuracy', n_jobs=-1)
grid.fit(X_train, y_train)

print("最佳参数:", grid.best_params_)
print("最佳交叉验证准确率:", grid.best_score_)

y_pred = grid.predict(X_test)
print(classification_report(y_test, y_pred, target_names=iris.target_names))
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
实测输出(iris, test_size=0.2, stratify, random_state=42, sklearn 1.9.0):
最佳参数: {'svc__C': 0.1, 'svc__kernel': 'linear'}
最佳交叉验证准确率: 0.975
2
测试集准确率: 0.9333
              precision    recall  f1-score   support

      setosa       1.00      1.00      1.00        10
  versicolor       0.90      0.90      0.90        10
   virginica       0.90      0.90      0.90        10

    accuracy                           0.93        30
   macro avg       0.93      0.93      0.93        30
weighted avg       0.93      0.93      0.93        30
2
3
4
5
6
7
8
9
10
实验前,我的预期:RBF核更"高级",网格里还专门给它配了4×4组C/gamma,赢家总该是它。
实验结果:胜出的是最简单的线性核 + 最小的C=0.1,CV 0.975;RBF的16组参数没有一组超过它。
**为什么会这样?**iris只有4个特征、120个训练样本,类别本身近似线性可分——这种数据上RBF的非线性能力纯属多余,反而多了gamma要调、多了过拟合风险。
这次真正学到什么:又一次实证"没有银弹":核不是越复杂越好,网格搜索的价值恰恰是让数据自己选模型,而不是预设"RBF一定赢"。这也正是使用建议里"先试线性核"的原因。测试集0.93低于CV 0.975不用慌——测试集只有30个样本,错2个就是6.7%,小测试集上单样本权重很大。
网格搜索策略详解:
- C和gamma都按对数跨度取值(0.1 → 1 → 10 → 100、0.001 → 0.01 → 0.1 → 1),而不是均匀取值。因为这两个参数的影响是数量级级别的——C=1和C=10的差距远比C=10和C=20大,均匀网格会浪费算力在没意义的区间上。
- C控制间隔宽度:C大→间隔窄→拼命分对训练集→易过拟合;C小→间隔宽→容忍错误→易欠拟合。
- gamma控制RBF核的单点影响范围:gamma大→每个样本影响范围小→决策边界曲折复杂→易过拟合;gamma小→影响范围大→边界平滑→易欠拟合。
- C和gamma要一起搜:它们互相牵制,单独固定一个调另一个往往找不到最优点。最佳组合通常是"大C + 小gamma"或"小C + 大gamma",在对角线上分布。
refit=True(默认):网格搜索找到最佳参数组合后,用最佳参数在整个训练集上重新拟合一个模型。这样grid.predict(X_test)用的就是最佳模型,而不是某个折上的临时模型。如果设成False,grid不会重新训练,只能拿best_params_自己去fit。cv=5:5折交叉验证,每个参数组合在5个不同划分上评估取平均,比单次划分更稳健。数据小可以加到10折,数据大可以减到3折省时间。
# 1.8 SVM vs逻辑回归:到底怎么选
Day7学过的逻辑回归和今天的SVM都能做线性二分类,面试也常把两者放在一起比较。它们的设计哲学其实差别不小:
| 维度 | SVM | 逻辑回归 |
|---|---|---|
| 决策边界 | 最大间隔 | 概率最优 |
| 输出 | 默认硬分类(可开 probability=True) | 天然输出概率 |
| 核函数 | 支持 | 不直接支持 |
| 非线性 | 核函数 | 需要手动造特征 |
| 大样本 | 慢 | 快 |
| 高维小样本 | 强 | 一般 |
| 概率输出 | 需要额外训练(Platt scaling,probability=True) | 天然输出概率 |
选择建议:
- 特征数多(>1000)、样本也多 → 逻辑回归(或
LinearSVC,快且线性核往往就够) - 样本少、特征中等、需要非线性 → SVM(RBF核),但先跑线性核对照(1.7的iris实证:线性核能赢就别上RBF)
- 需要概率输出 → 逻辑回归(或SVM + Platt scaling)
# 小结
SVM的核心是"最大间隔"——选离正负样本都最远的决策边界,泛化能力强;软间隔用C参数平衡间隔宽度和分类错误;核函数(RBF最常用)让SVM能在不真正做高维映射的情况下处理非线性数据,gamma控制单个样本的影响范围;SVR把同一套思想反过来用于回归,间隔带内不算损失。SVM适合中小数据集、需要非线性决策边界的场景,大数据集上逻辑回归和树模型更有优势。
今天两次实验共同指向同一条认知升级(和Day8的"集成不是银弹"遥相呼应):模型的强弱不看理论上的复杂度,看它和数据匹不匹配——gamma=100训练集100% 却把200个点中的188个记成支持向量,RBF核在iris上反而输给最简单的线性核。让验证集和网格搜索替你做决定,比"我觉得这个模型更强"靠谱得多。
明天Day10见!See you tomorrow!