
# 勤奋的凯尔森同学10000h刻意练习Day17:手撕三层网络与学习机制 —— 前向传播、损失函数、数值梯度与梯度下降
所属专栏: 凯尔森的10000h刻意练习
Slogan: 一个36岁程序员, 研究生(学硕),前世界500强top20软件开发Java工程师,用10000小时深耕AI, 目标Top10 AI资深工程师, 全程日更记录。
网络搭好了,可它凭什么知道自己猜得对不对、又该往哪个方向调参数?
Day16把感知机和激活函数备齐了,今天先把它们拼成一个完整的三层网络,跑通“输入→权重→激活→输出”的前向传播,在手写数字上做一次推理。可推理只是“猜”,要让网络“学”,还需要三件东西:一把衡量“猜得有多错”的尺子(损失函数)、一个算“参数往哪调”的工具(数值梯度),和一套“沿着梯度迭代”的引擎(梯度下降)。
# 1.1 三层神经网络:从输入到输出的处理流程
深度神经网络由多个层(layer)组成,通常将其称之为模型(Model)。整个模型接受原始输入(特征),生成输出(预测),并包含一些参数。而在模型内部,每个单独的层都会接受一些输入(由前一层提供),生成输出(到下一层的输入),并包含一组参数;层层向下传递,就可以得到最终的输出值。
神经网络中的参数,就是每一层的权重和偏置。
我们这里以一个三层神经网络为例,实现从输入到输出的处理计算,这个过程就是前向传播(forward)。
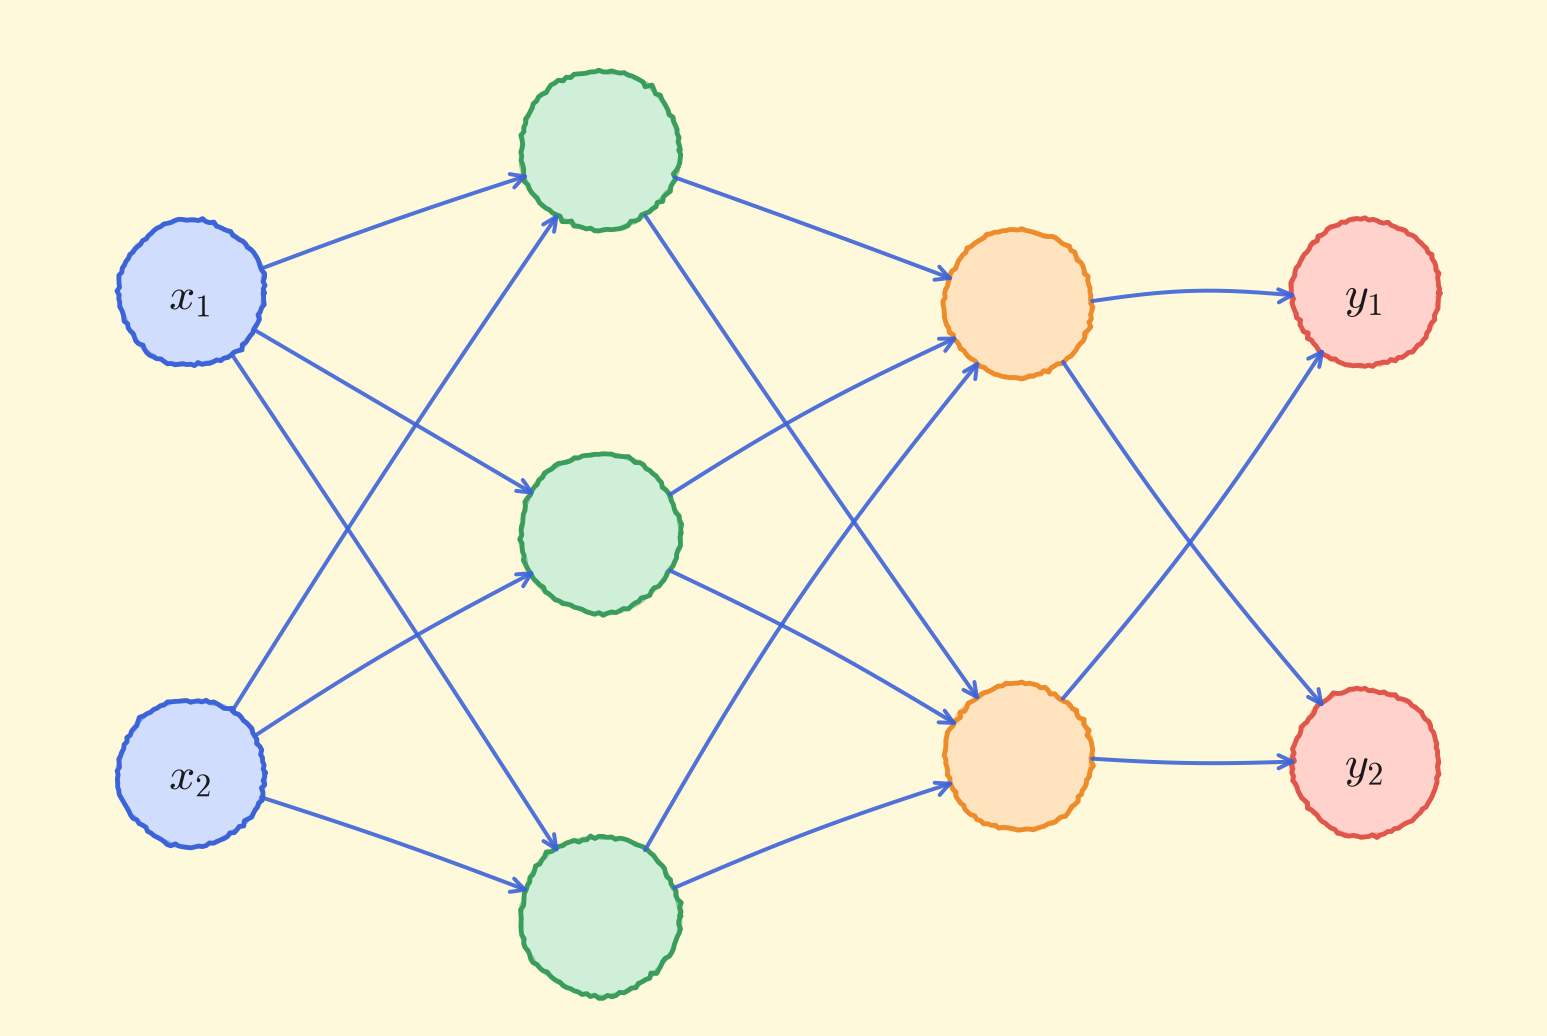
简单起见,我们的输入层(第0层)有2个神经元;第1个隐藏层(第1层)有3个神经元;第2个隐藏层(第2层)有2个神经元;输出层(第3层)有2个神经元。
# 1.2 各层之间的信号传递
上面只是三层网络的示意图,实际上每层还应该有偏置,各输入信号加权总和还要经过激活函数的处理。接下来逐层进行分析,考察信号在各层之间传递的过程。
# 1.2.1 输入层(第0层)→ 第1层
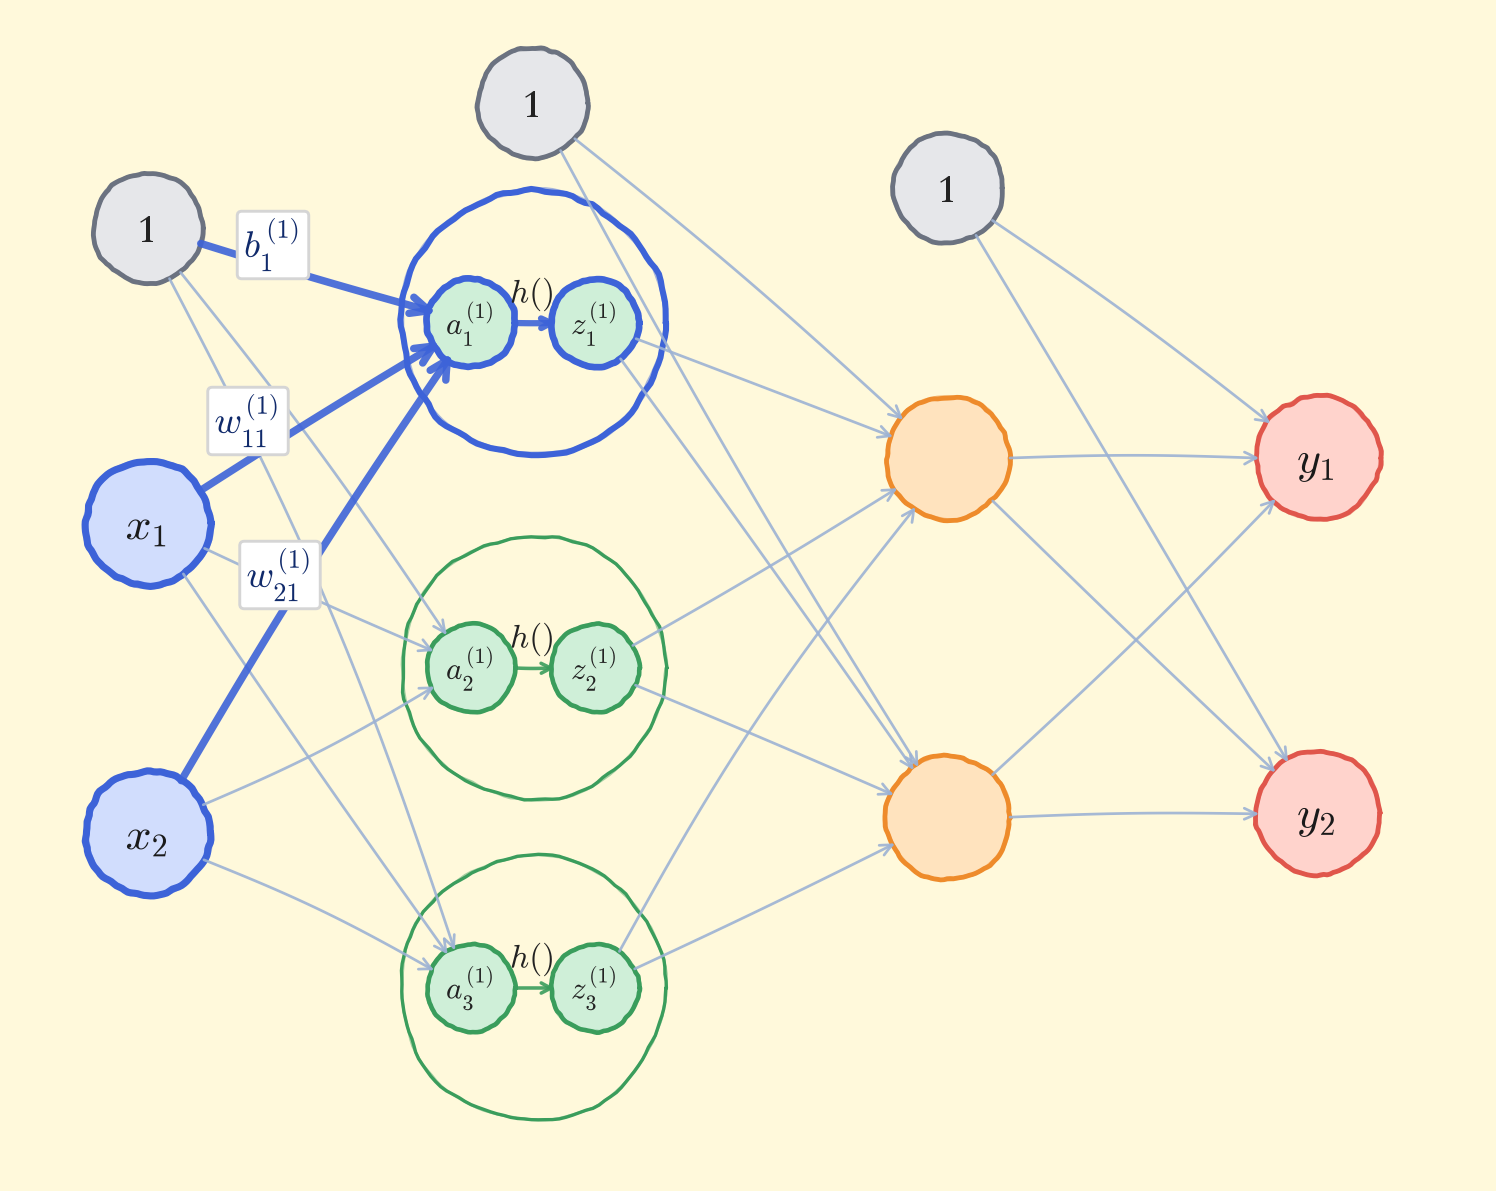
权重和神经元的上标(1)表示网络层号。而下标对于神经元来说,就是这一层内的"索引号";对于权重来说则包含两个数字,分别代表前一层和后一层神经元的索引号。所以,就表示这是第1层的权重(输入层到第1层),并且是从第2个输入节点到第1层第1个节点。偏置的下标只有1个,因为前一层的偏置节点只有一个。
所以,可以利用式(2.4)(2.5)得到:
(2.6)
(2.7)
同样,对于第1层的第2个、第3个神经元,有:
我们可以直接写成矩阵乘法的形式:
(2.8)
其中,
可以看到,由于有2个输入节点、3个第1层节点,所以全连接层的权重W就应该是一个2×3的矩阵。这样,我们就可以很容易地利用Numpy中的矩阵乘法计算出输出信号值了。
矩阵维度的记忆口诀:权重矩阵的形状永远是"前一层神经元数 × 后一层神经元数"。输入是1×2,权重是2×3,乘完加偏置就是1×3——维度对不上,矩阵乘法直接报错,所以维度检查也是写神经网络代码时最快的排错手段。
# 1.2.2 第1层 → 第2层
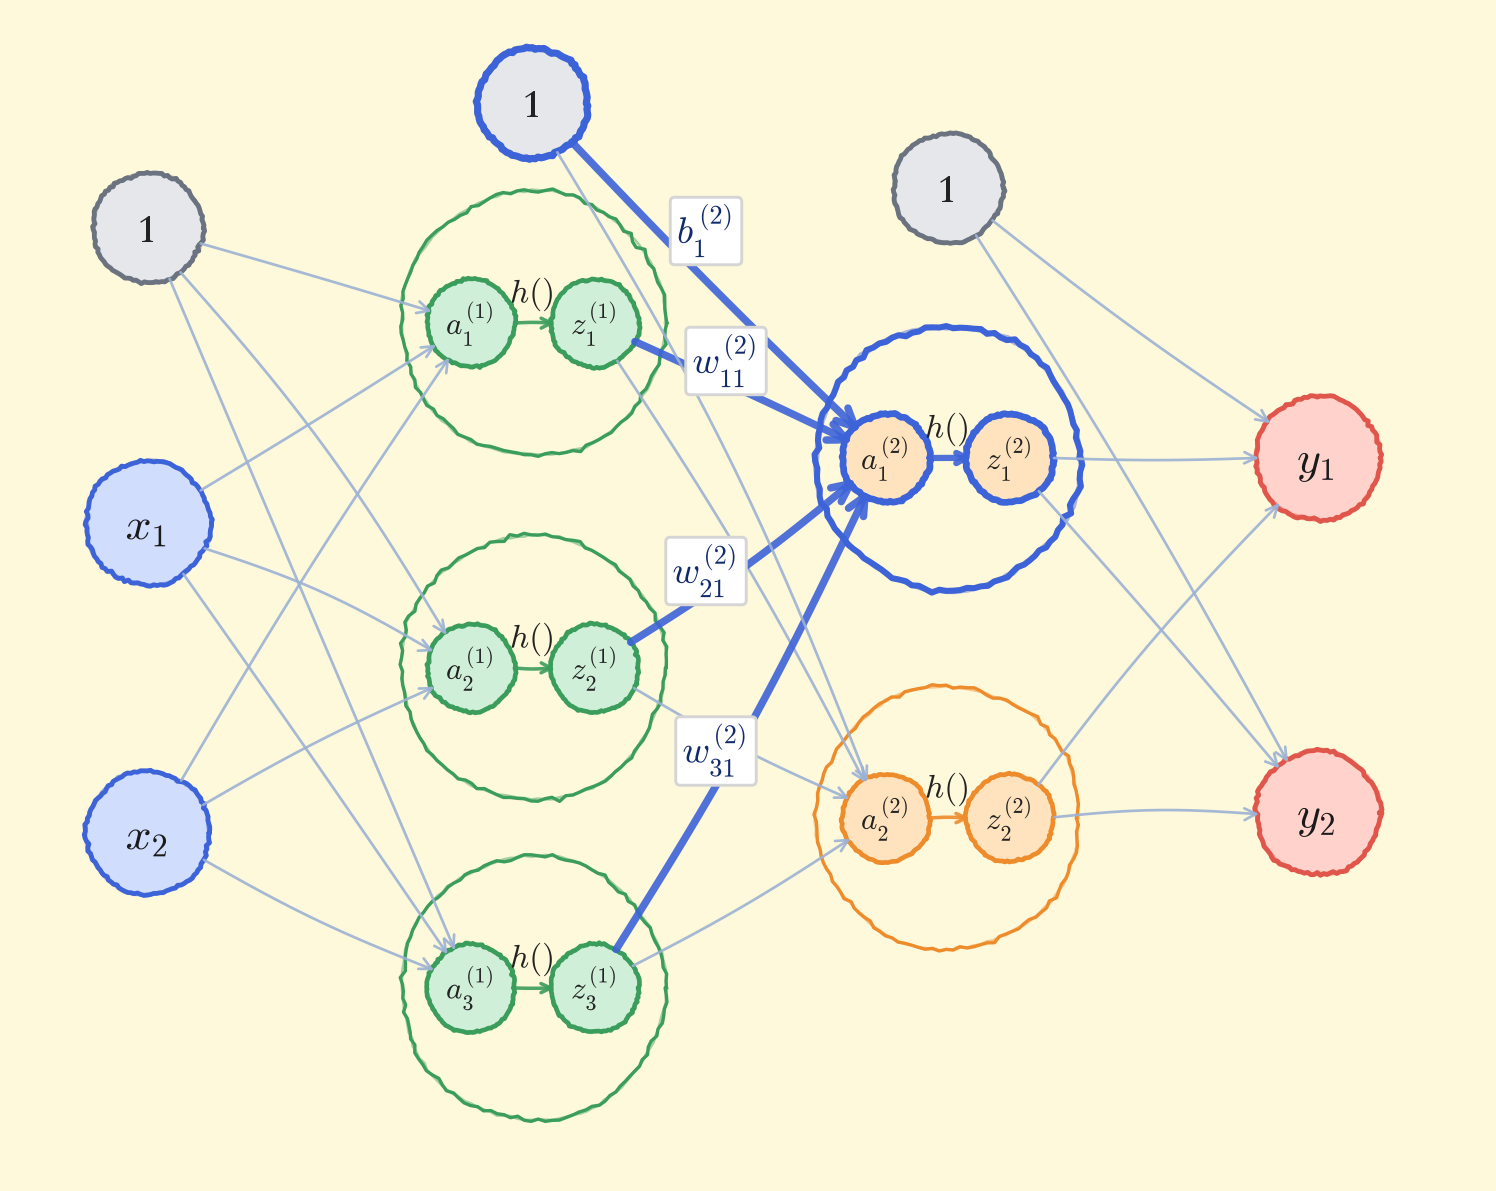
第1层到第2层的处理类似,权重参数应该是一个3×2的矩阵。
# 1.2.3 第2层 → 输出层(第3层)
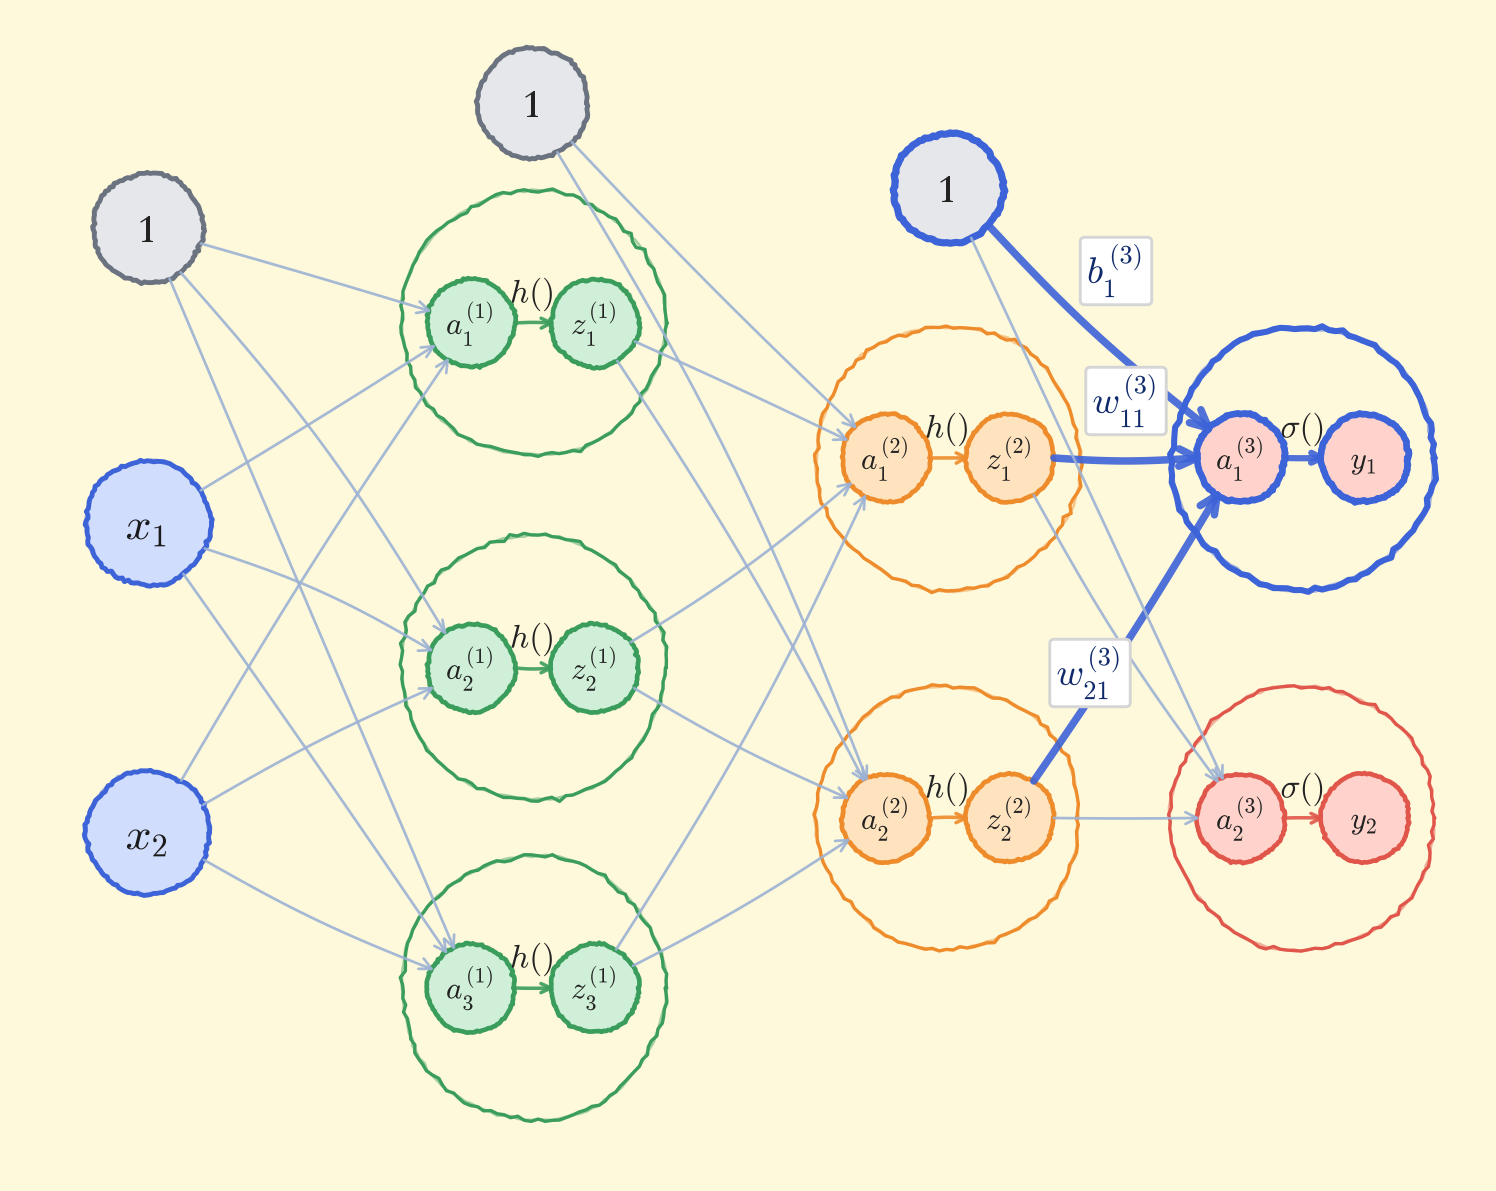
第2层到输出层的处理也类似,权重参数为2×2的矩阵;不过输出层的激活函数一般与隐藏层是不同的,这里用表示。
# 1.3 代码实现
我们可以将神经网络的所有参数(每一层的权重w和偏置b),保存在一个字典network中;并定义函数:
- init_network():对参数进行初始化,每一个权重参数都是一个矩阵(二维),每一个偏置参数则是一个数组(一维);
- forward():前向传播,将输入信号转换为输出信号的处理操作。
这里的激活函数,隐藏层用sigmoid,输出层用identity(恒等函数)。
具体代码如下(书中是从common.functions导入sigmoid和identity_function,这里直接给出等价实现,保证代码可独立运行):
import numpy as np

# 书中实现:from common.functions import sigmoid, identity_function
def sigmoid(x):
    return 1 / (1 + np.exp(-x))

def identity_function(x):
    return x

def init_network():
    network = {}
    network['W1'] = np.array([[0.1, 0.3, 0.5], [0.2, 0.4, 0.6]])
    network['b1'] = np.array([0.1, 0.2, 0.3])
    network['W2'] = np.array([[0.1, 0.4], [0.2, 0.5], [0.3, 0.6]])
    network['b2'] = np.array([0.1, 0.2])
    network['W3'] = np.array([[0.1, 0.3], [0.2, 0.4]])
    network['b3'] = np.array([0.1, 0.2])

    return network

def forward(network, x):
    w1, w2, w3 = network['W1'], network['W2'], network['W3']
    b1, b2, b3 = network['b1'], network['b2'], network['b3']

    a1 = np.dot(x, w1) + b1   # 1×2 @ 2×3 -> 1×3
    z1 = sigmoid(a1)
    a2 = np.dot(z1, w2) + b2  # 1×3 @ 3×2 -> 1×2
    z2 = sigmoid(a2)
    a3 = np.dot(z2, w3) + b3  # 1×2 @ 2×2 -> 1×2
    y = identity_function(a3)

    return y

network = init_network()
x = np.array([1.0, 0.5])
y = forward(network, x)

print(y)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
[0.31682708 0.69627909]
每一行np.dot对应一节信号传递:加权求和→激活→交给下一层。三次矩阵乘法,前向传播就走完了。
# 1.4 应用案例:手写数字识别
我们依然使用Digit Recognizer数据集来进行手写数字识别:https://www.kaggle.com/competitions/digit-recognizer (opens new window)。
文件train.csv中包含手绘数字(从0到9)的灰度图像,每张图像为28×28像素,共784像素。每个像素有一个0到255的值表示该像素的亮度。
文件第1列为标签,之后784列分别为784个像素的亮度值。
我们的任务,就是要搭建一个神经网络,实现它的前向传播;也就是要根据输入的数据(28×28 = 784数据点表示的图像),推断出它到底是哪个数字,这个过程也被称为"推理"。
这里,我们构建的也是一个三层神经网络,输入层应该有784个神经元,输出层有10个神经元(表示0~9的分类结果);中间设置2个隐藏层,第一个隐藏层有50个神经元,第二个隐藏层有100个神经元。这里的参数是需要学习得到的;我们假设已经学习完毕,直接从保存好的权重文件中读取即可。
权重文件从哪来? 这个文件不是sklearn自带的,而是教材官方提供的预训练权重
sample_weight.pkl(本质是一个pickle字典,内含W1/b1/W2/b2/W3/b3六个数组)。到教材配套仓库下载并放到data/目录即可: https://raw.githubusercontent.com/oreilly-japan/deep-learning-from-scratch/master/ch03/sample_weight.pkl (opens new window)也可以用浏览器打开仓库页面https://github.com/oreilly-japan/deep-learning-from-scratch/blob/master/ch03/sample_weight.pkl (opens new window)点"Download raw file"。注意该权重的输入维度是784,只适用于Kaggle的28×28数据;只用内置8×8数字集(64维)时推理会自动跳过——64维的完整训练流程在Day18实现。
对照1.3节的小网络看矩阵维度,套路完全一致:
| 信号传递 | 计算 | 维度变化 |
|---|---|---|
| 输入层 → 隐藏层1 | x @ W1 + b1 | 784 → 50,W1是784×50 |
| 隐藏层1 → 隐藏层2 | z1 @ W2 + b2 | 50 → 100,W2是50×100 |
| 隐藏层2 → 输出层 | z2 @ W3 + b3 | 100 → 10,W3是100×10 |
和1.3节唯一的区别是输出层激活函数换成了softmax(多分类要输出概率分布),以及输入从单条向量变成了100条一个批次的矩阵(100×784 @ 784×50 = 100×50,批量推理一次算完)。
下面把数据加载、激活函数统一定义好(Day18训练时直接复用,不再重复定义)。load_data()负责加载、归一化、切分并返回训练/测试四份数据;有Kaggle的train.csv就读784维数据,没有则自动回退到sklearn内置的8×8手写数字集(64维),代码无需改动。推理阶段只用到测试集,训练集先留着:
import os
import pickle
import numpy as np
import pandas as pd
import joblib
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import MinMaxScaler

# 书中实现: from common.functions import sigmoid, softmax
def sigmoid(x):
    return 1 / (1 + np.exp(-x))

def softmax(a):
    c = np.max(a, axis=-1, keepdims=True)  # 减最大值防止exp溢出, 支持批量输入
    exp_a = np.exp(a - c)
    return exp_a / np.sum(exp_a, axis=-1, keepdims=True)

def load_data():
    """加载 -> 7:3分层切分 -> 只用训练集fit归一化, 返回 x_train, x_test, y_train, y_test"""
    if os.path.exists("../data/train.csv"):       # Kaggle: 28×28=784维
        data = pd.read_csv("../data/train.csv")
        X_raw, y_raw = data.drop("label", axis=1).values, data["label"].values
    else:                                          # 离线兜底: 8×8=64维
        from sklearn.datasets import load_digits
        digits = load_digits()
        X_raw, y_raw = digits.data, digits.target
    # 先切分, 再归一化: 防止测试集的统计量(最大/最小值)泄露进训练过程
    x_train, x_test, y_train, y_test = train_test_split(
        X_raw, y_raw, test_size=0.3, random_state=42, stratify=y_raw)
    scaler = MinMaxScaler()                        # 归一化参数只从训练集学
    x_train = scaler.fit_transform(x_train)
    x_test = scaler.transform(x_test)             # 测试集只transform, 不fit
    return x_train, x_test, y_train, y_test

def init_network():
    # 兼容两种预训练权重: 自己的joblib文件, 或教材官方的sample_weight.pkl
    if os.path.exists("../data/nn_sample"):
        return joblib.load("../data/nn_sample")
    with open("../data/sample_weight.pkl", "rb") as f:
        return pickle.load(f)

def predict(network, x):
    w1, w2, w3 = network['W1'], network['W2'], network['W3']
    b1, b2, b3 = network['b1'], network['b2'], network['b3']

    a1 = np.dot(x, w1) + b1
    z1 = sigmoid(a1)
    a2 = np.dot(z1, w2) + b2
    z2 = sigmoid(a2)
    a3 = np.dot(z2, w3) + b3
    return softmax(a3)

# 推理只需要测试集; x_train/y_train 先留着, Day18训练时会用到
x_train, x_test, y_train, y_test = load_data()

weight_path = "../data/nn_sample" if os.path.exists("../data/nn_sample") else \
              "../data/sample_weight.pkl" if os.path.exists("../data/sample_weight.pkl") else None

if weight_path is None:                          # 两个权重文件都没有
    print("未找到预训练权重(nn_sample 或 sample_weight.pkl), 跳过推理。")
    print("下载地址见本节说明; 或直接学Day18, 用反向传播自己训练一份。")
elif x_test.shape[1] != 784:                     # 权重只认784维输入
    print(f"预训练权重要求784维输入, 当前数据是{x_test.shape[1]}维(内置digits), 跳过推理。")
else:
    network = init_network()
    batch_size, accuracy_cnt = 100, 0
    for i in range(0, len(x_test), batch_size):
        x_batch = x_test[i:i+batch_size]              # 100×784
        y_batch = predict(network, x_batch)          # 100×10
        p = np.argmax(y_batch, axis=1)               # 概率最大的下标即预测类别
        accuracy_cnt += np.sum(p == y_test[i:i+batch_size])
    print("Accuracy:" + str(float(accuracy_cnt) / len(x_test)))
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
几个细节值得留意:
- 归一化只fit训练集:
fit_transform只用在训练集上,测试集仅transform,这和Day13讲的"防止数据泄露"是同一个规矩。 - 批量推理:for循环每次取100条组成一个批次,矩阵乘法一次性算完100×784 @ 784×50,比逐条循环快得多——这就是GPU时代神经网络的标准玩法(Day18训练时同样按小批量喂数据)。
- 输出层用softmax:隐藏层仍然用sigmoid,输出层换成softmax把10个输出压成概率分布,
np.argmax取概率最大的下标就是预测的数字。
# 1.5 损失函数:模型学习的指南针
神经网络需要以某个指标为线索来寻找最优权重参数,这个指标就是损失函数。损失函数的值越小,代表当前参数越适合训练数据。常见损失函数按任务类型分为三大类:回归损失、分类损失和通用损失。
# 1.5.1 均方误差(MSE/L2 Loss)
均方误差(Mean Squared Error, MSE),也称L2 Loss,是回归任务和最基础的神经网络训练中最常用的损失函数之一:
其中表示神经网络的输出,表示监督数据的标签(正确的解标签),是数据的维度。对于固定维度的网络,前面的系数有时不重要,公式也可以写成:
这个系数是为了求导时和平方项的2约掉,让梯度表达式更简洁。L2 Loss有一个明显特点:对异常值敏感,遇到离群点时误差会被平方放大,容易导致梯度爆炸。
代码实现如下:
import numpy as np

def mean_squared_error(y, t):
    return 0.5 * np.sum((y - t)**2)

# 验证:预测与标签越接近,损失越小
y = np.array([0.1, 0.2, 0.7])
t = np.array([0, 0, 1])
print("接近标签时的MSE:", mean_squared_error(y, t))

y_far = np.array([0.5, 0.3, 0.2])
print("远离标签时的MSE:", mean_squared_error(y_far, t))
2
3
4
5
6
7
8
9
10
11
12
接近标签时的MSE: 0.04500000000000001
远离标签时的MSE: 0.385
2
# 1.5.2 交叉熵误差
除了均方误差,交叉熵误差(Cross Entropy Error)也经常被用作损失函数,尤其在分类任务中比MSE更常用:
其中表示自然对数,表示神经网络的输出(通常经过softmax后表示概率),表示正确解标签。在one-hot表示中,只有正确解标签对应的值为1,其它均为0。这意味着交叉熵实际上只关心模型对正确类别的预测概率:概率越接近1,损失越接近0;概率越接近0,损失趋向无穷大。
代码实现如下:
def cross_entropy_error(y, t):
    if y.ndim == 1:
        t = t.reshape(1, t.size)
        y = y.reshape(1, y.size)

    # 监督数据是one-hot向量的情况下,转换为正确解标签的索引
    if t.size == y.size:
        t = t.argmax(axis=1)

    batch_size = y.shape[0]
    return -np.sum(np.log(y[np.arange(batch_size), t] + 1e-7)) / batch_size

# 验证:batch_size=1,正确类别索引为2
y = np.array([[0.1, 0.2, 0.7]])
t = np.array([[0, 0, 1]])
print("交叉熵损失:", cross_entropy_error(y, t))

# 如果预测概率很低
y_low = np.array([[0.5, 0.4, 0.1]])
print("预测错误时的交叉熵:", cross_entropy_error(y_low, t))
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
交叉熵损失: 0.35667494393873245
预测错误时的交叉熵: 2.302585092994046
2
# 1.6 分类任务损失函数
分类任务是深度学习最常见的场景之一。按类别数量可分为二分类和多分类,两者的损失函数形式略有不同。
# 1.6.1 二分类任务:二元交叉熵(Binary Cross-Entropy)
二分类任务常用二元交叉熵损失函数(Binary Cross-Entropy Loss)。模型输出一个概率值,表示样本属于正类(标签为1)的概率:
其中:
- 为真实值,通常为0或1
- 为预测值,表示样本为1的概率
这个公式的直觉很清晰:当时,损失变成,模型越确信是正类(概率接近1),损失越小;当时,损失变成,模型越确信是负类,损失越小。
# 1.6.2 多分类任务:多类交叉熵(Categorical Cross-Entropy)
多分类任务常用多类交叉熵损失函数(Categorical Cross-Entropy Loss)。它是对每个类别的预测概率与真实标签之间差异的加权平均:
其中:
- 是类别数
- 为真实值,表示是否为类别,通常为0或1
- 为预测值,表示样本为类别的概率
由于one-hot标签中只有正确类别为1,其余为0,上式实际上只累加了正确类别对应的项。这和1.1.2节的交叉熵误差是同一回事,只是这里更明确地写出了多类别求和的形式。
# 1.7 回归任务损失函数
回归任务预测连续值,不同的损失函数对异常值的容忍度和梯度特性不同,适用于不同场景。
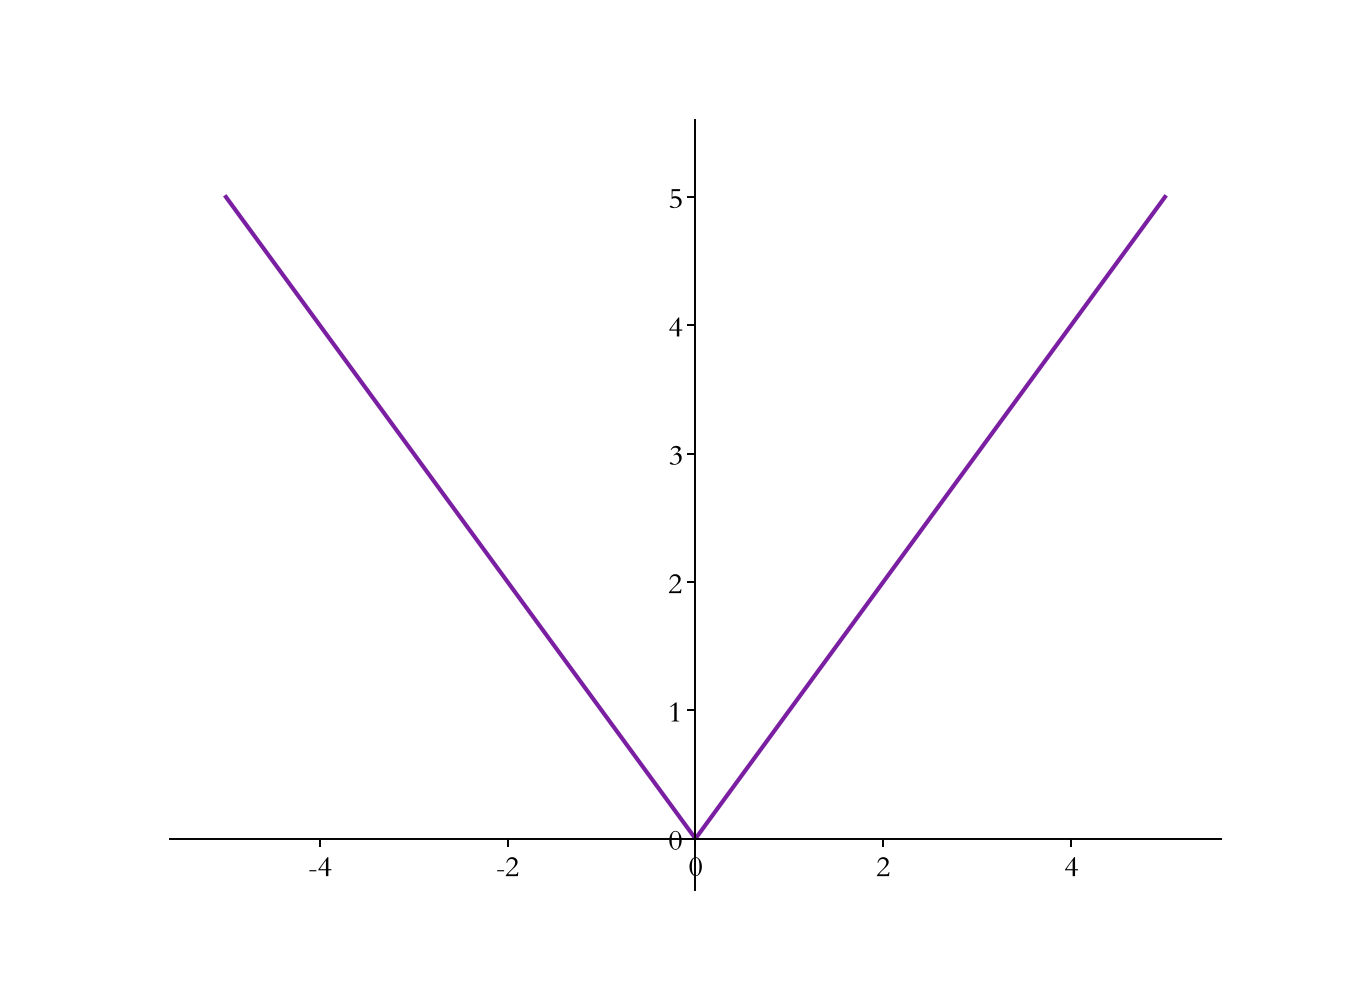
# 1.7.1 MAE/L1 Loss
平均绝对误差(Mean Absolute Error, MAE),也称L1 Loss:
L1 Loss对异常值鲁棒,因为误差是线性增长而非平方增长。但它在0点处不可导,优化时需要用次梯度或平滑近似。
# 1.7.2 MSE/L2 Loss
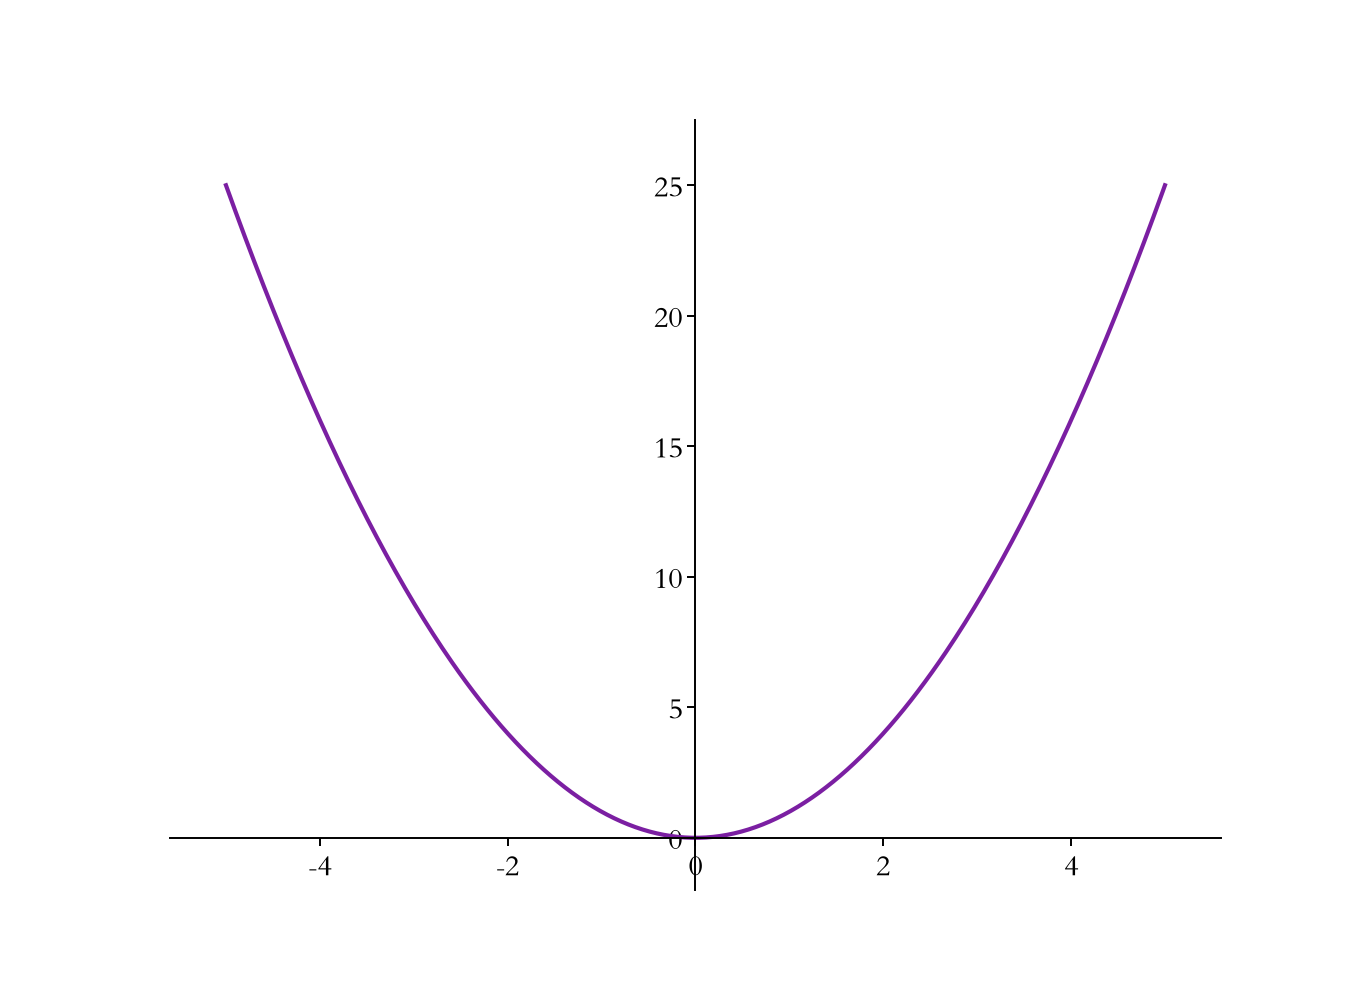
均方误差(Mean Squared Error, MSE),也称L2 Loss:
L2 Loss对异常值敏感,遇到异常值时易发生梯度爆炸。优点是处处可导,优化稳定。这与1.1.1节的MSE是同一个公式,只是在回归语境下重新强调它的特性。
# 1.7.3 Smooth L1 Loss
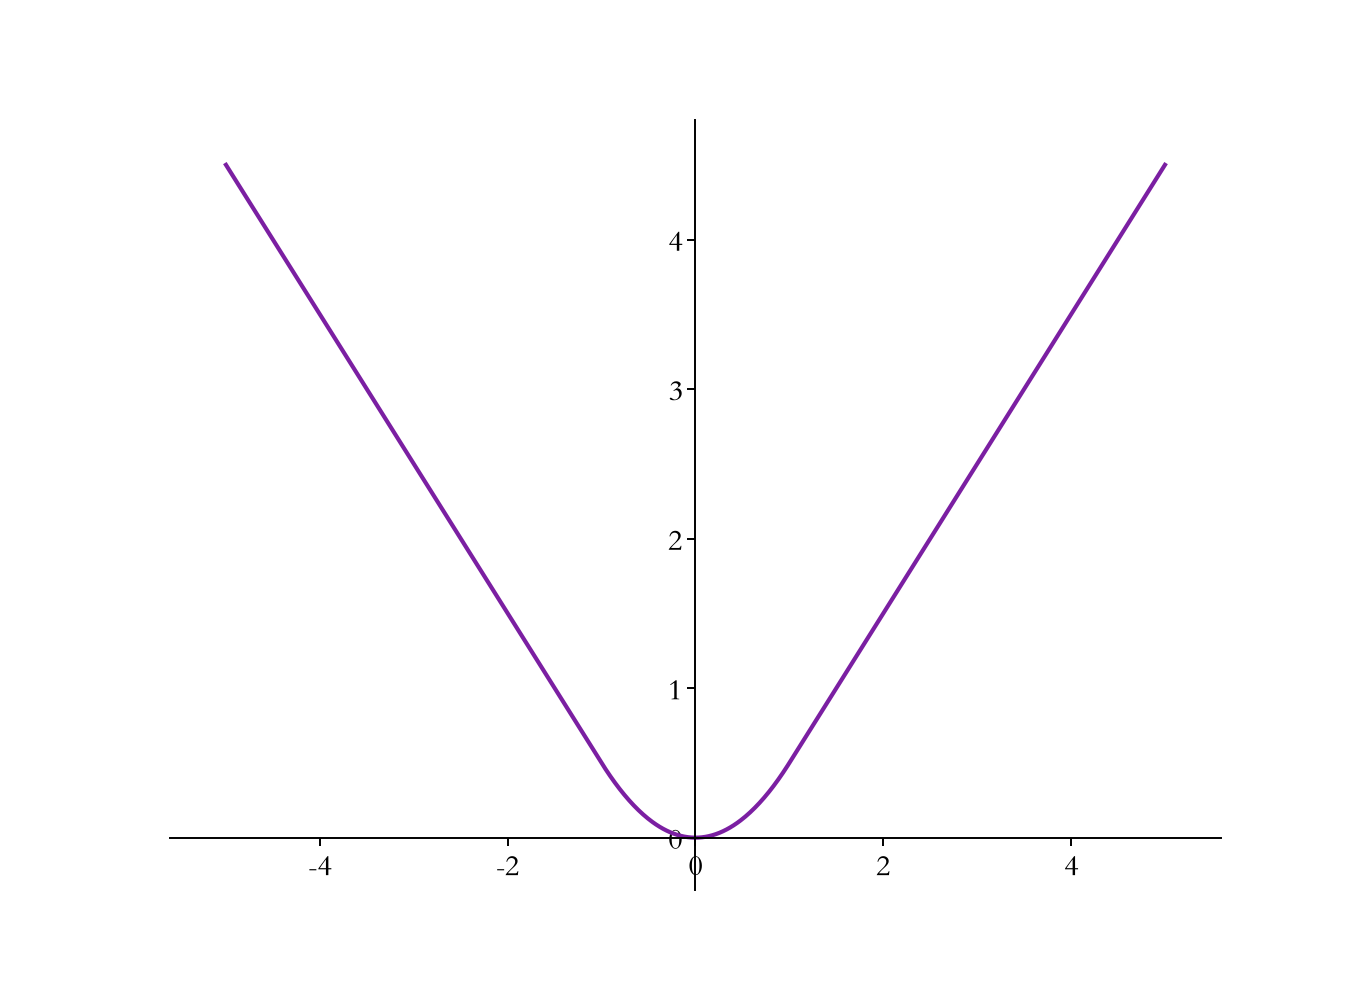
Smooth L1 Loss(也叫Huber Loss的一种形式)结合了L1和L2的优点:
当误差较小()时使用L2 Loss,使得损失函数平滑可导;当误差较大()时使用L1 Loss降低异常值的影响。这个设计让损失在0附近像抛物线(梯度连续),在远处像直线(梯度不爆炸),是目标检测等任务中的标配损失函数。
何时用哪个损失函数? 从任务和数据两个维度选:
- 分类任务:首选交叉熵(二分类用BCE,多分类用CCE)。交叉熵的梯度在预测错误时更大,训练初期收敛更快;而MSE在分类任务中梯度信号弱,容易导致学习缓慢。
- 回归任务,数据干净:用MSE/L2,优化稳定、收敛快。
- 回归任务,有异常值:用MAE/L1,对离群点不敏感。
- 回归任务,既要稳定又要抗异常值:用Smooth L1,兼顾两者优点。目标检测的边界框回归几乎都用它。
# 1.8 数值微分:梯度的度量衡
损失函数的值越小,代表选取的参数越适合。想要求得损失函数的最小值,最基本的想法就是对函数求导,解出导数值为0的点,并判断它是否为极小值或最小值。
然而,实际的神经网络损失函数极其复杂,直接求导不容易得到解析解。这时可以用数值微分的方式来求某点处的导数,这在工程上应用非常广泛。
# 1.8.1 导数的定义与数值微分
在数学上,导数被定义为:
这个定义表达出了导数的本质:当发生一个微小的变化时,函数值也会发生变化;当趋近于0时,的"变化率"就是这一点的导数值。
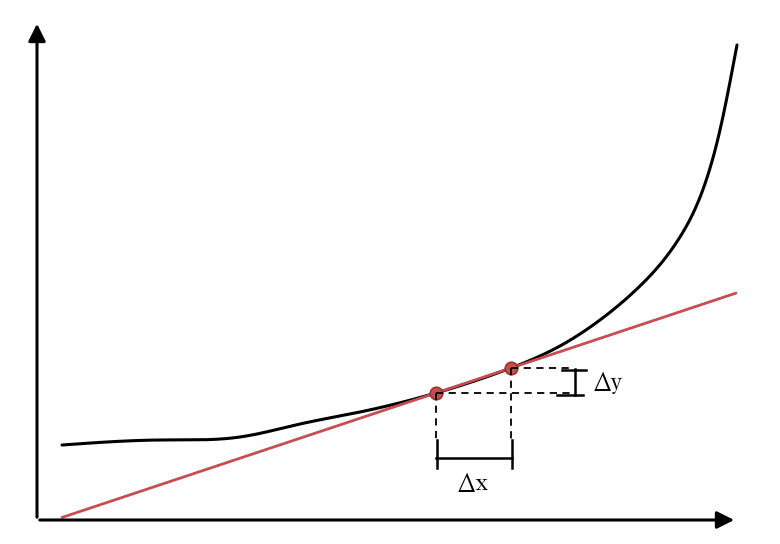
利用这个定义,可以直接以数值计算的方式,用微小的差分来求函数某点处的导数值,这种方法称为数值微分。
# 1.8.2 中心差分:更稳定的数值微分
数值微分可以用代码非常方便地实现。但直接用这种前向差分会有截断误差。更好的做法是以为中心,计算两边各发生微小变化后的差分:
这种方法称为中心差分。它通过对称采样抵消了一部分高阶误差,精度比单侧差分高一个数量级。另外,取微小值时不能太小,比如不能取,否则会导致计算机浮点数表示的精度不够,出现舍入误差。工程上通常取是一个安全且有效的选择。
代码实现如下:
def numerical_diff(f, x):
    h = 1e-4  # 微小值 0.0001
    return (f(x + h) - f(x - h)) / (2 * h)

# 验证:f(x) = x^2 的导数在 x=3 处应为 6
def f1(x):
    return x ** 2

print("f(x)=x^2 在 x=3 处的导数:", numerical_diff(f1, 3.0))

# 验证:f(x) = x^3 的导数在 x=2 处应为 12
def f2(x):
    return x ** 3

print("f(x)=x^3 在 x=2 处的导数:", numerical_diff(f2, 2.0))
2
3
4
5
6
7
8
9
10
11
12
13
14
15
f(x)=x^2 在 x=3 处的导数: 6.000000000039306
f(x)=x^3 在 x=2 处的导数: 12.000000000663693
2
误差在量级,对于工程计算完全够用。
# 1.8.3 偏导数
如果函数的自变量并非单个元素,而是多个元素,例如:
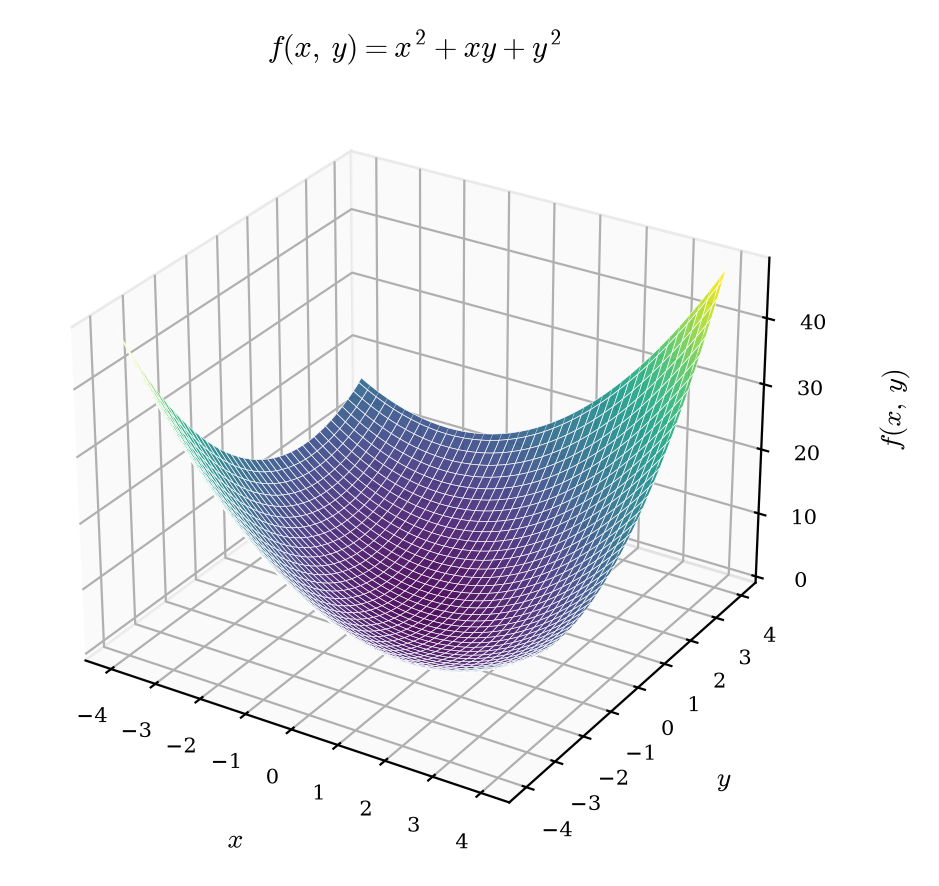
可将其中一个元素看作参数,此时可看作关于另一元素的函数。在固定的情况下,可计算关于的导数:
这种导数称为偏导数。更一般地,一个多元函数在点处对的偏导数定义为:
偏导数同样可以用数值微分来求:只改变一个自变量,其它保持不变,做差分考察函数值的变化率。
# 1.8.4 梯度
多元函数关于每个变量都有偏导数,在点处,这些偏导数定义了一个向量:
这个向量称为在点的梯度。例如在处的梯度为。
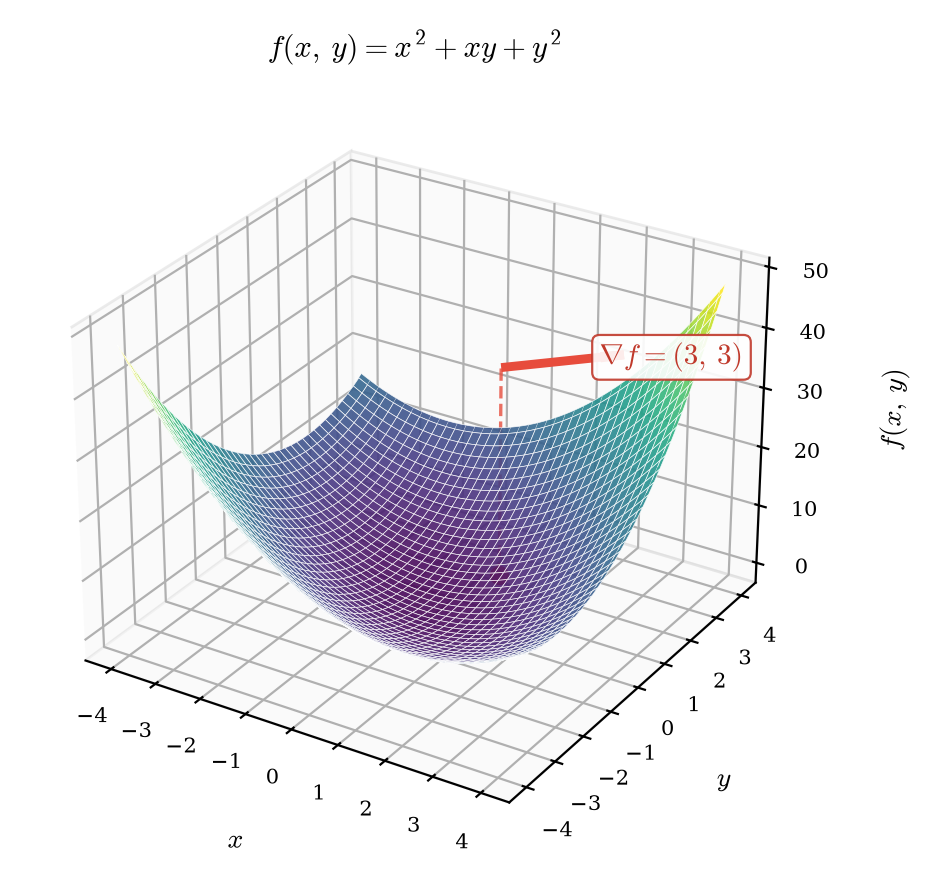
在函数的极小值、极大值和鞍点处,梯度为0。需要注意的是,梯度代表的其实是函数值增大最快的方向;在实际应用中,我们需要寻找损失函数的最小值,所以一般选择负梯度向量。负梯度代表的是函数值减小最快的方向,但它并不一定直接指向函数图像的最低点,只是局部最速下降方向。
利用数值微分,可以在代码中实现梯度的计算:
def numerical_gradient(f, x):
    h = 1e-4  # 0.0001
    grad = np.zeros_like(x)

    for idx in range(x.size):
        tmp_val = x[idx]
        x[idx] = float(tmp_val) + h
        fxh1 = f(x)  # f(x+h)

        x[idx] = tmp_val - h
        fxh2 = f(x)  # f(x-h)
        grad[idx] = (fxh1 - fxh2) / (2 * h)

        x[idx] = tmp_val  # 还原值

    return grad

# 验证:f(x, y) = x^2 + x*y + y^2 在 (1, 1) 处的梯度应为 [3, 3]
def f3(x):
    return x[0]**2 + x[0]*x[1] + x[1]**2

x = np.array([1.0, 1.0])
grad = numerical_gradient(f3, x)
print("f(x,y)=x^2+xy+y^2 在 (1,1) 处的梯度:", grad)

# 验证:f(x, y) = x^2 + y^2 在 (3, 4) 处的梯度应为 [6, 8]
def f4(x):
    return x[0]**2 + x[1]**2

x2 = np.array([3.0, 4.0])
grad2 = numerical_gradient(f4, x2)
print("f(x,y)=x^2+y^2 在 (3,4) 处的梯度:", grad2)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
f(x,y)=x^2+xy+y^2 在 (1,1) 处的梯度: [3. 3.]
f(x,y)=x^2+y^2 在 (3,4) 处的梯度: [6. 8.]
2
数值微分是理解梯度最直观的方式,但在实际训练深度神经网络时,参数数量动辄百万甚至上亿,对每个参数都做一次前向传播算差分,计算量是不可接受的。Day18会先用数值梯度驱动SGD把网络训起来,再用反向传播以链式法则把梯度计算从输出层倒推回输入层,将复杂度从"参数数量×前向传播"降到"与网络前向传播同量级",这是深度学习能够规模化训练的核心技术。
# 1.9 神经网络的梯度:损失函数关于权重的变化率
# 1.9.1 梯度的定义
在神经网络的学习中,梯度的计算非常重要。神经网络中的梯度,指的就是损失函数关于权重参数的梯度——它告诉我们:如果某个权重参数微调一点,损失函数会跟着变化多少。
为什么关心这个?因为训练的目标是让尽量小。梯度指向增长最快的方向,那么负梯度就指向减小最快的方向——这就是参数应该更新的方向。
# 1.9.2 一个2×3矩阵的具体例子
我们以一个单层的简单网络为例,形状为2×3,权重参数为,损失函数记为。那么它的权重参数和梯度为:
这里,梯度 也是一个2×3的矩阵,其中各个元素由关于中各元素的偏导数构成。换句话说:梯度的形状和权重的形状完全一致,每个位置都对应一个"这个参数该往哪调、调多少"的信号。
# 1.9.3 代码实现:数值梯度计算
计算这个简单网络的梯度,可以用代码实现如下。这里用的是数值梯度(numerical gradient)——不解析求导,而是用微小的扰动来近似:
import numpy as np

def softmax(x):
    """softmax函数,把 logits 转成概率分布"""
    if x.ndim == 2:
        x = x - x.max(axis=1, keepdims=True)
        x = np.exp(x)
        x /= x.sum(axis=1, keepdims=True)
        return x
    x = x - np.max(x)
    return np.exp(x) / np.sum(np.exp(x))

def cross_entropy_error(y, t):
    """交叉熵损失,y是预测概率,t是真实标签(one-hot)"""
    if y.ndim == 1:
        t = t.reshape(1, t.size)
        y = y.reshape(1, y.size)
    if t.size == y.size:
        t = t.argmax(axis=1)
    batch_size = y.shape[0]
    return -np.sum(np.log(y[np.arange(batch_size), t] + 1e-7)) / batch_size

def numerical_gradient(f, x):
    """数值梯度:用中心差分近似偏导数"""
    h = 1e-4  # 微小扰动
    grad = np.zeros_like(x)
    it = np.nditer(x, flags=['multi_index'], op_flags=['readwrite'])
    while not it.finished:
        idx = it.multi_index
        tmp_val = x[idx]
        x[idx] = float(tmp_val) + h
        fxh1 = f(x)  # f(x+h)
        x[idx] = float(tmp_val) - h
        fxh2 = f(x)  # f(x-h)
        grad[idx] = (fxh1 - fxh2) / (2 * h)
        x[idx] = tmp_val  # 恢复原值
        it.iternext()
    return grad

class simpleNet:
    """单层的简单网络:2输入 -> 3输出,无激活函数"""
    def __init__(self):
        np.random.seed(42)               # 固定种子, 保证文中输出可复现
        self.W = np.random.randn(2, 3)  # 随机初始化2×3权重

    def predict(self, x):
        return np.dot(x, self.W)

    def loss(self, x, t):
        z = self.predict(x)
        y = softmax(z)
        loss = cross_entropy_error(y, t)
        return loss

# 构造数据
x = np.array([0.6, 0.9])   # 输入:2维
t = np.array([0, 0, 1])    # 标签:one-hot,第3类

net = simpleNet()

# 定义损失函数关于W的包装(数值梯度需要一元函数)
f = lambda w: net.loss(x, t)
dW = numerical_gradient(f, net.W)

print("梯度 dL/dW:")
print(dW)
print("\n梯度形状:", dW.shape)  # 和W一样,也是(2, 3)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
梯度 dL/dW:
[[ 0.43933772  0.06173286 -0.50107059]
 [ 0.65900658  0.0925993  -0.75160588]]

梯度形状: (2, 3)
2
3
4
5
输出是一个2×3矩阵,每个元素表示:如果增加,大约增加。正值表示增大会让变大(应该减小),负值表示增大会让变小(应该增大)。梯度就是参数更新的导航图。
# 1.10 梯度下降法:沿着负梯度方向迭代优化
# 1.10.1 核心思想
梯度下降法(Gradient Descent)是一种用于最小化目标函数的迭代优化算法。核心是沿着目标函数(如损失函数)的负梯度方向逐步调整参数,从而逼近函数的最小值。梯度方向指示了函数增长最快的方向,因此负梯度方向是函数下降最快的方向。
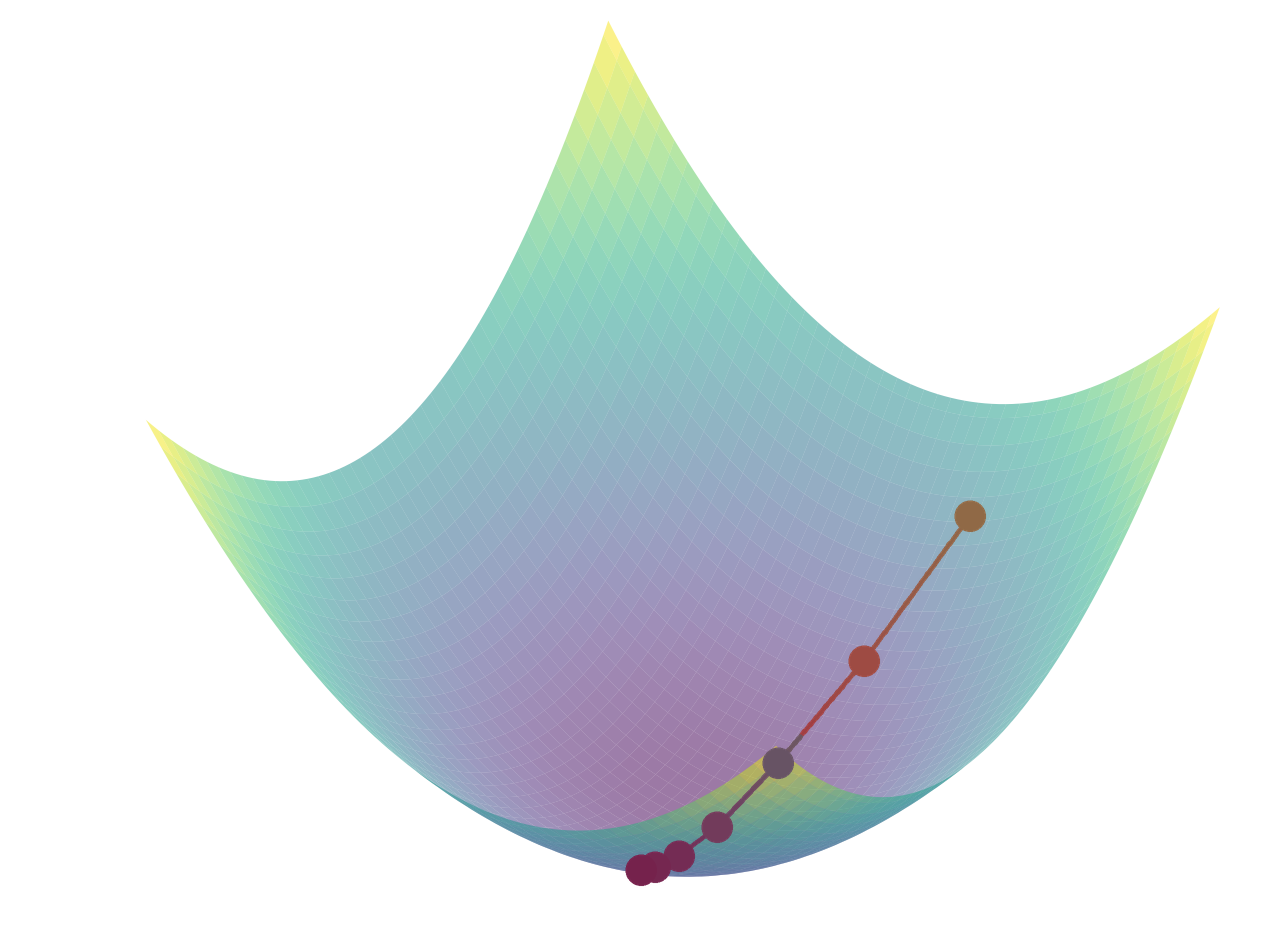
如图所示,初始点处的负梯度方向(箭头)指向函数值减小的方向。沿着这个方向走一小步,函数值就会下降;重复这个过程,就能一步步逼近谷底(极小值点)。
具体来说,我们初始找到函数的一个点,按下式进行更新:
这样就可以沿着负梯度方向,找到一个新的点,让函数值更小。
这里的表示每次的更新量,在神经网络的学习过程中,就代表了一次学习的步长(一次学习多少、多大程度去更新参数),称为 学习率(learning rate)。学习率需要预先设定好,过大或过小都会导致学习效果不佳:
- 过大:步子太大,可能跨过最小值,甚至发散
- 过小:步子太小,收敛太慢,训练时间爆炸
# 1.10.2 代码实现
梯度下降法可以代码实现如下:
import numpy as np

def numerical_gradient(f, x):
    """数值梯度(同上)"""
    h = 1e-4
    grad = np.zeros_like(x)
    it = np.nditer(x, flags=['multi_index'], op_flags=['readwrite'])
    while not it.finished:
        idx = it.multi_index
        tmp_val = x[idx]
        x[idx] = float(tmp_val) + h
        fxh1 = f(x)
        x[idx] = float(tmp_val) - h
        fxh2 = f(x)
        grad[idx] = (fxh1 - fxh2) / (2 * h)
        x[idx] = tmp_val
        it.iternext()
    return grad

def gradient_descent(f, init_x, lr=0.01, step_num=100):
    """
    梯度下降法
    f: 目标函数
    init_x: 初始点
    lr: 学习率
    step_num: 迭代次数
    """
    x = init_x
    x_history = []

    for i in range(step_num):
        x_history.append(x.copy())
        grad = numerical_gradient(f, x)
        x -= lr * grad  # 沿负梯度方向更新

    return x, np.array(x_history)

# 测试:求 f(x1, x2) = x1^2 + x2^2 的最小值
def function_2(x):
    return x[0]**2 + x[1]**2

init_x = np.array([-3.0, 4.0])  # 初始点(-3, 4)
x_final, x_history = gradient_descent(function_2, init_x, lr=0.1, step_num=100)

print("最终位置:", x_final)           # 应该接近(0, 0)
print("最终函数值:", function_2(x_final))  # 应该接近0
print("迭代次数:", len(x_history))
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
最终位置: [-6.11110793e-10  8.14814390e-10]
最终函数值: 1.03735763e-18
迭代次数: 100
2
3
从出发,经过100次迭代,最终停在,几乎就是原点——这正是的最小值点。梯度下降法用100次"算梯度→走一小步"的循环,完成了我们肉眼一看就知道答案的优化问题。
# 1.10.3 梯度与参数更新的关系
现在把1.1和1.2连起来:梯度计算是"看方向",梯度下降是"迈步子"。
- 1.5节的
numerical_gradient回答:在当前参数下,损失函数往哪个方向增长最快? - 1.6节的
gradient_descent回答:既然知道了方向,那参数应该怎么更新?
合起来就是神经网络训练的完整逻辑:
这个公式就是神经网络"学习"的数学表达——不是凭空变聪明,而是沿着负梯度方向,一小步一小步地调整参数,让损失函数值一点点降下来。
# 1.11 模型训练相关概念:Epoch、Batch Size、Iteration
# 1.11.1 Epoch
1个Epoch表示模型完整遍历一次整个训练数据集的过程。例如,训练10个Epoch表示模型将整个数据集反复学习10次。
模型需要多次遍历数据集(多个Epoch)才能逐步学习数据中的模式,单次遍历数据集(1个Epoch)通常不足以让模型收敛,多次遍历可以逐步优化模型参数。
# 1.11.2 Batch Size
Batch Size是每次训练时输入的样本数量。例如,Batch Size=32 表示每次用32个样本计算一次梯度并更新模型参数。
小批量数据计算梯度比单样本(Batch Size=1)更稳定,比全批量(Batch Size=全体数据)更高效。并且较小的Batch Size可能带来更多噪声,有助于模型泛化。
# 1.11.3 Iteration
一次Iteration表示**完成一个Batch数据的正向传播(预测)和反向传播(更新参数)**的过程。
例如,数据集现有2000个样本,对其训练10个Epoch,选择Batch Size=64:
- Batch个数为 个(最后一个Batch仅有16个样本)
- 每个Epoch中迭代次数 Iteration = 32次
- 总迭代次数为 次
- 总训练样本数为
这三个概念的关系可以总结为:Epoch是"轮",Iteration是"步",Batch Size是"每步吃多少数据"。
# 1.12 随机梯度下降法(SGD):从理论到实践
# 1.12.1 SGD的定义
在神经网络的学习过程中,可以使用梯度下降法来更新参数,目标就是减小损失函数的值。
但实际操作时有一个问题:如果数据集有100万条,每次算梯度都要遍历全部数据,计算量太大。于是人们想了个办法:从训练数据中随机选择一个小批量数据(mini-batch),然后用梯度下降法迭代多个轮次(iteration)。这种"对随机选择的数据进行的梯度下降法",被称作 随机梯度下降法(stochastic gradient descent, SGD)。
"随机"体现在每次迭代都随机抽一批数据;"梯度下降"体现在用这批数据算出的梯度来更新参数。SGD用少量数据的梯度近似全体数据的梯度,虽然每次的方向可能有噪声,但长期看仍然指向损失减小的方向——而且计算效率大大提高。
# 1.12.2 SGD的四个步骤
SGD的具体过程如下:
1) 随机选择批数据(mini-batch)
从训练数据中随机选出一部分数据,学习的目标就是要减少这个mini-batch数据的损失函数值。
2) 计算梯度
对当前的各权重参数,计算出梯度的值,负梯度就表示了损失函数减小最多的方向。
3) 更新参数
按照1.6节中梯度下降法的公式,对权重参数沿负梯度方向进行微小更新:
4) 重复迭代
重复上面的步骤1)2)3),直到完成预定的总迭代次数。
# 1.12.3 梯度计算与SGD的连接
现在可以回答开篇的问题了:计算机不会求导,但它会用数值方法近似梯度;计算机不会解方程,但它会用迭代方法逼近最优解。
- 梯度计算(1.5节)是SGD的第二步——告诉参数该往哪调
- 梯度下降(1.6节)是SGD的第三步——告诉参数调多少
- SGD(1.8节)把这两步包装成一个可执行的循环:抽数据→算梯度→更新参数→重复
没有梯度计算,SGD就不知道方向;没有梯度下降,梯度计算就只是纸上谈兵。两者结合,才让神经网络具备了"从数据中学习"的能力。
# 小结
今天把前向传播、损失函数、数值梯度和梯度下降串成了一条完整的概念链。但数值梯度太慢——网络一深就扛不住。Day18用反向传播算法把链式法则交给框架自动算,再解决深度网络的梯度消失、参数初始化和正则化问题。