
# 勤奋的凯尔森同学10000h刻意练习Day22:模型评估、可解释性与视觉应用 —— 混淆矩阵、Grad-CAM、混合精度到检测与分割
所属专栏: 凯尔森的10000h刻意练习
Slogan: 一个36岁程序员, 研究生(学硕),前世界500强top20软件开发Java工程师,用10000小时深耕AI, 目标Top10 AI资深工程师, 全程日更记录。
模型说"这是一只猫",可它到底看对了哪里、又在哪里栽了跟头?
Day21在CIFAR-10上训完了AlexNet、VGG和ResNet。今天换个视角:不只看准确率这一个数字,而用混淆矩阵看清"猫和狗为什么互相认错",用精确率和召回率从两个角度衡量。再把训练优化的工具箱补齐:学习率调度给训练加节拍器,混合精度省显存,TensorBoard给训练装行车记录仪。然后打开网络的黑盒:用特征图和Grad-CAM看见模型"目光落在哪里",用自编码器让网络自己学压缩,用消融实验验证初始化和BatchNorm的生死作用。最后从"图里有猫"跨入"猫在哪个框、哪些像素是猫"——物体检测的IoU/NMS/R-CNN/YOLO,把方框细化到像素的语义分割,以及亲手搭一个最小检测头,跑通"分类+回归"双头。
# 1.1 一个数字的谎言:为什么需要混淆矩阵
Day21的ResNet18在CIFAR-10测试集上拿到85.95%(这是本节混淆矩阵所用那次训练保存的权重成绩;Day21末节三家对比表报告的是另一次15轮运行、到90.24%,配置与轮数不同,那次训练的权重即Day21 1.18训练结束后写盘的cifar_resnet18.pt——直接加载它跑本节,数字会略高于85.95%,但矩阵的读法完全一样)。但如果你的产品是"识别猫的宠物门",这个数字毫无意义——你需要知道的是猫这一类的准确率。整体准确率是10000张测试图的平均值,它会把卡车的高分和猫的低分搅在一起。拆开它的工具就是混淆矩阵:一个10×10的表格,第行第列填的是"真实为第类、被预测成第类"的样本数。对角线是认对的,格子越亮越好;非对角线的亮格就是模型的"张冠李戴"。
用Day21训好的ResNet18权重(cifar_resnet18.pt,由Day21 1.18的训练块写盘),把10000张测试图的预测全部收上来,交给sklearn——若本地还没有这个文件,本节会打印提示并跳过,先回Day21 1.18跑一次ResNet18训练即可:
import os
import numpy as np
import torch, torch.nn as nn
from torchvision.models import resnet18
from sklearn.metrics import confusion_matrix, classification_report

def make_resnet18_cifar():
    model = resnet18(weights=None, num_classes=10)
    model.conv1 = nn.Conv2d(3, 64, 3, stride=1, padding=1, bias=False)
    model.maxpool = nn.Identity()
    return model

CKPT = "cifar_resnet18.pt"                     # 来自Day21 1.18的ResNet18训练
if not os.path.exists(CKPT):
    print(f"未找到{CKPT}: 请先运行Day21 1.18的ResNet18训练块"
          "(训练结束会把它存盘), 再回到本节; 本节跳过。")
else:
    model = make_resnet18_cifar()
    model.load_state_dict(torch.load(CKPT))
    model = model.to(device).eval()

    y_true, y_pred = [], []
    with torch.no_grad():
        for x, y in test_loader:
            y_pred.extend(model(x.to(device)).argmax(1).cpu().numpy())
            y_true.extend(y.numpy())

    cm = confusion_matrix(y_true, y_pred)          # 10x10混淆矩阵
    print(classification_report(y_true, y_pred, target_names=classes, digits=4))
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
# 1.2 猫和狗为什么互相认错:混淆矩阵逐格读
类别准确率(对角线/行和):
  airplane: 0.9490   automobile: 0.9560   bird: 0.7420   cat: 0.6900
  deer: 0.8240   dog: 0.8220   frog: 0.9350   horse: 0.8760
  ship: 0.8800   truck: 0.9210      总体: 0.8595
2
3
4
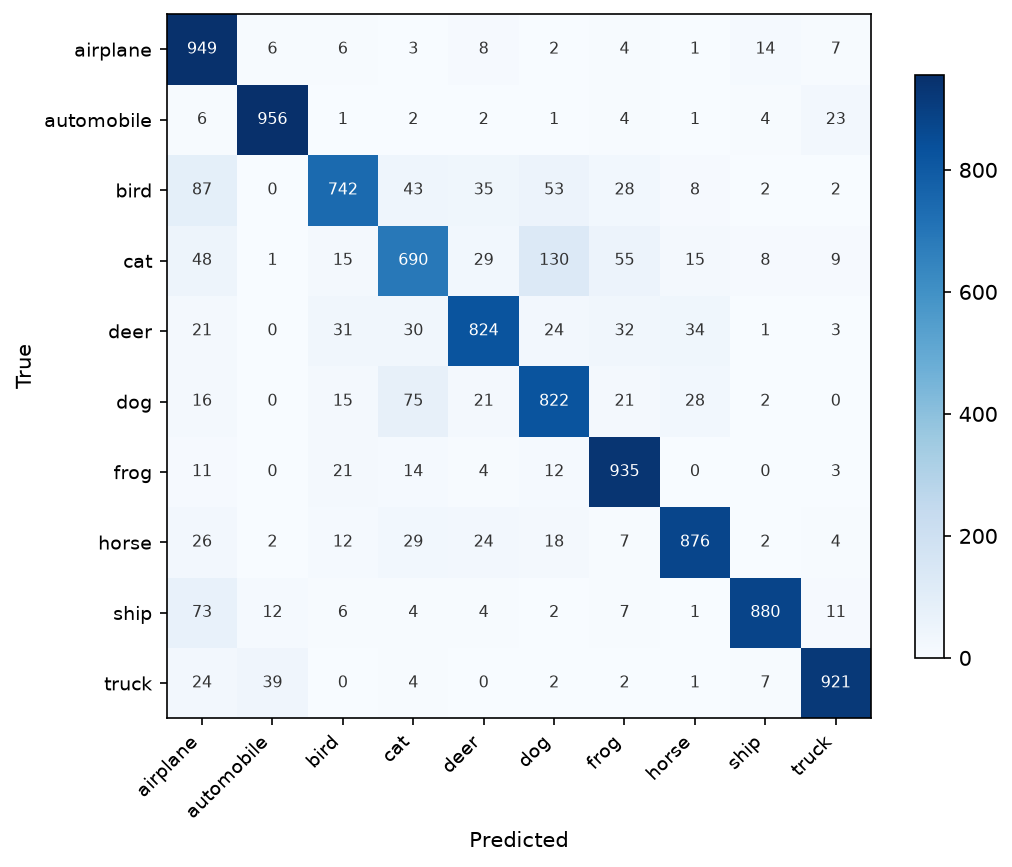
非对角线上最大的五处错误:
真cat  -> 预dog       130次
真bird -> 预airplane   87次
真dog  -> 预cat        75次
真ship -> 预airplane   73次
真cat  -> 预frog       55次
2
3
4
5
规律一眼可见:错误集中在视觉上相近的类对。猫狗互认(130+75次)是毛茸茸小动物的脸部相似;鸟被认成飞机(87次)是天空背景+翅膀/机翼的轮廓相似;船被认成飞机(73次)是海面上的船身与天空中的飞机都呈现"下亮上蓝"的构图。而卡车和汽车、马和鹿这些"人类觉得接近"的类对,反而因为轮廓差异大,混淆没有猫狗严重。这不是模型的bug,而是任务本身的贝叶斯上限——32×32的图,人眼辨认猫狗也只有九成出头。
# 1.3 精确率与召回率:同一件事的两个视角
classification_report给每个类别算三个指标,以"cat"为例:
- 精确率(precision)0.7718 = 预测为猫的样本里,真的是猫的比例。分母是"所有被模型说成猫的图"。它回答:"模型喊'猫'的时候,有多可信?"
- 召回率(recall)0.6900 = 真猫里被找出来的比例(就是混淆矩阵对角线的类别准确率)。它回答:"世上的猫,模型漏掉了多少?"
- F1 = 两者调和平均,谁太低就惩罚谁。
              precision    recall  f1-score   support
    airplane     0.7526    0.9490    0.8395      1000
  automobile     0.9409    0.9560    0.9484      1000
        bird     0.8740    0.7420    0.8026      1000
         cat     0.7718    0.6900    0.7286      1000
         deer     0.8665    0.8240    0.8447      1000
         dog     0.7711    0.8220    0.7957      1000
        frog     0.8539    0.9350    0.8926      1000
       horse     0.9078    0.8760    0.8916      1000
        ship     0.9565    0.8800    0.9167      1000
       truck     0.9369    0.9210    0.9289      1000
    accuracy                         0.8595     10000
2
3
4
5
6
7
8
9
10
11
12
最有意思的是airplane:精确率只有0.7526(全场最低),召回率却高达0.9490。这说明别的类经常被误判成飞机(鸟、船都在给它"注水"),而真飞机几乎从不漏网。这种不对称信息在整体准确率里完全看不见,但在实际业务里是关键:如果做机场鸟情预警,你要的是"鸟的高召回"(宁可错报不可漏报),该调的正是bird这一类的判决阈值。评估指标的选择,永远取决于错误方向的代价。
# 1.4 学习率调度:给训练加一个"由大到小"的节拍器
视角换一下:模型不动、数据不动、种子不动,只改学习率随时间的变化策略。调度器是PyTorch里最被低估的免费午餐——optim.lr_scheduler里的每个类都只需三行代码。今天用Day21的轻量CNN(142万参数)做对照实验,统一SGD(momentum=0.9, weight_decay=5e-4),基准lr=0.05,各训12个epoch:
import torch

def one_run(make_sched):
    torch.manual_seed(42)                    # 固定种子, 排除随机性
    model = SmallCNN().to(device)
    opt = torch.optim.SGD(model.parameters(), lr=0.05,
                          momentum=0.9, weight_decay=5e-4)
    sched = make_sched(opt)                  # 每种策略只差这一行
    for epoch in range(12):
        model.train()
        for x, y in train_loader:
            out = model(x.to(device))
            loss = nn.functional.cross_entropy(out, y.to(device))
            opt.zero_grad(); loss.backward(); opt.step()
            if isinstance(sched, torch.optim.lr_scheduler.OneCycleLR):
                sched.step()                 # OneCycle按step调度
        if sched is not None and not isinstance(sched, torch.optim.lr_scheduler.OneCycleLR):
            sched.step()                     # 其余按epoch调度
    return evaluate(model)

configs = {
    "固定lr=0.05": lambda o: None,
    "StepLR":  lambda o: torch.optim.lr_scheduler.StepLR(o, step_size=4, gamma=0.3),
    "Cosine":  lambda o: torch.optim.lr_scheduler.CosineAnnealingLR(o, T_max=12),
    "OneCycle": lambda o: torch.optim.lr_scheduler.OneCycleLR(
        o, max_lr=0.05, epochs=12, steps_per_epoch=len(train_loader)),
}
for name, fn in configs.items():
    print(name, one_run(fn))
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
四种策略的性格:
| 策略 | lr变化方式 | 一句话人格 |
|---|---|---|
| 固定lr | 始终0.05 | 用同一条船速横渡浅滩和深水 |
| StepLR | 每4个epoch lr×0.3 | 定点跳水, 阶梯下降 |
| Cosine | 从0.05沿余弦曲线滑到0 | 先快后慢, 平滑减速 |
| OneCycle | 先从低处爬升到峰值0.05再滑落 | 热身→冲刺→冷身 |
# 1.5 结果:8.6个百分点的免费午餐
固定lr=0.05:  ep11 test 0.7567 (中途在0.69~0.79之间剧烈震荡)
StepLR:       ep11 test 0.8164 (lr=0.05阶段0.71, 降到0.015后跳上0.76)
Cosine:       ep11 test 0.8374 (每个epoch稳定抬升, 无震荡)
OneCycle:     ep11 test 0.8425 (前3轮热身慢, 后程反超第一)
2
3
4
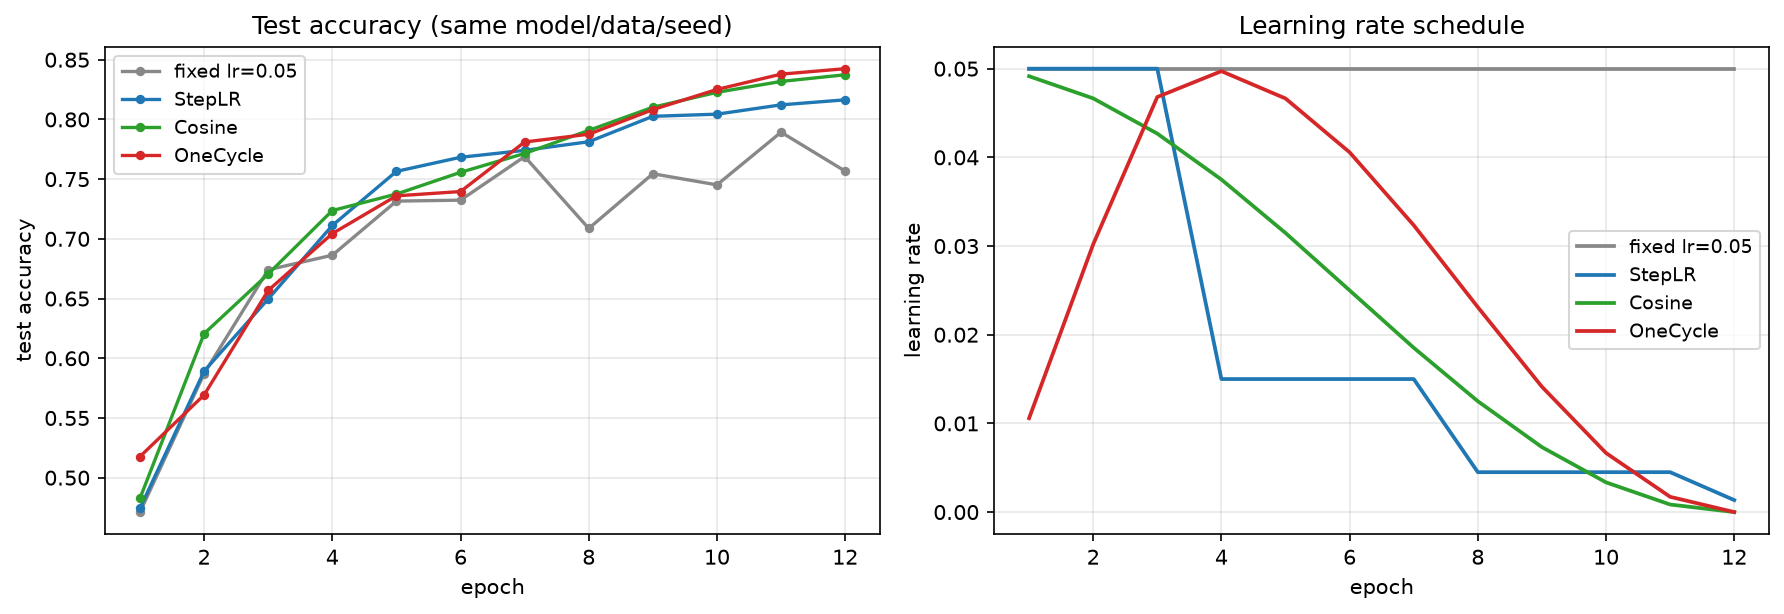
| 策略 | 最终测试准确率 | 相对固定lr提升 |
|---|---|---|
| 固定lr=0.05 | 0.7567 | — |
| StepLR(step=4, γ=0.3) | 0.8164 | +6.0pp |
| CosineAnnealing | 0.8374 | +8.1pp |
| OneCycle | 0.8425 | +8.6pp |
三个观察:
固定学习率的曲线像心电图。lr=0.05太大,参数在最优点附近来回弹跳,测试准确率0.7087↔0.7893反复横跳,训练结束时的0.7567甚至不是它自己的最高点(0.7893)。大lr前期探索得快,后期却始终无法"落袋"。
衰减的本质是"先探索后收敛"。StepLR在第4、8个epoch把lr砍到0.015、0.0045后,准确率各跳上一个台阶——小lr让参数安稳落进谷底。Cosine把这件事做得更平滑,没有人为选择"何时砍"的超参数,T_max设成总epoch数即可,这也是它成为现代默认配方的原因(Day21的ResNet18就是靠它)。
OneCycle的"热身"反直觉但有效。前3个epoch从0.01爬向0.05,准确率一度只有0.5177,看似落后;但大lr阶段跳出了糟糕的初始盆地,退火段下降路径更平,最终0.8425全场第一。它还额外送一个福利:不需要调初始lr,只调max_lr,超参搜索空间直接减半。
需要强调:今天只用12个epoch、142万参数的小模型放大差异。模型越大、训得越久,调度的收益越明显——LLM训练无一例外都带warmup+退火,就是这个结论的极致版。
# 1.6 混合精度:一半fp32一半fp16的"省字诀"
评估和调度都解决了,但训练本身还有两个工程痛点:fp32太慢太吃显存,loss散落在终端里没法对比。先解决速度问题。
神经网络权重默认用fp32(32位浮点)存储。但2017年以来的研究发现:前向/反向计算用fp16(半精度)完全够用,只需把少数敏感环节(权重更新、loss归约)留在fp32,就能既快又省——这就是混合精度训练(Automatic Mixed Precision, AMP):
- 为什么快:fp16数据量减半,现代GPU的Tensor Core对fp16矩阵乘有数倍吞吐;
- 为什么省:激活值占显存大头,fp16直接把显存砍半,意味着batch能开大一倍;
- 为什么不是全fp16:fp16只有5位指数,能表示的最小正数约6e-8,梯度(常见1e-8量级)会直接下溢成0;而参数更新
w += lr*g中,当lr*g相对w太小时(小于w末位的1/8192)会被舍入吞掉,小步更新等于没发生。
PyTorch把这两件事拆给两个工具:autocast负责"哪些算子用fp16"(前向自动选择),GradScaler负责"梯度下溢"(先把loss放大1024倍,反向后梯度也大1024倍,更新前再缩回来):
import torch

scaler = torch.cuda.amp.GradScaler()          # CUDA上的标准写法

for x, y in loader:
    x, y = x.to(device), y.to(device)
    with torch.autocast(device_type="cuda", dtype=torch.float16):
        out = model(x)                        # 卷积/矩阵乘自动走fp16
        loss = criterion(out, y)
    opt.zero_grad()
    scaler.scale(loss).backward()             # 放大loss再反向, 防梯度下溢
    scaler.step(opt)                          # 内部先unscale再step, 有inf则跳过本步
    scaler.update()                           # 根据是否出现inf动态调整放大系数
2
3
4
5
6
7
8
9
10
11
12
13
理解三行新代码:scale(loss)把损失乘上初值65536(旧版)或1024(新版)再反向,让微小梯度"坐电梯"离开下溢区;step()发现梯度里有inf/nan时会跳过本次更新并调低放大系数;update()在没有inf时逐步调高放大系数——它是一个自动平衡的控制器。
# 1.7 诚实实验:MPS上autocast到底快不快
我的训练设备是Apple M4,走的是MPS后端而非CUDA。文档说得再好不如亲手测:用Day21的VGG11(9.75M参数),batch 256,各计时30个训练步(预热5步,同步计时),对比fp32/fp16/bf16:
import time

def bench(amp_dtype, n_warm=5, n_iter=30):
    model = VGG(cfg_vgg11).to(device)
    opt = torch.optim.SGD(model.parameters(), lr=0.01, momentum=0.9)
    times = []
    for i in range(n_warm + n_iter):
        x, y = next(iter(train_loader))
        x, y = x.to(device), y.to(device)
        opt.zero_grad()
        t0 = time.time()
        if amp_dtype is not None:
            with torch.autocast("mps", dtype=amp_dtype):
                loss = nn.functional.cross_entropy(model(x), y)
        else:
            loss = nn.functional.cross_entropy(model(x), y)
        loss.backward(); opt.step()
        torch.mps.synchronize()               # MPS异步执行, 必须同步后再计时
        if i >= n_warm:
            times.append(time.time() - t0)
    return np.mean(times), np.std(times), torch.mps.current_allocated_memory() / 1e6
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
真实结果:
fp32:     101.8±0.5  ms/步
amp_fp16: 101.7±2.1  ms/步   提速比 1.001x
amp_bf16: 113.2±1.5  ms/步   提速比 0.9x(反而慢10%)
2
3
再用完整的2个epoch验证数值正确性(loss与测试准确率都应正常):
fp32:     ep0 loss 1.4705 test 0.5804 (24.1s) -> ep1 loss 0.9505 test 0.6781
amp_fp16: ep0 loss 1.4704 test 0.5916 (24.4s) -> ep1 loss 0.9449 test 0.7059
2
结论要如实说:在MPS后端上,fp16 autocast目前没有提速,数值上完全正确(loss曲线与fp32几乎重合,甚至2个epoch的测试acc还略高),bf16反而更慢。原因在于Apple GPU的算力红利在矩阵乘的统一内存架构上,MPS对fp16算子的调度尚未优化到位;而autocast在CPU上同样不提速。fp16的1.5~3倍加速是CUDA+Tensor Core生态的红利——所以上面的代码我要给出两个版本:在N卡上(包括Colab/云GPU)用标准的三件套写法;在MPS上,autocast可以当"省显存开关"用,但不指望它快。
另外两个MPS实操细节:计时前必须torch.mps.synchronize()(MPS是异步提交,不同步测出来的是提交指令的时间);查看显存用torch.mps.current_allocated_memory()。GradScaler在MPS上是可用的,但由于fp16路径没有提速、且bfloat16指数位与fp32相同(8位,不会下溢),MPS上可以只autocast不scale;CUDA上fp16则必须配GradScaler,这是面试和工程里都常考的点。
# 1.8 bf16 vs fp16:一字之差,命运不同
| 格式 | 符号位 | 指数位 | 尾数位 | 数值范围 | 精度 |
|---|---|---|---|---|---|
| fp32 | 1 | 8 | 23 | ±3.4e38 | 高 |
| fp16 | 1 | 5 | 10 | ±65504 | 中, 易下溢 |
| bf16 | 1 | 8 | 7 | ±3.4e38 | 低, 但不会下溢 |
bf16(Brain Float 16, Google为TPU设计)把fp16的尾数位换成了指数位:动态范围与fp32完全一致,梯度永远不会下溢,因此用bf16可以完全不需要GradScaler;代价是精度低(只有7位尾数),但对神经网络来说这通常无关紧要。现代训练(如LLaMA)的默认选择就是bf16。今天的实验里bf16在MPS上反而慢10%,也说明该后端的bf16支持还很初级。
# 1.9 TensorBoard:给训练装行车记录仪
速度解决了,还剩可见性。print调参的三大痛点:关掉终端记录就没了;loss/acc/lr要自己拼;两次实验对比全靠肉眼。TensorBoard原是TensorFlow的可视化工具,PyTorch通过torch.utils.tensorboard.SummaryWriter原生支持。它做的事很简单:把标量、图片、模型图写进事件文件,浏览器里画成曲线。
from torch.utils.tensorboard import SummaryWriter

writer = SummaryWriter("runs/cifar_demo")      # 一个实验一个子目录

for epoch in range(3):
    train_one_epoch(model, loader, opt)        # 正常训练
    writer.add_scalar("loss/train", epoch_loss, epoch)
    writer.add_scalar("acc/train", epoch_acc, epoch)
    writer.add_scalar("lr", opt.param_groups[0]["lr"], epoch)

# 记录一批还原后的原图(前16张)
writer.add_images("cifar_batch", denorm_batch, 0)
# 记录模型计算图(结构化展示前向路径)
writer.add_graph(VGG(cfg_vgg11), torch.randn(1, 3, 32, 32))
writer.close()
2
3
4
5
6
7
8
9
10
11
12
13
14
15
在终端启动服务,浏览器打开http://localhost:6006:
tensorboard --logdir runs # logdir指向所有实验的父目录
TB demo 3个epoch的真实记录:
ep0 loss 1.4782 acc 0.4477
ep1 loss 0.9397 acc 0.6682
ep2 loss 0.7177 acc 0.7545
写入事件文件 events.out.tfevents... 66931字节
2
3
4
5
三个最有用的面板:SCALARS面板里,同一个tag的两条曲线会自动画在同一坐标系,run1与run2并排对比,前面那四条调度曲线用print画出来要费半天劲,用TensorBoard是免费的;IMAGES面板能看到喂给模型的增强后的图——如果发现增强把猫转成了奇怪的角度,loss降不下去的原因立刻就找到了;GRAPHS面板把add_graph记录的前向计算图渲染成可双击展开的层级结构,Dropout→Linear→ReLU的连接一目了然,调试"这个张量到底怎么流"时比print shape直观得多。
工程习惯建议:每个实验用"时间+关键字"命名目录(runs/0429_vgg11_onecycle),tag用分组/指标格式(loss/train与loss/val自动归入loss组)——三个月后回看时,这些目录名就是你的实验档案。
# 1.10 特征图可视化:卷积核的"视网膜"
一张32×32的RGB图进入卷积层后,输出的每个通道都是一张"激活图":亮的地方表示该位置的输入与这个卷积核的模式匹配。用Day21的ResNet18,选一张测试集里的猫,用forward hook截取第一层卷积的输出:
feats = {}
model.conv1.register_forward_hook(
    lambda mod, inp, out: feats.__setitem__("conv1", out.detach()))

with torch.no_grad():
    logits = model(x)                      # x: 一张猫图, 真标cat, 预测cat
fm = feats["conv1"][0]                     # (64, 32, 32): 64张激活图
print(fm.shape)

# 按平均激活强度挑出最活跃的8个通道
strength = fm.mean(dim=(1, 2))
top8 = torch.topk(strength, 8).indices     # [23, 6, 41, 2, 14, 48, 21, 47]
2
3
4
5
6
7
8
9
10
11
12
把8个最强通道的激活图归一化后拼在一起:
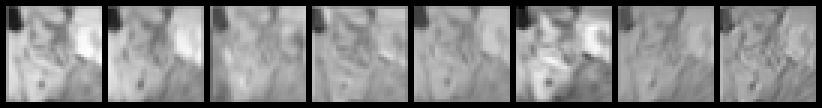
浅层卷积核学到的是低级视觉基元:有的通道对毛发边缘响应(猫身轮廓亮起),有的对特定朝向的色块响应,有的近乎全图均匀(亮度检测)。这与Hubel & Wiesel在1960年代发现猫视觉皮层V1区存在"边缘检测细胞"惊人地一致——卷积网络在数据驱动下自发重现了生物视觉的分工。注意不要把可视化神秘化:激活图亮≠"网络在看这里",它只是"这个核在这里匹配度高";想知道"网络凭哪里做决策",需要下一节的Grad-CAM。
# 1.11 Grad-CAM:模型的目光热点
Grad-CAM(Gradient-weighted Class Activation Mapping, 2017)回答的问题是:**模型把这个样本判为"猫",它依据的是图中哪片区域?**原理只有三步:
- 前向传播到目标卷积层(通常是最后一个,ResNet18的layer4输出4×4×512),把激活存下来;
- 对目标类别得分反向传播,得到每个通道的梯度,对空间维做全局平均得通道权重——梯度大说明该通道对"猫"这个判断贡献大;
- 加权求和再过ReLU:——只保留正向贡献,上采样回原图大小。
acts, grads = {}, {}
model.layer4[-1].register_forward_hook(
    lambda mod, i, o: acts.__setitem__("a", o.detach()))
model.layer4[-1].register_full_backward_hook(
    lambda mod, gi, go: grads.__setitem__("g", go[0].detach()))

model.zero_grad()
logits = model(x)
score = logits[0, pred]        # 目标类别的得分
score.backward()

A = acts["a"][0]               # (512, 4, 4)
G = grads["g"][0]              # (512, 4, 4)
w = G.mean(dim=(1, 2))         # (512,) 每个通道的权重
cam = torch.relu((w.view(-1, 1, 1) * A).sum(0))    # (4, 4)
cam = (cam - cam.min()) / (cam.max() - cam.min())
cam = nn.functional.interpolate(cam[None, None], size=(32, 32),
                                mode="bilinear", align_corners=False)[0, 0]
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
对这张猫图运行,预测类别是cat(正确):
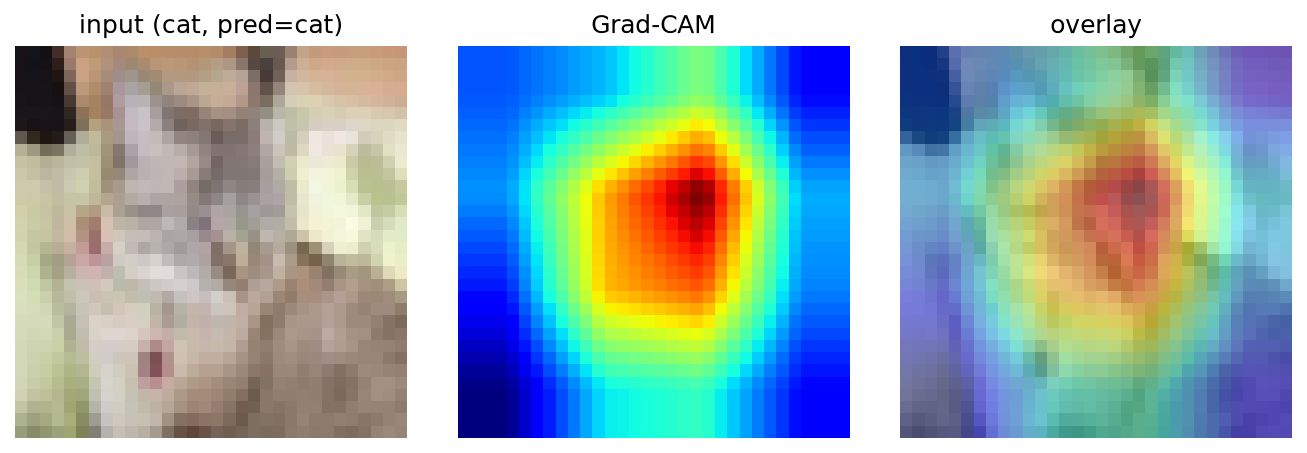
热区精准落在猫的头部和面部,而不是背景或身体末端——模型确实是"看着猫脸"做出的判断,这与人类识别猫的方式一致。Grad-CAM的工程价值在错分样本的诊断上:把判错的图跑一遍,若热区落在无关背景,说明模型学到了捷径特征(比如凭草地判"动物"),这类样本就该进你的增强/清洗清单。它也是向非技术同事解释模型行为的最好工具——一张热区图胜过十句"准确率86%"。
# 1.12 自编码器:没有标签,网络自己学压缩
前面29天全部是监督学习:每个样本都带标签。**自编码器(Autoencoder)**把标签扔掉,只用一张图自己监督自己:编码器把图压成低维向量,解码器再把它还原,损失就是"还原结果与原图的像素差"。它由两个镜像网络组成:
class ConvAE(nn.Module):
    def __init__(self):
        super().__init__()
        self.encoder = nn.Sequential(          # 3x32x32 -> 128x4x4
            nn.Conv2d(3, 32, 3, stride=2, padding=1), nn.ReLU(),    # 16x16
            nn.Conv2d(32, 64, 3, stride=2, padding=1), nn.ReLU(),   # 8x8
            nn.Conv2d(64, 128, 3, stride=2, padding=1), nn.ReLU())  # 4x4
        self.decoder = nn.Sequential(          # 128x4x4 -> 3x32x32
            nn.ConvTranspose2d(128, 64, 3, stride=2, padding=1,
                               output_padding=1), nn.ReLU(),           # 8x8
            nn.ConvTranspose2d(64, 32, 3, stride=2, padding=1,
                               output_padding=1), nn.ReLU(),           # 16x16
            nn.ConvTranspose2d(32, 3, 3, stride=2, padding=1,
                               output_padding=1), nn.Sigmoid())        # 32x32
    def forward(self, x):
        return self.decoder(self.encoder(x))

ae = ConvAE().to(device)   # 实例化并移到GPU
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
三个设计点:stride=2的卷积每层把图缩一半,充当"压缩";转置卷积ConvTranspose2d负责上采样还原(output_padding=1保证尺寸精确翻倍);末端用Sigmoid把输出压回[0,1],与ToTensor后的原图同域,损失用MSE。注意瓶颈层只有128×4×4=2048个数,而输入是3×32×32=3072个——网络被迫学会"保留什么、丢弃什么",这就是压缩。
普通自编码器容易学成"恒等映射"(瓶颈不够窄时,网络偷懒直接抄作业)。**去噪自编码器(Denoising AE)**的解法很聪明:故意给输入加噪声,但目标仍是干净原图——网络想偷懒都不行,因为输入已经被污染,它必须学会"什么才是图像的本质结构":
NOISE = 0.2
for x, _ in train_loader:
    x = x.to(device)
    noisy = (x + NOISE * torch.randn_like(x)).clamp(0, 1)   # 加高斯噪声
    loss = nn.functional.mse_loss(ae(noisy), x)             # 目标仍是干净原图
    ...
2
3
4
5
6
15个epoch后的真实数字:
训练MSE: ep0 0.01831 -> ep4 0.00605 -> ep9 0.00508 -> ep14 0.00477
测试集:  干净输入重建MSE 0.00302 | 加噪图相对原图MSE 0.03329 | 去噪重建MSE 0.00478
2
去噪重建误差0.00478,只有噪声污染程度(0.03329)的1/7。看图更直观——三行依次是原图、加噪图、网络去噪后的重建:
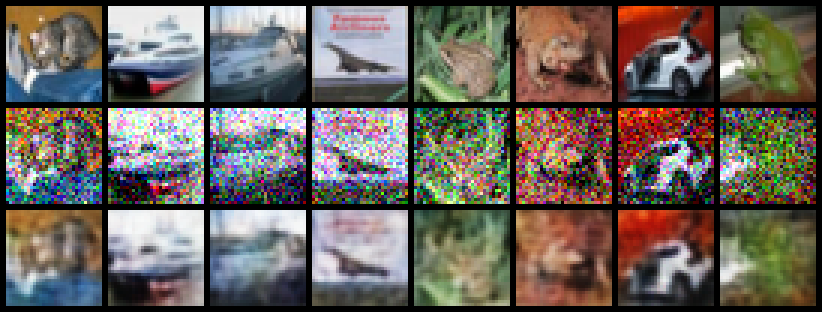
第二行的噪声强度肉眼已难辨认内容,第三行却把船、青蛙、汽车、猫的主体结构基本救了回来,只是细节(文字、细毛)不可恢复地模糊了——被0.2强度的高斯噪声破坏的信息无法凭空复原,网络做的是"基于学到的图像先验的最佳猜测"。这正是DALL·E、Stable Diffusion等扩散模型的底层骨架:扩散模型就是"把加噪-去噪推到极致"的生成模型,今天的手工去噪器是它的最小雏形。顺带一提,自编码器压出来的2048维瓶颈向量还能直接当"无监督特征"喂给下游分类器,是无标签场景(医疗影像、工业质检)的经典套路。
# 1.13 激活值分布:权重初始化的生死实验
可视化回答了"网络学到了什么",接下来换一个视角:用消融实验验证"训练技巧为什么有效"。先看权重初始化——搭一个5层全连接网络(每层100个神经元),喂1000条标准正态随机数据,把每一层的激活值画成直方图。3种权重初始化(std=0.01、Xavier的、He的)×3种激活函数(sigmoid、tanh、ReLU),共9组配置:
import torch
x = torch.randn(1000, 784)                  # 随机输入, 只做前向
for init_name, sigma in [("std=0.01", 0.01),
                         ("Xavier", 1.0/10), ("He", (2.0/100)**0.5)]:
    for act_name, fn in [("sigmoid", torch.sigmoid),
                         ("tanh", torch.tanh), ("relu", torch.relu)]:
        h = x
        for layer in range(5):
            dim_in = 784 if layer == 0 else 100
            W = torch.randn(dim_in, 100) * sigma
            h = fn(h @ W)                  # 记录每层h, 画直方图
2
3
4
5
6
7
8
9
10
11
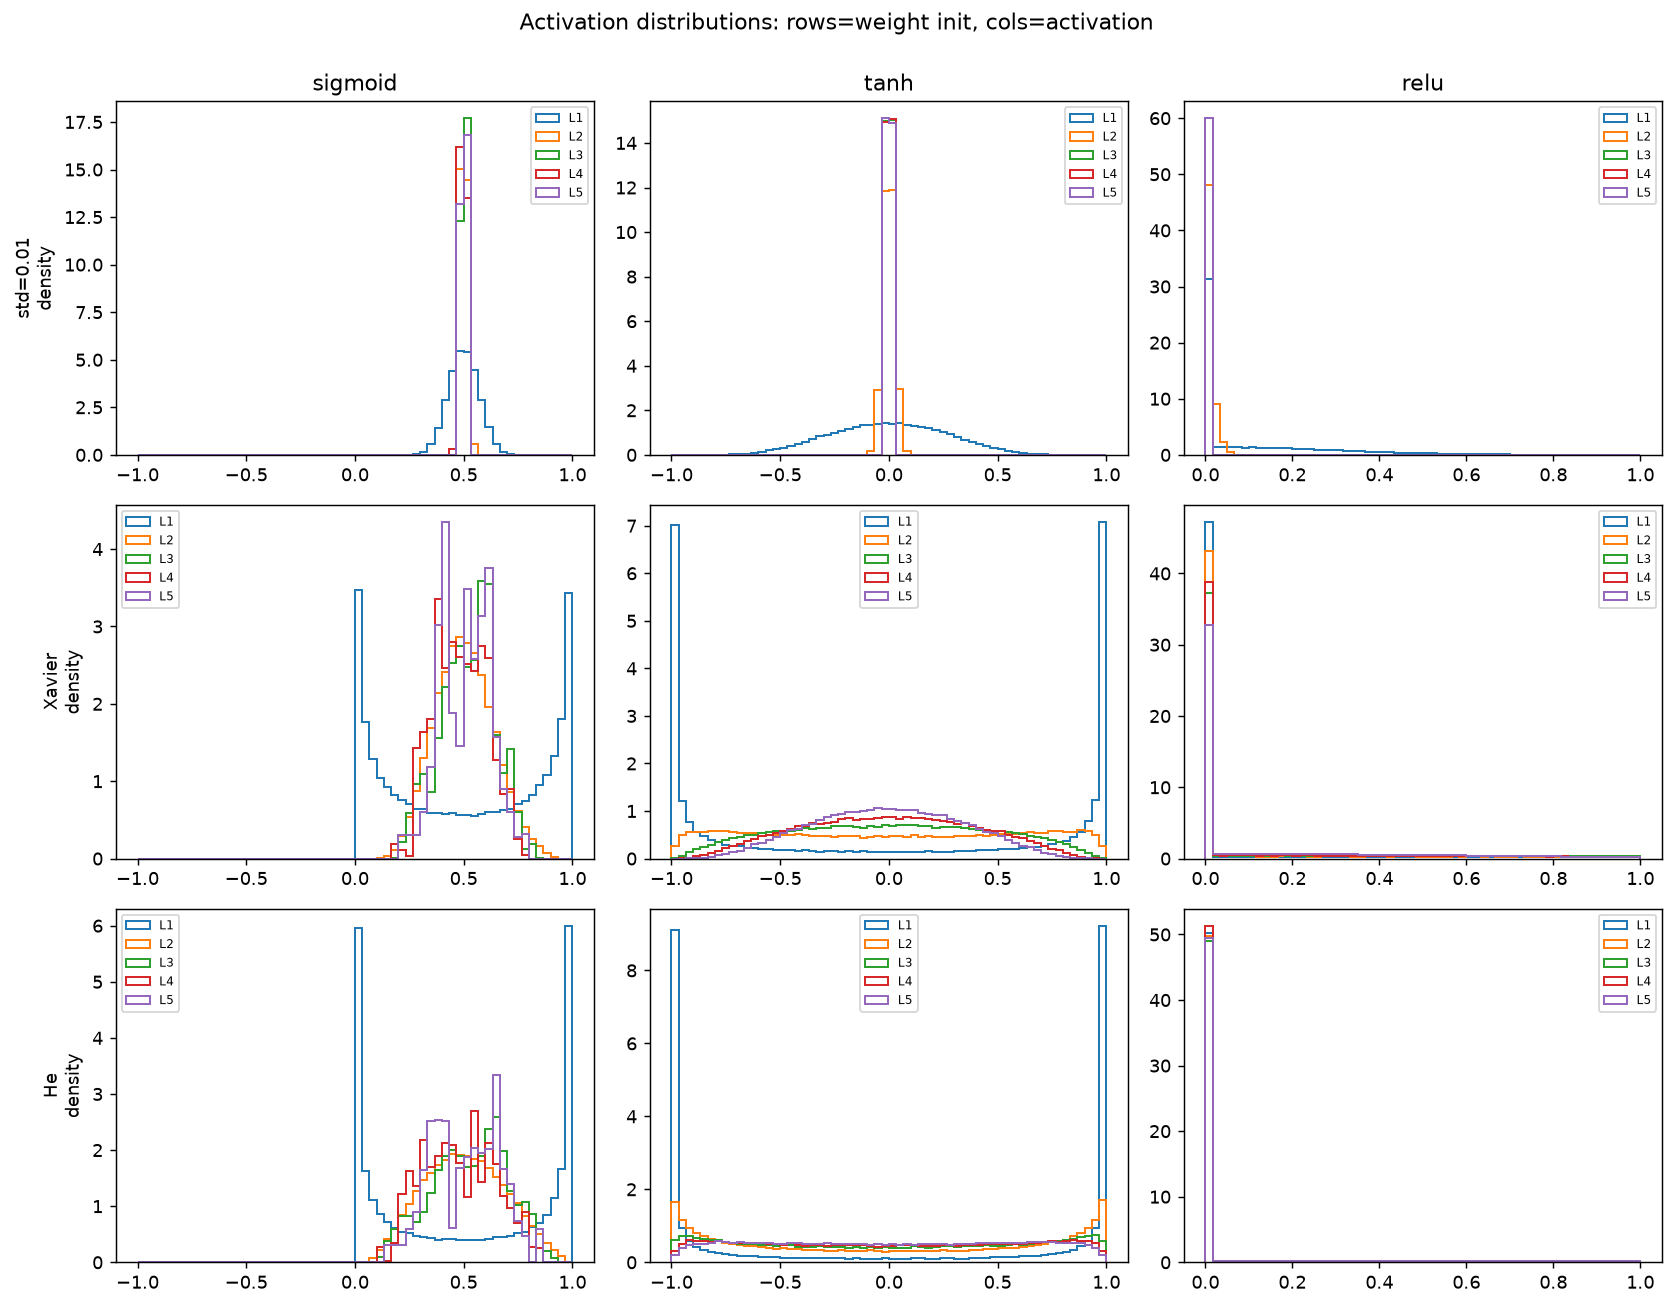
数字比图更冷峻(第5层激活的统计):
| 配置 | 第5层激活平均绝对值 | 第5层近零(|<1e-4|)占比 | 诊断 | | --- | --- | --- | --- | | std=0.01 + sigmoid | 0.5008 | 0.0% | 全部挤进0.5饱和区,导数≈0 | | std=0.01 + tanh | 0.0000203 | 99.97% | 激活逐层收缩,梯度消失 | | std=0.01 + ReLU | 0.0000025 | 100% | 信号直接死光 | | Xavier + tanh | 0.2808 | 0.02% | 分布健康,逐层保持 | | Xavier + ReLU | 0.2461 | 50.6% | 可接受(负半轴本就该为0) | | He + ReLU | 1.3924 | 50.6% | 最健康,方差稳定传递 |
逐列读图:第一行(std=0.01)是灾难现场——sigmoid列5层直方图叠成一根钉在0.5的柱子(激活饱和,sigmoid导数最大才0.25,反向传播时连乘5个接近0的数,梯度消失);tanh列第1层还是宽分布,第5层缩成0点一根针;ReLU更彻底,到第5层全是0。第二行Xavier下三种激活都恢复了健康的形状;第三行He专为ReLU设计,每层分布宽度几乎不变。这就是Day18两条规则的实证:Sigmoid/Tanh配Xavier,ReLU配He。初始化不是玄学,它决定信号在第一层就死还是能走到最后一层。
# 1.14 BatchNorm:把学习率放大10倍的底气
第二个实验换一个视角:搭8层全连接网络(8个100神经元隐藏层),在完整FashionMNIST上训练,对比"每个Linear后插不插BatchNorm1d",以及学习率0.1和1.0两种条件:
class MLP8(nn.Module):
    def __init__(self, use_bn):
        super().__init__()
        layers, in_dim = [], 784
        for _ in range(8):
            layers.append(nn.Linear(in_dim, 100, bias=not use_bn))
            if use_bn:
                layers.append(nn.BatchNorm1d(100))  # BN插在线性层与ReLU之间
            layers.append(nn.ReLU())
            in_dim = 100
        layers.append(nn.Linear(100, 10))
        self.net = nn.Sequential(*layers)
    def forward(self, x):
        return self.net(x.view(len(x), -1))
2
3
4
5
6
7
8
9
10
11
12
13
14
真实训练结果(纯SGD,无momentum,10个epoch):
学习率0.1, 无BN: ep0测试0.1002(loss2.30,起步慢) ... ep9测试0.8657
学习率0.1, 有BN: ep0测试0.8469               ... ep9测试0.8817
学习率1.0, 无BN: ep0测试0.1943, ep1起loss锁死2.30, ep9仍0.1000(网络瘫痪)
学习率1.0, 有BN: ep0测试0.8238               ... ep9测试0.8843
2
3
4
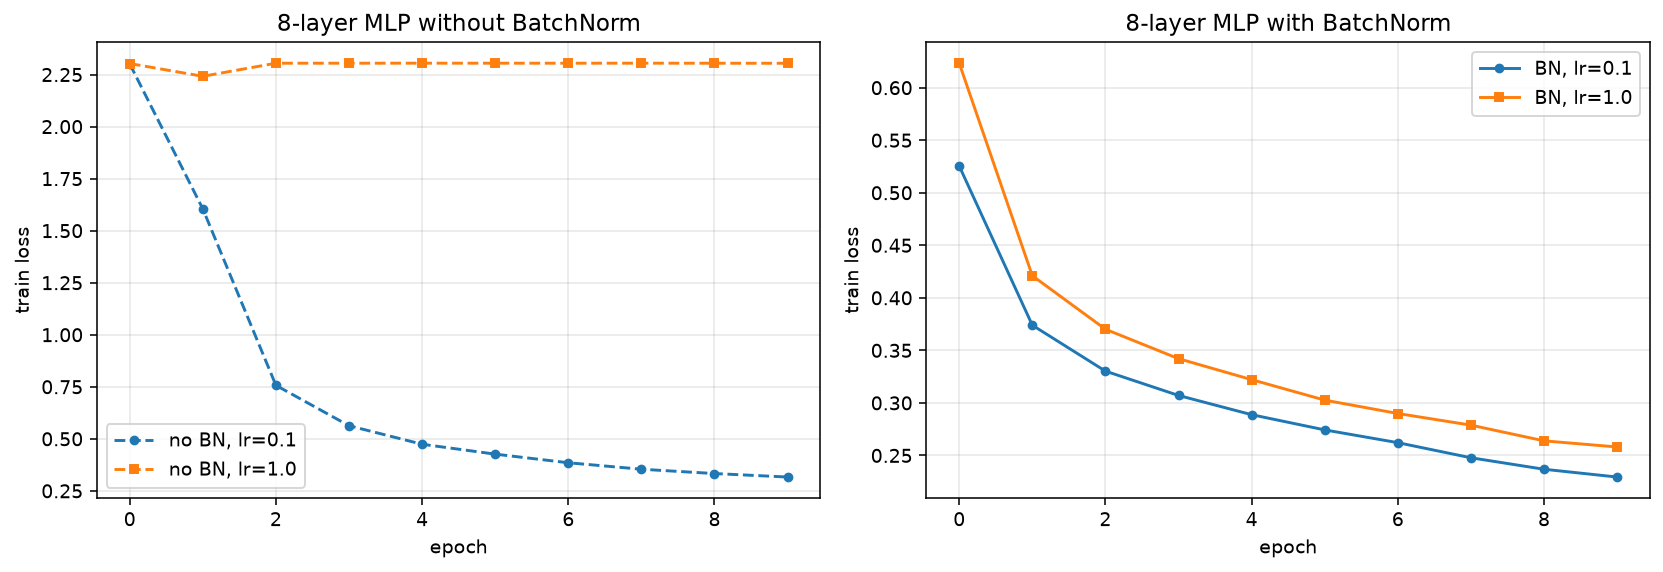
两个结论一目了然:
正常学习率(0.1)下,BN让网络赢在起跑线。无BN组第一个epoch几乎在随机猜(loss 2.30≈ln10),因为8层网络初期的内部协变量偏移严重;BN组第0个epoch就到84.7%。最终10轮后88.17% vs 86.57%。
大学习率(1.0)是BN的封神时刻。无BN网络从第1个epoch起loss锁死在2.3045,十个epoch一动不动——梯度爆炸后权重被推到坏区域,ReLU大面积死亡,这是Day18描述的梯度灾难的活体标本;而同条件下BN网络正常收敛,最终88.43%全场最高。BN不是"略微改善",它是允许你使用大学习率的许可证:每层前向都被归一化回,再用可学习的恢复表达力,深层网络的训练从此不再脆弱。
补充说明工程细节:BN层在训练时用当前batch的均值/方差并维护滑动平均,评估时(model.eval())用滑动平均,这也是Day21训练循环里train/eval必须严格切换的原因之一;卷积层后用BatchNorm2d,全连接后用BatchNorm1d。
# 1.15 正则化实验:一个诚实的反例
第三个实验复刻鱼书的过拟合对照:只用1000张FashionMNIST训练图,搭7层(每层150神经元)的ReLU网络,SGD(lr=0.1)训练250个epoch,对比7种正则配置。先看没有正则的基准:训练准确率冲到100%,测试准确率只有78.8%,21个百分点的鸿沟是教科书级的过拟合。
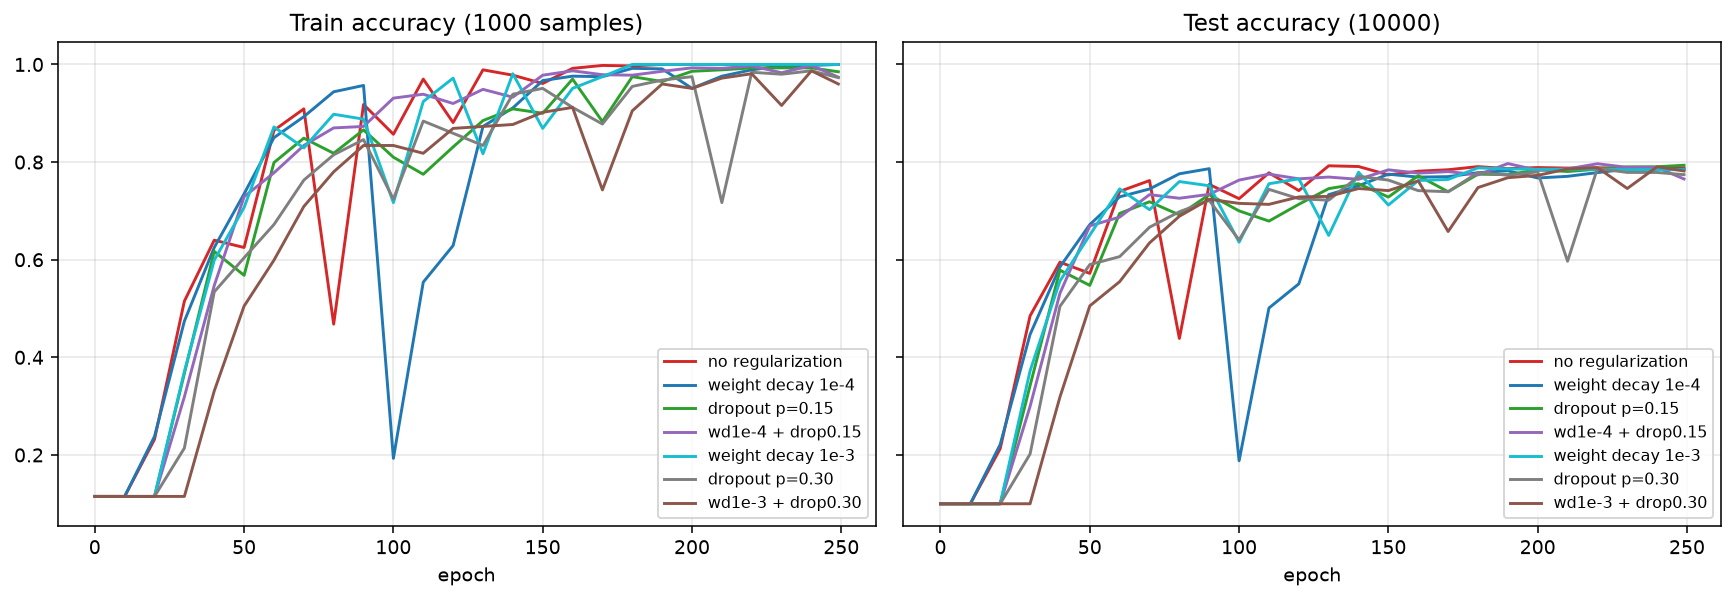
250个epoch后的真实数字:
| 配置 | 训练准确率 | 测试准确率 | 测试最高 |
|---|---|---|---|
| 无正则 | 1.0000 | 0.7881 | 0.7924 |
| weight decay=1e-4 | 1.0000 | 0.7854 | 0.7865 |
| weight decay=1e-3 | 1.0000 | 0.7843 | 0.7881 |
| Dropout p=0.15 | 0.9850 | 0.7935 | 0.7935 |
| Dropout p=0.30 | 0.9730 | 0.7742 | 0.7869 |
| wd1e-4 + Dropout0.15 | 0.9740 | 0.7654 | 0.7970 |
| wd1e-3 + Dropout0.30 | 0.9600 | 0.7817 | 0.7905 |
这里出现了一个和鱼书(MNIST)不完全一致、但必须如实说出的结果:正则化只带来了约1个百分点的改善,而不是鱼书图上那种5个点的跃升;两种weight decay单独使用几乎无效,Dropout p=0.30甚至把最终测试准确率压低了。
原因值得写进笔记:正则化只治"容量过剩型过拟合",不治"数据不足型无知"。FashionMNIST比MNIST难得多——1000张图根本覆盖不了衬衫/外套/套头衫之间的细微差别,模型在训练集上100%靠的部分是"背"了样本,但测试集的差距主要来自它从没见过的变化模式,这不是收缩权重能补回来的,补数据或增强(Day21的翻转裁剪)才对症。Dropout p=0.30在训练数据极少时反而加剧欠拟合(训练准确率掉到97.3%),是典型的"药过量"。唯一拿到测试最高0.7970的是温和组合(wd1e-4+p=0.15),它的训练准确率被压到97.4%、曲线最平稳——正则化的正确剂量是"恰好不让训练集轻松到100%",而不是越大越好。
# 1.16 CNN在学什么:第一层滤波器曝光
实验2中有BN的小CNN(两个卷积块+一个全连接层)在FashionMNIST上达到约91%测试准确率。训练结束后把第一层32个3×3卷积核的权重取出来归一化画成灰度图——这就是鱼书7.6节的经典视角:网络在没有任何人工指导下,自己学出了什么模式?
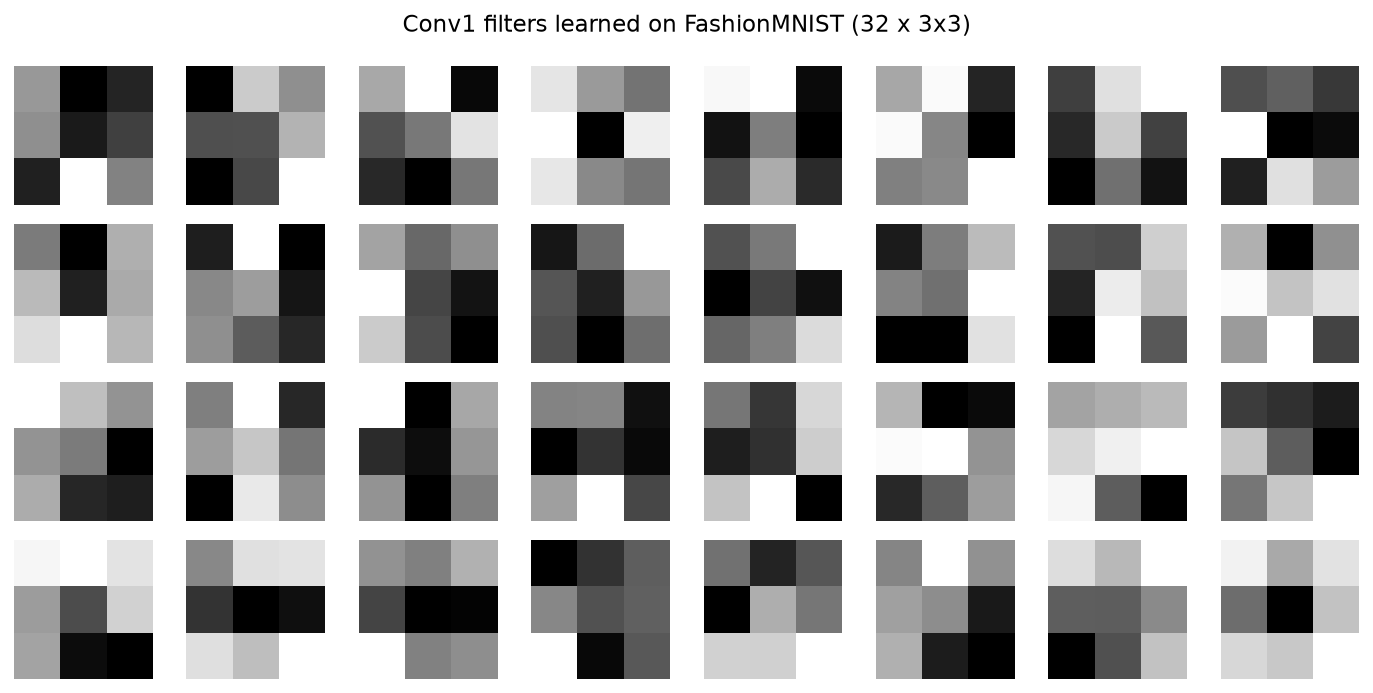
对比前面§1.10的特征图可视化:那张图看的是卷积核对输入的响应(哪里亮),这张图看的是卷积核本身的权重(长什么样)。可以看到不少滤波器呈现出斑点、边缘、条纹状的对比结构——和前面ResNet18在CIFAR上学到的边缘/色块检测器是同一类东西。浅层学通用基元、深层组合基元,这个规律在随机初始化的任何CNN上都会重演。
# 1.17 视觉任务的三级跳
| 任务 | 输出 | 典型应用 | 评价指标 |
|---|---|---|---|
| 图像分类 | 1个类别标签(+概率) | 相册自动归类 | 准确率/F1 |
| 分类+定位 | 1个类别+1个矩形框 | 拍照识物并框出 | 准确率+框误差 |
| 物体检测 | 每类若干个(框+类别+置信度) | 自动驾驶、安防 | mAP(基于IoU) |
| 语义分割 | 每个像素一个类别 | 遥感地物分类 | mIoU |
| 实例分割 | 每像素类别+区分不同个体 | 机器人抓取 | mask mAP |
矩形框(bounding box)用4个数描述:,即左上角和右下角坐标(也有中心点+宽高的表示法)。检测网络的输出本质是"一大堆候选框,每个框带一组类别分数",这就立刻引出两个工程问题:两个框说的是不是同一个物体(怎么衡量)?同一物体的一堆重复框怎么去重?答案是IoU和NMS。
# 1.18 IoU:两个框重叠得有多狠
IoU(Intersection over Union,交并比)是两个框交集面积除以并集面积,完全重合为1、互不沾边为0。它是检测领域的"通用货币":训练时判断预测框与真实框是否匹配(阈值常取0.5),评估时算mAP,NMS时判断重复——全靠它。
def iou(a, b):
    # 框格式 (x1, y1, x2, y2)
    ix1, iy1 = max(a[0], b[0]), max(a[1], b[1])   # 交集左上角
    ix2, iy2 = min(a[2], b[2]), min(a[3], b[3])   # 交集右下角
    iw, ih = max(0.0, ix2-ix1), max(0.0, iy2-iy1) # 不相交时差为负, 截断为0
    inter = iw * ih
    area_a = (a[2]-a[0]) * (a[3]-a[1])
    area_b = (b[2]-b[0]) * (b[3]-b[1])
    return inter / (area_a + area_b - inter)     # 并集=两面积和-交集(交集被算了两次)
2
3
4
5
6
7
8
9
四种几何关系的真实输出:
几乎重合: [10,10,50,50] vs [12,12,52,52] -> IoU=0.8223
一半重叠: [0,0,40,40]   vs [20,0,60,40]  -> IoU=0.3333
角相切:   [0,0,20,20]   vs [20,20,40,40] -> IoU=0.0000
完全分离: [0,0,20,20]   vs [30,30,50,50] -> IoU=0.0000
2
3
4
注意"角相切"IoU也是0——两条边共享一条像素线但交集面积为零。公式的关键在分母用并集而非任一个框:大框套小框时交集虽等于小框面积,但IoU依然小,天然惩罚了"用一个覆盖全图的大框蒙混过关"。
# 1.19 NMS:给同一物体的重复框投票
检测网络通常对同一物体输出几十个高度重叠的框(密集锚框设计的代价)。非极大值抑制(Non-Maximum Suppression, NMS) 的规则只有三步,实现不到10行:
- 按置信度从高到低排序,取最高分的框保留;
- 计算它与其余所有框的IoU,删掉IoU超过阈值的框(它们说的是同一个物体,而且分数更低);
- 对剩下的框重复1-2,直到没有候选。
import numpy as np

def nms(boxes, scores, iou_thresh=0.5):
    order = np.argsort(scores)[::-1]       # 置信度降序的索引
    keep = []
    while len(order) > 0:
        i = order[0]
        keep.append(int(i))               # 最高分框留下
        order = np.array([j for j in order[1:]
                          if iou(boxes[i], boxes[j]) < iou_thresh])
    return keep
2
3
4
5
6
7
8
9
10
11
模拟一个场景:猫和狗各有重复框,远处还有一只低分的猫,共6个框:
IoU阈值=0.3(严格去重): 保留 [猫A(0.95), 狗B(0.90), 远处猫C(0.45)] -> 6框剩3框
IoU阈值=0.5(常规):     保留 [猫A(0.95), 狗B(0.90), 猫A部分重叠(0.72), 远处猫C(0.45)] -> 6框剩4框
2
阈值0.5时,那个与猫A只有0.39重叠的部分框被保留——它可能是猫身体另一处的有效框,也可能是误报。阈值是精度与召回的权衡杆:调低则框更少更干净(但挨得近的两个真物体可能被误杀,比如人群中两个人),调高则更保守。工业界常用0.45~0.5,拥挤场景(行人检测)会用Soft-NMS等改进版降低"误杀邻居"的概率。
# 1.20 两大家族:候选区域的R-CNN与一次看完的YOLO
检测算法2014年以来的演进史,本质是"如何更聪明地找候选框":
两阶段(R-CNN系列,精度优先)
| 模型 | 年份 | 做法 | 解决了前辈的什么痛点 |
|---|---|---|---|
| R-CNN | 2014 | Selective Search提2000个候选区域,每个缩放到224×224过CNN提特征,再SVM分类 | 首次把CNN搬进检测,mAP大幅超越传统方法 |
| Fast R-CNN | 2015 | 整图只过一次CNN,候选区域在共享特征图上用RoI Pooling抠取 | 2000次CNN→1次,训练快上百倍 |
| Faster R-CNN | 2016 | 候选区域也交给网络:RPN(区域提议网络)在特征图上滑动生成锚框 | 去掉Selective Search,端到端,现代两阶段标配 |
RPN的核心概念是锚框(anchor):在特征图每个位置预先摆好几组不同尺寸/长宽比的框,网络只需要学两件事——"这个锚框里有没有东西(objectness)"和"框往哪微调(回归四个偏移量)"。分类解决"是什么",框回归解决"怎么挪准",这个"分类+回归"双头结构是所有现代检测器的通用范式。
一阶段(YOLO/SSD,速度优先)
- YOLO(2016起):把图分成网格,每个网格直接预测固定数量的框+类别,一次前向出全部结果,没有"先提议再分类"的第二阶段。代价是小物体和密集场景略弱,但速度快到可以实时视频(名字就是You Only Look Once)。
- SSD(2016):在多个尺度的特征图上直接回归锚框,浅层高分辨率图负责小物体、深层负责大物体,补上了一阶段对小物体的短板。
记忆坐标:两阶段慢而准(Faster R-CNN是医疗/工业质检首选),一阶段快而稳(YOLO是自动驾驶、视频流首选)。近年两者互相吸收,差距已很小。
# 1.21 分割:把方框细化到每个像素
分割不要框,要逐像素判决。2015年的**FCN(Fully Convolutional Network)**是开山之作:它把分类网络末端的全连接层全部换成1×1卷积,输出不再是类别向量而是一张低分辨率"类别热图",再用转置卷积(Day22自编码器里用过的ConvTranspose2d)上采样回原图大小。这样网络第一次能接受任意尺寸输入并输出空间结果。
**U-Net(2015,医学影像)把这条路走到极致:编码器(收缩提取语义)和对称解码器(放大恢复边界)之间用跳跃连接(skip connection)**直接把浅层的高分辨率细节拼回深层——肿瘤边界、细胞轮廓这些精细结构因此能被还原。它是医学分割事实上的标准,也几乎是所有"图像到图像"任务(去噪、超分、线稿上色)的骨架。
实例分割的代表**Mask R-CNN(2017)**在Faster R-CNN的框分支旁并联一个小型FCN,对每个候选框输出一张像素mask,于是检测和分割一次完成。
分割怎么评分?把IoU从"框"搬到"像素":每个类别统计"预测为该类且正确的像素"占"并集像素"的比例,再对所有类别取平均,就是mIoU(mean Intersection over Union)。用一个二分类小例子手算:
import numpy as np
# 像素混淆矩阵(100个像素): 行=真实, 列=预测
#            预测背景 预测猫
# 真实背景 [   70      10 ]
# 真实猫   [    5      15 ]
cm = np.array([[70, 10],
               [5, 15]])
iou = [cm[k, k] / (cm[k, :].sum() + cm[:, k].sum() - cm[k, k]) for k in range(2)]
print(f"背景IoU={iou[0]:.4f}, 猫IoU={iou[1]:.4f}, mIoU={np.mean(iou):.4f}")
2
3
4
5
6
7
8
9
背景IoU=0.8235, 猫IoU=0.5000, mIoU=0.6618
猫的IoU只有0.50:它只有20个像素且漏了5个、误判10个,小目标天然吃亏——这也是分割比赛里为什么要同时报告"全局mIoU"和"小目标mIoU"。
# 1.22 动手:从零搭一个最小检测头
原理讲完,但"能把检测网络搭出来跑通"是另一回事。完整复刻YOLO/SSD的代价确实高:锚框生成器、正负样本匹配策略、框编解码、多任务损失、COCO标注格式,任意一项单独拆出来都是一个工程模块,还要标注数据集和算力。但检测的真正骨架只有一件东西——在特征图上接一个"分类分数+框回归"的双头(§1.20说的锚框范式)。这件事可以在一张32×32的小图上用一个最小闭环亲手跑通。
数据不用标注:每张图随机放一个纯色矩形,颜色即类别(红/绿/蓝/橙),矩形的位置就是天然的真值框,不需要任何人工画框:
import time
import numpy as np
import torch
import torch.nn as nn
import torch.nn.functional as F
import matplotlib.pyplot as plt
from torchvision.models import resnet18
from torch.utils.data import Dataset, DataLoader

plt.rcParams["font.sans-serif"] = ["Songti SC", "STSong", "Arial Unicode MS"]
plt.rcParams["axes.unicode_minus"] = False

device = torch.device("cuda" if torch.cuda.is_available()
                      else "mps" if torch.backends.mps.is_available() else "cpu")
torch.manual_seed(42)

class RectDataset(Dataset):
    """每张图一个实心矩形(颜色即类别, 共4类), 框就是矩形本身"""
    COLORS = torch.tensor([[1., 0., 0.], [0., 1., 0.], [0., 0., 1.], [1., .6, 0.]])
    NAMES = ["red", "green", "blue", "orange"]

    def __init__(self, n=2000, seed=0):
        g = torch.Generator().manual_seed(seed)
        self.imgs = torch.zeros(n, 3, 32, 32)
        self.boxes = torch.zeros(n, 4)                      # [x1, y1, x2, y2]
        self.labels = torch.randint(0, 4, (n,), generator=g)
        for i in range(n):
            w = int(torch.randint(8, 17, (1,), generator=g))
            h = int(torch.randint(8, 17, (1,), generator=g))
            x1 = int(torch.randint(0, 32 - w, (1,), generator=g))
            y1 = int(torch.randint(0, 32 - h, (1,), generator=g))
            self.imgs[i, :, y1:y1 + h, x1:x1 + w] = self.COLORS[self.labels[i]].view(3, 1, 1)
            self.boxes[i] = torch.tensor([x1, y1, x1 + w, y1 + h], dtype=torch.float)
        self.imgs += 0.05 * torch.randn(n, 3, 32, 32, generator=g)   # 背景噪声
        self.imgs.clamp_(0, 1)

    def __len__(self):
        return len(self.labels)

    def __getitem__(self, i):
        return self.imgs[i], self.boxes[i], self.labels[i]
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
真实产品里的检测数据集要靠人工标注(COCO格式),这里几何位置自己就知道,能把注意力全放在网络和损失上。
锚框:在8×8的特征图上(步幅4)每个位置摆3个不同尺度的框(边长8/14/20像素),共192个候选。小尺度的框负责小物体、大尺度的框负责大物体,这就是§1.20的锚框和SSD多尺度思想的缩小版:
def make_anchors(size=32, feat=8, sides=(8, 14, 20)):
    """8x8特征图(步幅4), 每个位置3个不同尺度的锚框, 共192个"""
    stride = size // feat
    c = torch.arange(feat) * stride + stride / 2        # 2, 6, ..., 30
    gy, gx = torch.meshgrid(c, c, indexing="ij")
    cx, cy = gx.reshape(-1), gy.reshape(-1)
    per_cell = []
    for s in sides:
        a = torch.stack([cx - s / 2, cy - s / 2, cx + s / 2, cy + s / 2], dim=-1)
        a[:, [0, 2]] = a[:, [0, 2]].clamp(0, size)      # 超出图像的框裁回边界
        a[:, [1, 3]] = a[:, [1, 3]].clamp(0, size)
        per_cell.append(a)
    return torch.cat(per_cell, dim=0)                   # (192, 4)
2
3
4
5
6
7
8
9
10
11
12
13
框编解码:网络不直接预测绝对坐标,而是预测"相对某个锚框的偏移"。编码时把框真值转成(中心偏移/锚框边长, log(宽高比))四个量,推理时再解码回绝对坐标。归一化和log让大小不同的框回归到同一数量级,训练更稳——否则网络会偏心学大框、学不动小框:
def box_iou(a, b):
    """a:(A,4) b:(4,) -> (A,)  与§1.18的IoU完全同源"""
    x1 = torch.maximum(a[:, 0], b[0]); y1 = torch.maximum(a[:, 1], b[1])
    x2 = torch.minimum(a[:, 2], b[2]); y2 = torch.minimum(a[:, 3], b[3])
    inter = (x2 - x1).clamp(min=0) * (y2 - y1).clamp(min=0)
    union = ((a[:, 2] - a[:, 0]) * (a[:, 3] - a[:, 1])
             + (b[2] - b[0]) * (b[3] - b[1]) - inter)
    return inter / (union + 1e-9)

def encode(anchors, box):
    """框 -> 相对锚框的归一化偏移(中心偏移除以边长, 宽高取log比)"""
    acx = (anchors[:, 0] + anchors[:, 2]) / 2; acy = (anchors[:, 1] + anchors[:, 3]) / 2
    aw = anchors[:, 2] - anchors[:, 0]; ah = anchors[:, 3] - anchors[:, 1]
    gcx = (box[0] + box[2]) / 2; gcy = (box[1] + box[3]) / 2
    gw = box[2] - box[0]; gh = box[3] - box[1]
    return torch.stack([(gcx - acx) / aw, (gcy - acy) / ah,
                        torch.log(gw / aw), torch.log(gh / ah)], dim=1)

def decode(anchors, t):
    """偏移 -> 框(回归分支的逆运算)"""
    acx = (anchors[:, 0] + anchors[:, 2]) / 2; acy = (anchors[:, 1] + anchors[:, 3]) / 2
    aw = anchors[:, 2] - anchors[:, 0]; ah = anchors[:, 3] - anchors[:, 1]
    cx = acx + t[:, 0] * aw; cy = acy + t[:, 1] * ah
    w = aw * torch.exp(t[:, 2]); h = ah * torch.exp(t[:, 3])
    return torch.stack([cx - w / 2, cy - h / 2, cx + w / 2, cy + h / 2], dim=1)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
模型:ResNet18骨干(权重要None从零训,去掉分类头,取到layer3为止,输出256通道的8×8特征图)接一个1×1卷积检测头。头输出锚框数×(1个objectness+4个框偏移+4个类别)=27个通道,view+permute后拍平成(N, 192, 9)——每个候选框一行,前5个是"有没有物体+框偏移",后4个是类别分数:
class TinyDetector(nn.Module):
    def __init__(self, num_classes=4, num_anchors=3):
        super().__init__()
        base = resnet18(weights=None)
        base.conv1 = nn.Conv2d(3, 64, 3, stride=1, padding=1, bias=False)
        base.maxpool = nn.Identity()
        # 取到layer3为止: 输出256通道的8x8特征图, 步幅4
        self.backbone = nn.Sequential(*list(base.children())[:-3])
        self.num_anchors = num_anchors
        self.num_classes = num_classes
        # 每个位置 A 个锚框, 每个锚框输出 obj(1) + 框偏移(4) + 类别(num_classes)
        self.head = nn.Conv2d(256, num_anchors * (1 + 4 + num_classes), 1)

    def forward(self, x):
        n, c = x.size(0), 1 + 4 + self.num_classes
        o = self.head(self.backbone(x))                  # (N, A*c, 8, 8)
        o = o.view(n, self.num_anchors, c, 8, 8)
        return o.permute(0, 1, 3, 4, 2).reshape(n, -1, c)  # (N, A*64, c)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
正负样本匹配是检测区别于分类的关键一步:不是所有锚框都参与框回归,得先挑出"哪个锚框负责哪个真值框"。规则用§1.18的IoU:与真值框IoU≥0.5的锚框算正样本,再额外强制把IoU最大的那个锚框也设成正样本——否则一张小物体图可能一个正样本都挑不出来,框回归分支就没有梯度:
anchors = make_anchors().to(device)
CLASS_NAMES = RectDataset.NAMES

train_ds, test_ds = RectDataset(2000, seed=0), RectDataset(400, seed=1)
train_loader = DataLoader(train_ds, batch_size=64, shuffle=True)
test_loader = DataLoader(test_ds, batch_size=64)

model = TinyDetector().to(device)
optimizer = torch.optim.Adam(model.parameters(), lr=1e-3)
scheduler = torch.optim.lr_scheduler.CosineAnnealingLR(optimizer, T_max=15)  # §1.4讲过

def build_target(box, label):
    """正样本 = IoU>=0.5的锚框, 外加IoU最大的那个(保证每张图至少1个正样本)"""
    ious = box_iou(anchors, box)
    pos_mask = ious >= 0.5
    pos_mask[int(ious.argmax())] = True
    obj = pos_mask.float()
    cls_t = torch.zeros(anchors.size(0), dtype=torch.long, device=device)
    cls_t[pos_mask] = label
    reg_t = torch.zeros(anchors.size(0), 4, device=device)
    reg_t[pos_mask] = encode(anchors, box)[pos_mask]
    return obj, cls_t, reg_t
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
负样本的objectness目标为0,类别和框不加任何约束。于是损失由三块组成:全场锚框的objectness二分类(BCE)+仅正样本的框回归(Smooth L1)+仅正样本的分类(交叉熵),这就是Faster R-CNN"多任务损失"的最小版:
for epoch in range(15):
    t0 = time.time()
    model.train()
    total_loss = 0.0
    for imgs, boxes, labels in train_loader:
        imgs, boxes, labels = imgs.to(device), boxes.to(device), labels.to(device)
        out = model(imgs)                                       # (N, 192锚框, 9)
        obj_logit, reg_pred, cls_logit = out[..., 0], out[..., 1:5], out[..., 5:]

        obj_t = torch.zeros_like(obj_logit)
        cls_t = torch.zeros(obj_logit.shape, dtype=torch.long, device=device)
        for b in range(imgs.size(0)):
            obj_t[b], cls_t[b], reg_t_b = build_target(boxes[b], labels[b])
            if b == 0:
                reg_t = torch.zeros_like(reg_pred)
            reg_t[b] = reg_t_b

        pos = obj_t > 0.5
        loss_obj = F.binary_cross_entropy_with_logits(obj_logit, obj_t)
        loss_box = F.smooth_l1_loss(reg_pred[pos], reg_t[pos]) if pos.any() else 0
        loss_cls = F.cross_entropy(cls_logit[pos], cls_t[pos]) if pos.any() else 0
        loss = loss_obj + loss_box + loss_cls

        optimizer.zero_grad(); loss.backward(); optimizer.step()
        total_loss += loss.item()
    scheduler.step()

    # 评估: 取obj分数最高的锚框解码, 与真值比分类准确率和IoU
    model.eval()
    n_correct, iou_sum, n = 0, 0.0, 0
    with torch.no_grad():
        for imgs, boxes, labels in test_loader:
            imgs, boxes, labels = imgs.to(device), boxes.to(device), labels.to(device)
            out = model(imgs)
            obj_logit, reg_pred, cls_logit = out[..., 0], out[..., 1:5], out[..., 5:]
            best = obj_logit.argmax(dim=1)                       # (N,)
            pred_cls = cls_logit[torch.arange(len(best)), best].argmax(dim=1)
            n_correct += (pred_cls == labels).sum().item()
            sel = torch.arange(len(best))
            pred_box = decode(anchors[best], reg_pred[sel, best])   # (N,4)
            for b in range(imgs.size(0)):
                iou_sum += float(box_iou(pred_box[b:b + 1], boxes[b])[0])
            n += imgs.size(0)
    print(f"epoch {epoch+1}/15  loss {total_loss/len(train_loader):.4f}  "
          f"cls_acc {n_correct/n:.4f}  meanIoU {iou_sum/n:.4f}  ({time.time()-t0:.1f}s)")
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
真实运行结果(Apple M4 MPS,15个epoch,每轮约6秒):
epoch 1/15  loss 0.4913  cls_acc 1.0000  meanIoU 0.5571  (7.2s)
epoch 2/15  loss 0.0734  cls_acc 1.0000  meanIoU 0.7153  (6.5s)
epoch 3/15  loss 0.0532  cls_acc 1.0000  meanIoU 0.7354  (6.2s)
epoch 4/15  loss 0.0439  cls_acc 1.0000  meanIoU 0.7353  (6.2s)
epoch 5/15  loss 0.0366  cls_acc 1.0000  meanIoU 0.7331  (6.2s)
epoch 6/15  loss 0.0323  cls_acc 1.0000  meanIoU 0.6802  (6.1s)
epoch 7/15  loss 0.0281  cls_acc 1.0000  meanIoU 0.7461  (6.0s)
epoch 8/15  loss 0.0253  cls_acc 1.0000  meanIoU 0.7105  (6.0s)
epoch 9/15  loss 0.0230  cls_acc 1.0000  meanIoU 0.7114  (6.1s)
epoch 10/15  loss 0.0214  cls_acc 1.0000  meanIoU 0.7731  (6.4s)
epoch 11/15  loss 0.0199  cls_acc 1.0000  meanIoU 0.7830  (6.3s)
epoch 12/15  loss 0.0195  cls_acc 1.0000  meanIoU 0.7985  (6.8s)
epoch 13/15  loss 0.0190  cls_acc 1.0000  meanIoU 0.8096  (6.7s)
epoch 14/15  loss 0.0183  cls_acc 1.0000  meanIoU 0.8149  (6.7s)
epoch 15/15  loss 0.0180  cls_acc 1.0000  meanIoU 0.8258  (6.4s)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
分类准确率从第1轮就100%——纯色矩形太好认;真正有难度的是框回归,meanIoU从0.56一路爬到0.83。中途几轮有回落(0.68、0.71),直到训练后段才稳定抬升,这正是§1.4讲的余弦退火"先快后慢、平滑减速"的效果:前期大lr负责探索,后期lr趋零让框稳稳收敛。评估时取objectness分数最高的那个锚框解码,就是网络认为"最像物体"的位置。
最后把预测框画出来,绿色实线是真值框、红色虚线是预测框:
model.eval()
imgs, boxes, labels = next(iter(test_loader))
with torch.no_grad():
    out = model(imgs.to(device))
    best = out[..., 0].argmax(dim=1)
    idx = torch.arange(len(best))
    pred_cls = out[idx, best, 5:].argmax(dim=1).cpu()
    pred_box = decode(anchors[best], out[idx, best, 1:5]).cpu()

fig, axes = plt.subplots(1, 4, figsize=(11, 3.2), dpi=110)
for k, ax in enumerate(axes):
    ax.imshow(imgs[k].permute(1, 2, 0).clamp(0, 1))
    g = boxes[k]
    ax.add_patch(plt.Rectangle((g[0] - .5, g[1] - .5), g[2] - g[0], g[3] - g[1],
                               fill=False, edgecolor="lime", linewidth=2))
    p = pred_box[k]
    ax.add_patch(plt.Rectangle((p[0] - .5, p[1] - .5), p[2] - p[0], p[3] - p[1],
                               fill=False, edgecolor="red", linewidth=1.6, linestyle="--"))
    ax.set_title(f"true {CLASS_NAMES[labels[k]]} / pred {CLASS_NAMES[pred_cls[k]]}", fontsize=9)
    ax.axis("off")
plt.tight_layout()
plt.show()
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
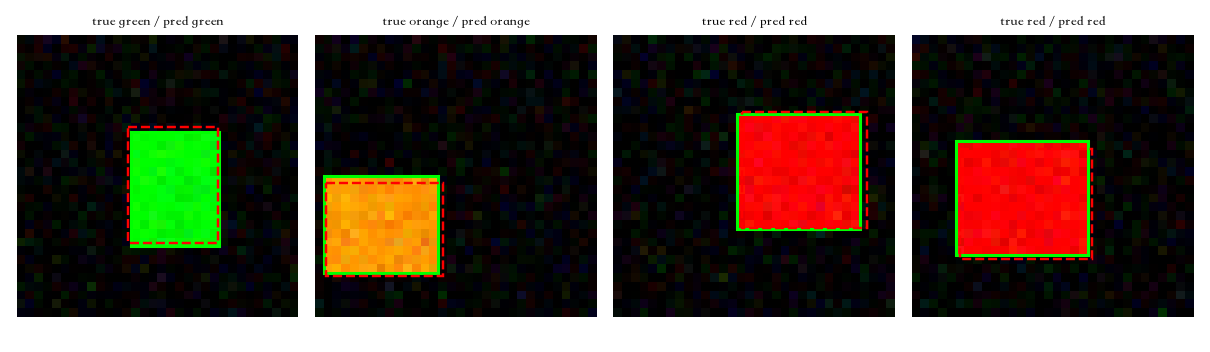
四张测试图的预测框与真值框几乎完全重合,类别也全部正确。这个demo停留在"单物体、清晰可分类"的入门水平:没做NMS、没有多物体、也没碰真正的mAP,但它把检测的完整数据流跑通了——图像→骨干→特征图→锚框→检测头→编解码→正负样本匹配→多任务损失→框回归。日后用torchvision.models.detection或Ultralytics(YOLO)时,这些概念会以参数和配置项的形式再次出现;先把它们理解透,再用库,就不会被库的参数淹没——这和Day21迁移学习的心法一致。
# 小结
| 工具/策略 | 用法 | 今天拿到的数字 |
|---|---|---|
| 混淆矩阵 | confusion_matrix(y_true, y_pred) | 猫0.69、汽车0.956, 错误集中在cat↔dog |
| 分类报告 | classification_report(..., digits=4) | airplane精确率0.7526 vs 召回率0.9490 |
| 指标选择 | 高代价漏报→看recall, 高代价误报→看precision | 业务决定指标, 不反过来 |
| 固定lr | 不调度 | 0.7567, 曲线剧烈震荡 |
| StepLR | 每4ep×0.3 | 0.8164, 阶梯式抬升 |
| Cosine | T_max=总epoch | 0.8374, 平滑无震荡, 现代默认 |
| OneCycle | 按step调度, max_lr唯一 | 0.8425, 免调初始lr, +8.6pp |
| autocast fp16 | with torch.autocast("cuda", dtype=torch.float16) | MPS上无提速(1.001x), 数值正确 |
| autocast bf16 | dtype=torch.bfloat16 | MPS上反而慢10%, 但无需scaler |
| GradScaler | scale(loss)->backward->step->update | CUDA+fp16必配; bf16不需要 |
| MPS计时 | 先torch.mps.synchronize()再计 | 异步后端不同步会测出假时间 |
| 标量记录 | add_scalar("loss/train", v, step) | 曲线自动按tag分组对比 |
| 图像记录 | add_images("batch", img, step) | 检查增强效果的第一现场 |
| 计算图 | add_graph(model, dummy_input) | 双击展开的前向结构 |
| 启动面板 | tensorboard --logdir runs | localhost:6006 |
| 技术/实验 | 做法 | 眼见为实的结果 |
|---|---|---|
| 特征图可视化 | forward hook截取conv输出,按激活强度选通道 | conv1输出64张32×32激活图,呈边缘/色块响应 |
| Grad-CAM | 目标层激活×梯度GAP权重,ReLU后上采样 | 猫图热区聚焦头部;错分样本诊断利器 |
| 自编码器 | 编码器压缩(stride=2) + 解码器重建(ConvTranspose) | 干净重建MSE 0.00302 |
| 去噪自编码器 | 输入加噪0.2,目标仍是干净原图 | 去噪MSE 0.00478,为污染程度的1/7 |
| 激活分布 | 初始化std=0.01/Xavier/He × sigmoid/tanh/ReLU | 0.01权重:tanh第5层99.97%近零,ReLU 100%死亡 |
| BN×学习率 | 8层MLP插不插BN, lr=0.1/1.0 | lr=1.0无BN锁死loss2.30;有BN正常收敛到0.8843 |
| 过拟合 | 1000样本, 7层150网络 | 无正则train100%/test78.8%, gap21pp |
| 正则剂量 | wd 1e-4~1e-3, dropout 0.15~0.30 | 最佳仅+1pp(0.7970), 过量Dropout反伤;正则不治数据不足 |
| 权重可视化 | 取conv1权重画灰度图 | 自发学出边缘/条纹/斑点滤波器 |
| 概念/模型 | 一句话 | 今天的真实数字/写法 |
|---|---|---|
| IoU | 交集/并集, 检测的通用距离 | 重合0.82/半重叠0.33/分离0 |
| NMS | 留最高分, 删除IoU超阈的邻居 | 6框→3框(0.3)/4框(0.5) |
| 锚框 | 特征图上预设多尺度框, 学分类+回归偏移 | RPN的核心 |
| 最小检测头 | ResNet骨干+1×1卷积头, 输出obj/框偏移/类别 | 15轮 cls_acc 1.0, meanIoU 0.8258 |
| R-CNN→Fast→Faster | 2000次CNN→共享特征→RPN端到端 | 两阶段, 精度优先 |
| YOLO/SSD | 一次前向出全部框 | 一阶段, 速度优先 |
| FCN | FC换卷积, 输出热图再上采样 | 分割开山之作 |
| U-Net | 编解码+跳跃连接保边界 | 医学分割标准 |
| mIoU | 每类像素IoU取平均 | 示例0.6618 |
评估、监控、可解释到检测分割,今天把"理解模型"和"视觉应用"的链路一次走通。Day23收官:从GAN的生成对抗,到优化器全景和现代训练技巧,再到DenseNet、EfficientNet和ViT的架构演进——深度学习图像主线完整收束。