
# 勤奋的凯尔森同学10000h刻意练习Day16:深度学习入门 —— 从感知机到激活函数家族
所属专栏: 凯尔森的10000h刻意练习
Slogan: 一个36岁程序员, 研究生(学硕),前世界500强top20软件开发Java工程师,用10000小时深耕AI, 目标Top10 AI资深工程师, 全程日更记录。
一个只会输出0和1的感知机,凭什么能堆出会写诗、会画画、会开车的大模型?
Day6~Day15用10天走完了传统机器学习:线性回归、逻辑回归、决策树、SVM、集成学习、HMM/CRF、SVD……这些模型有一个共同的天花板——特征要靠人手工设计。表格数据还好办,一旦面对图像、语音、文本这种非结构化数据,人工提特征就玩不转了。今天正式踏入深度学习:让模型自己从数据里学特征。从感知机出发,看清多层网络怎么跨越线性边界,再把整族激活函数一次备齐——它们是后面理解整个神经网络的关键。
# 1.1 深度学习概述: 机器学习的"自动特征提取"分支
# 1.1.1 深度学习简介
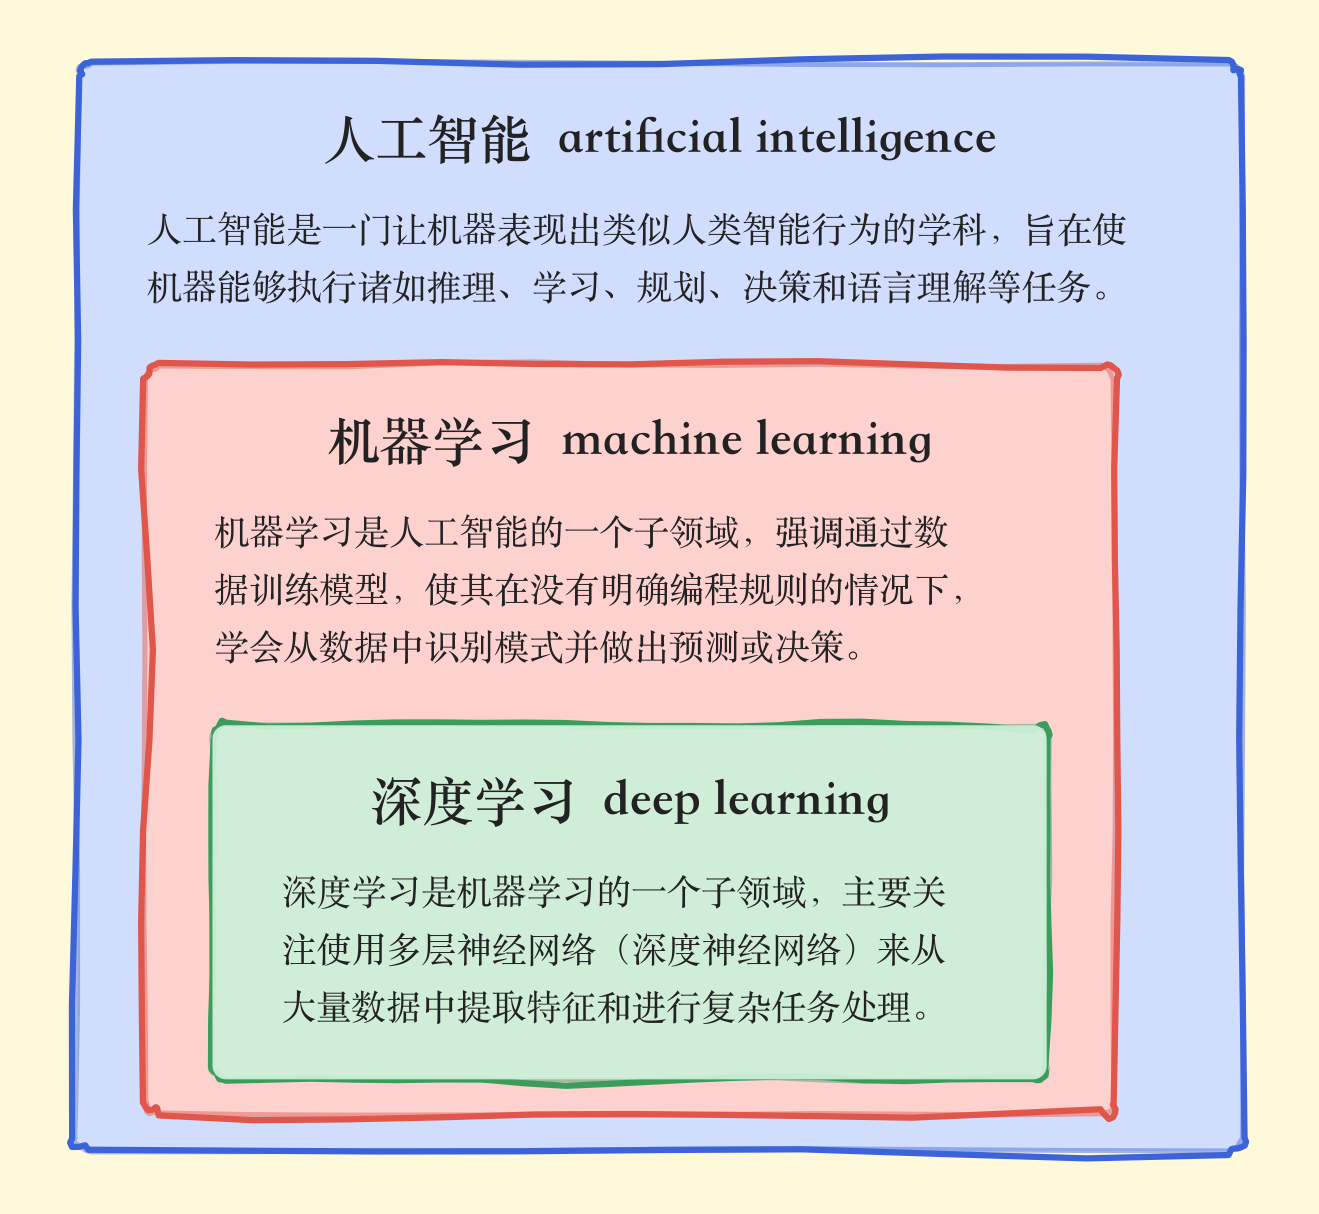
深度学习(Deep Learning)是机器学习的一个分支, 专注于使用**多层神经网络(深度神经网络)**来建模和解决问题。
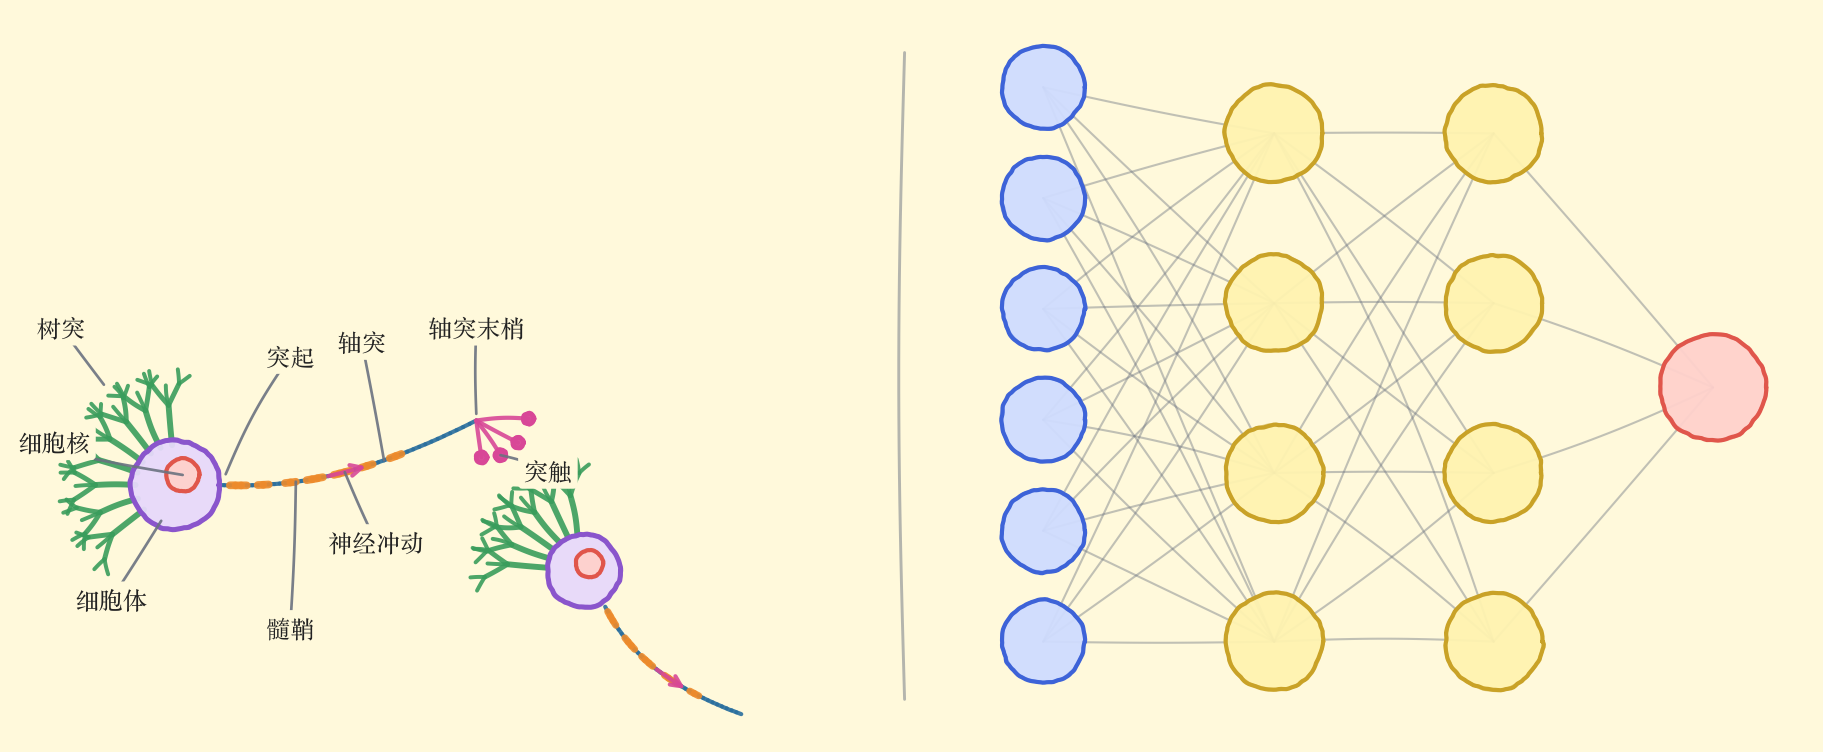
为什么叫"神经网络"? 灵感来自人脑。人脑中有很多相互连接的神经元,当大脑处理信息时,这些神经元之间通过电信号和化学物质相互作用,在大脑的不同区域之间传递信息。神经网络使用人工神经元模仿这种生物现象——这些人工神经元由称为节点的软件模块构成,使用数值计算来进行通信和传递信息。
# 1.1.2 深度学习的特点
对比Day6~Day15的传统机器学习,深度学习有四个鲜明特点:
- 自动提取多层次特征: 使用多层神经网络,能够自动提取数据的多层次特征——这是和传统ML最本质的区别
- 擅长非结构化数据: 适合处理图像、音频、文本等传统ML搞不定的数据
- 吃数据、吃算力: 依赖大量数据和计算资源,训练时间较长
- 黑箱: 模型复杂,通常被视为"黑箱", 解释性较差
# 1.1.3 深度学习应用场景
深度学习几乎渗透了所有行业,挑八个典型领域感受一下:
| 领域 | 应用 |
|---|---|
| 金融服务 | 预测分析可推荐股票的算法交易,评估贷款审批的业务风险,检测欺诈行为,并帮助管理信贷和投资组合 |
| 媒体和娱乐 | 从网上购物到流媒体服务,跟踪用户活动及开发个性化推荐 |
| 客户服务 | 聊天机器人、虚拟助手和拨入式客户服务门户网站利用语音识别等工具 |
| 医疗卫生 | 通过图像识别应用和深度学习技术,医学影像专家可以利用数字化的医疗记录和医学影像数据来支持和改进医学诊断过程,提供更精确和高效的医疗服务 |
| 工业自动化 | 在工厂和仓库中,自动检测人或物体何时处于机器的安全距离之外,或协助质量控制及预测性维护 |
| 自动驾驶汽车 | 汽车行业研究员使用深度学习来训练汽车检测停车标志、红绿灯、人行横道和行人等对象 |
| 航空航天和军事 | 在监控的大片地理区域中检测物体,从远处识别需要关注的区域,并为部队验证安全或不安全区域 |
| 执法 | 语音识别、计算机视觉和自然语言处理(NLP)有助于分析大量数据,从而节省时间和资源 |
# 1.2 神经网络的构成: 从生物神经元到人工神经元
# 1.2.1 生物神经元的工作机制
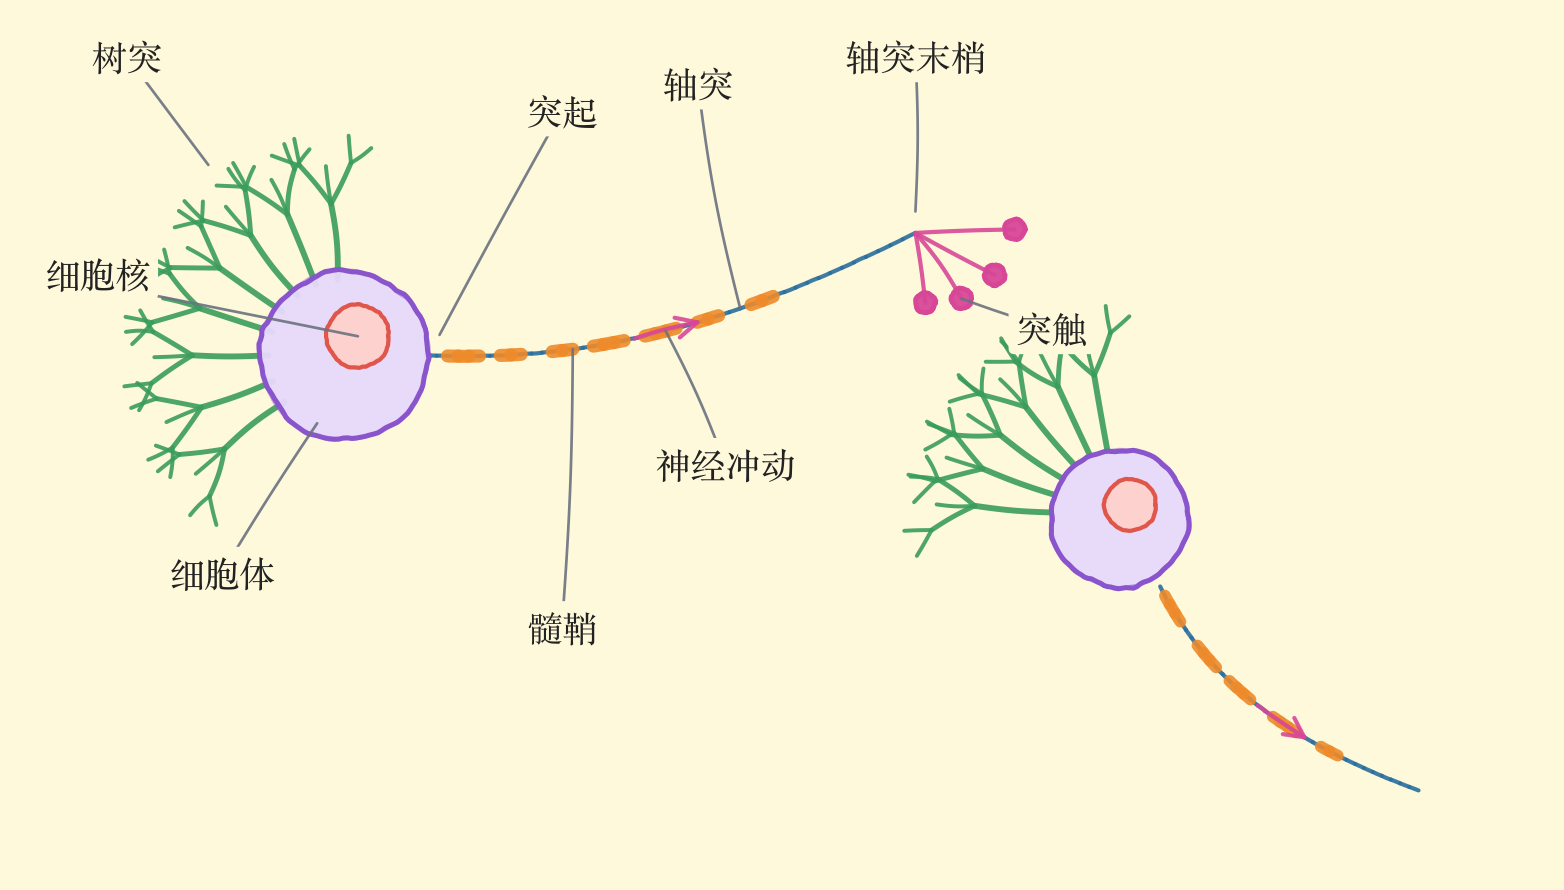
在生物体中,神经元是神经系统最基本的结构和功能单位。它的工作流程分两步:
- 接收与累加: 神经元从树突接收其它神经元细胞发出的电化学刺激脉冲,这些脉冲叠加后,一旦强度达到临界值,这个神经元就会产生动作电位,沿着轴突发送电信号
- 传递: 轴突将刺激传到末端的突触,电信号触发突触上面的电压敏感蛋白,把一个内含神经递质的小泡(突触小体)推到突触的膜上,从而释放出突触小体中的神经递质。这些化学物质会扩散到其它神经元的树突或轴突上
注意第一步里"脉冲叠加、超过临界值才放电"这个设计——它就是人工神经元"加权求和+阈值判断"的生物学原型。
# 1.2.2 人工神经网络的基本概念和结构
人工神经网络(Artificial Neural Network, ANN)简称神经网络(NN), 是一种模仿生物神经网络结构和功能的计算模型。大多数情况下,人工神经网络能在外界信息的基础上改变内部结构,是一种自适应系统(adaptive system)——通俗地讲,就是具备学习功能。
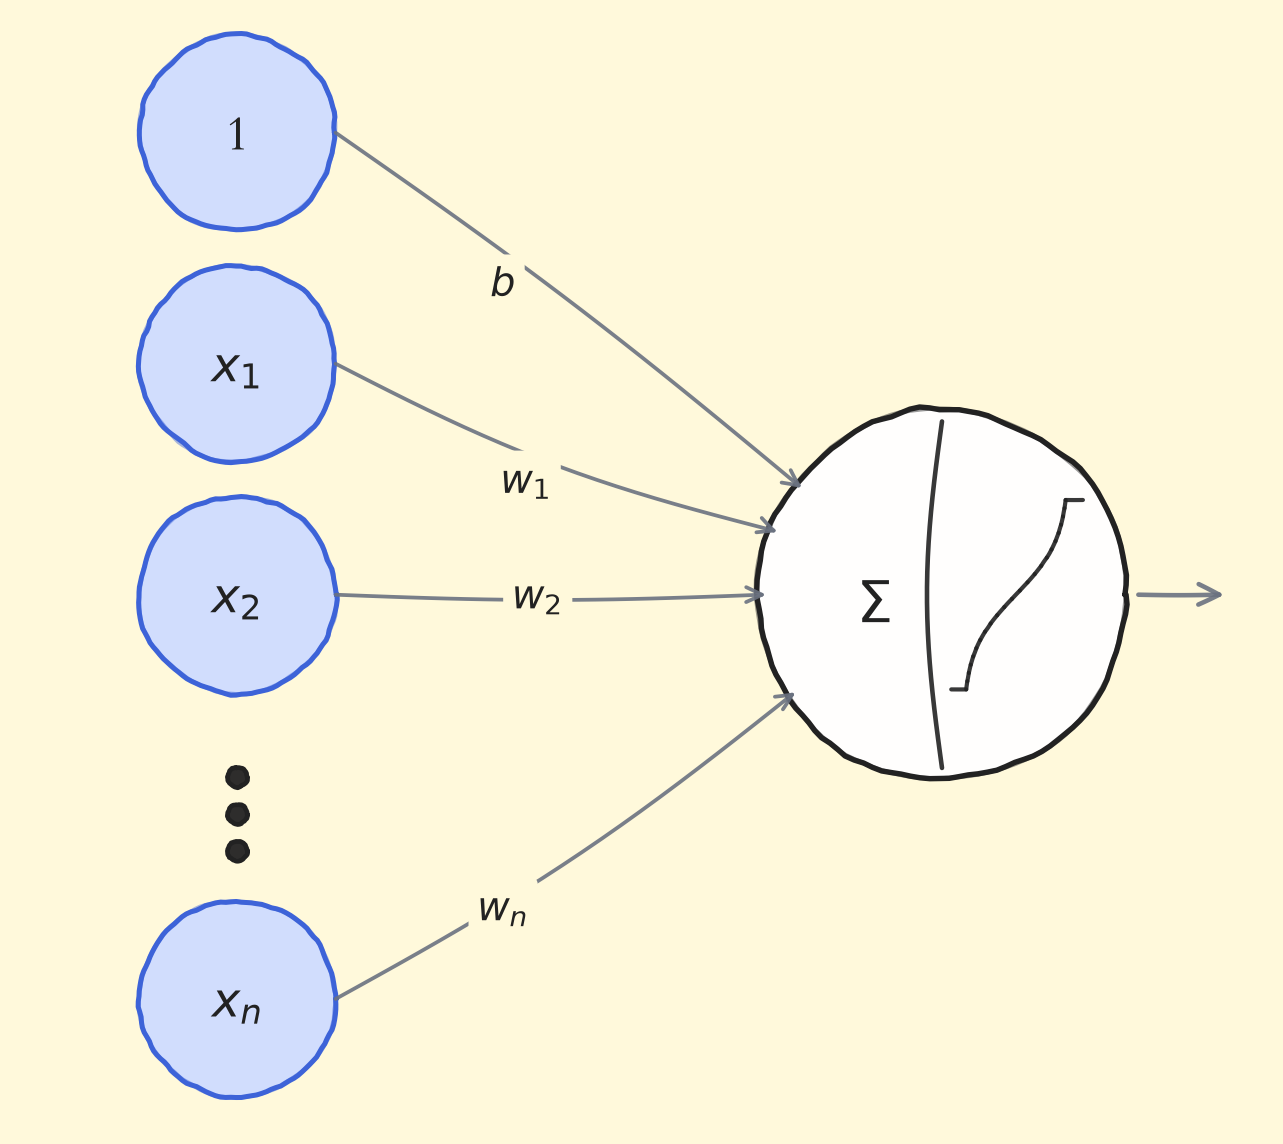
人工神经网络中的神经元,一般可以对多个输入进行加权求和, 再经过特定的激活函数转换后输出。
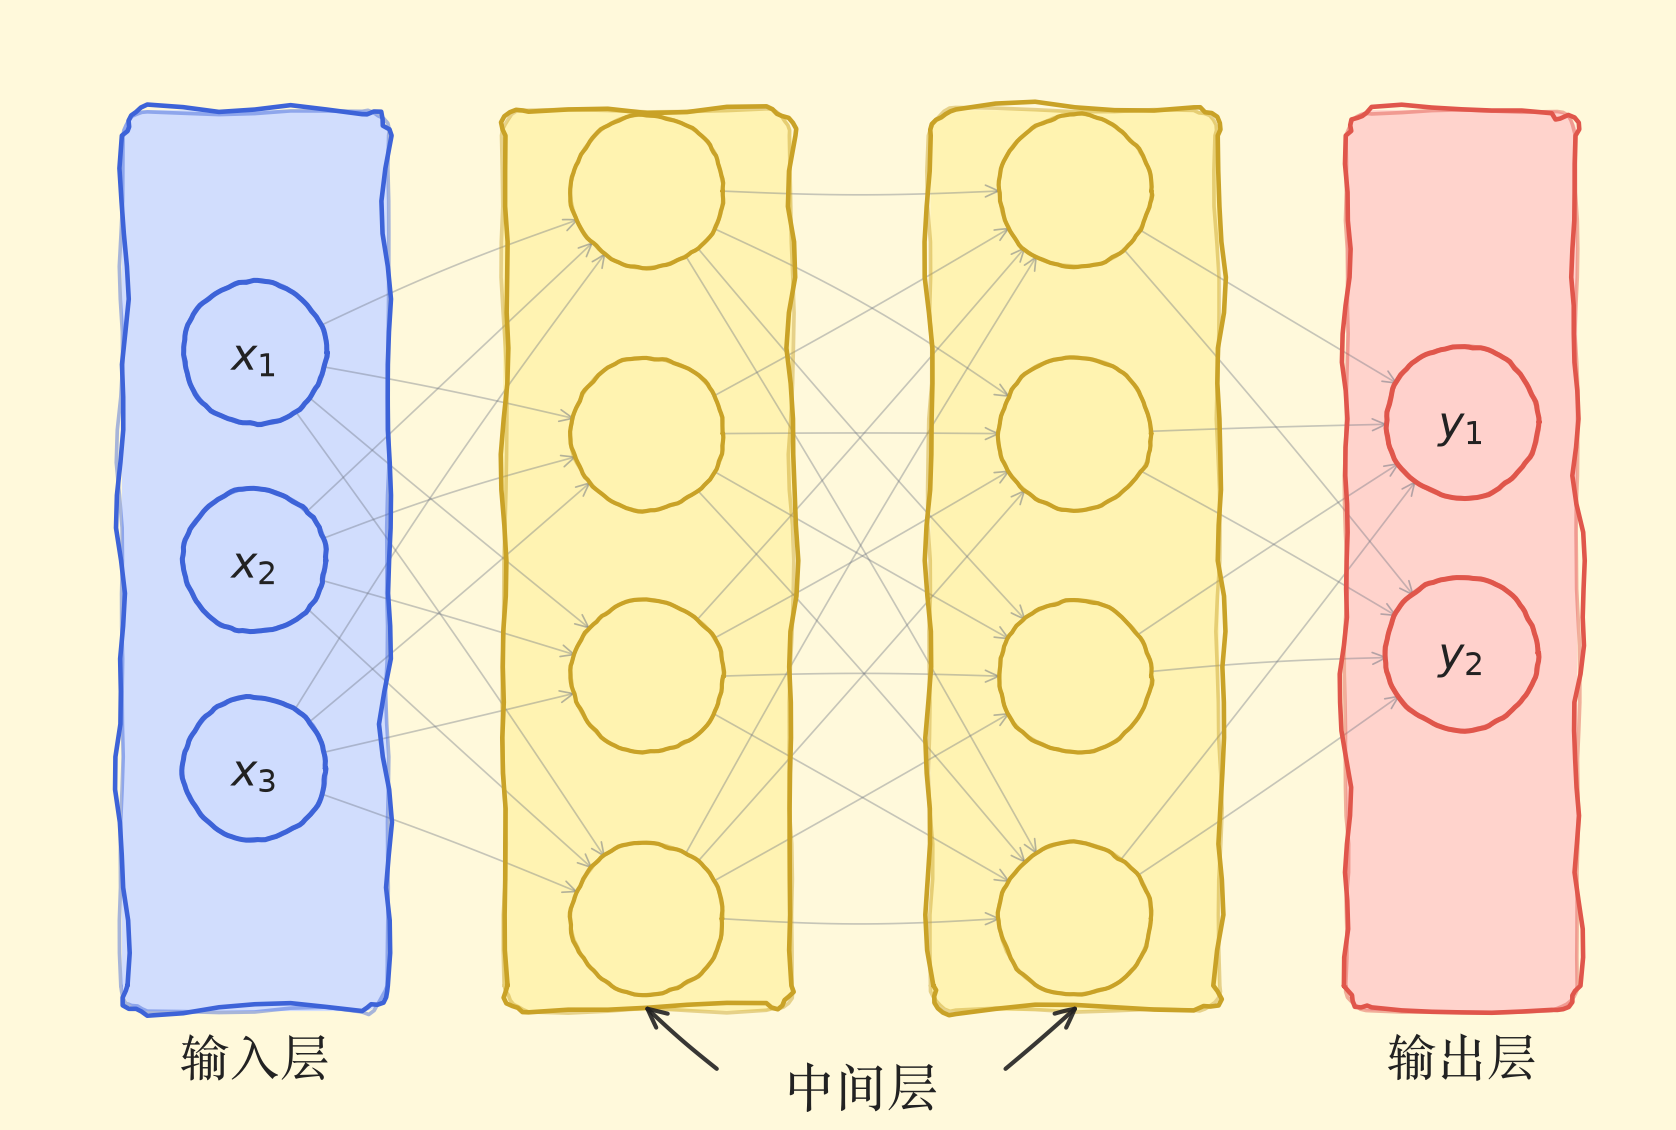
使用多个神经元就可以构建多层神经网络:
- 最左边的一列神经元都表示输入,称为输入层
- 最右边一列表示网络的输出,称为输出层
- 输入层与输出层之间的层统称为中间层(隐藏层)
相邻层的神经元相互连接(图中下一层每个神经元都与上一层所有神经元连接,称为全连接), 每个连接都会有一个权重。神经元中的信息逐层传递(一般称为前向传播forward), 上一层神经元的输出作为下一层神经元的输入。
# 1.3 复习感知机: 神经网络的最小单元
# 1.3.1 感知机的定义
先复习一下Day7学过的感知机。感知机(Perceptron)是二分类模型, 接收多个信号,输出一个信号。感知机的信号只有0、1两种取值,正好对应生物神经元的"放电/不放电"。
下图是一个接收两个输入信号的感知机的例子:
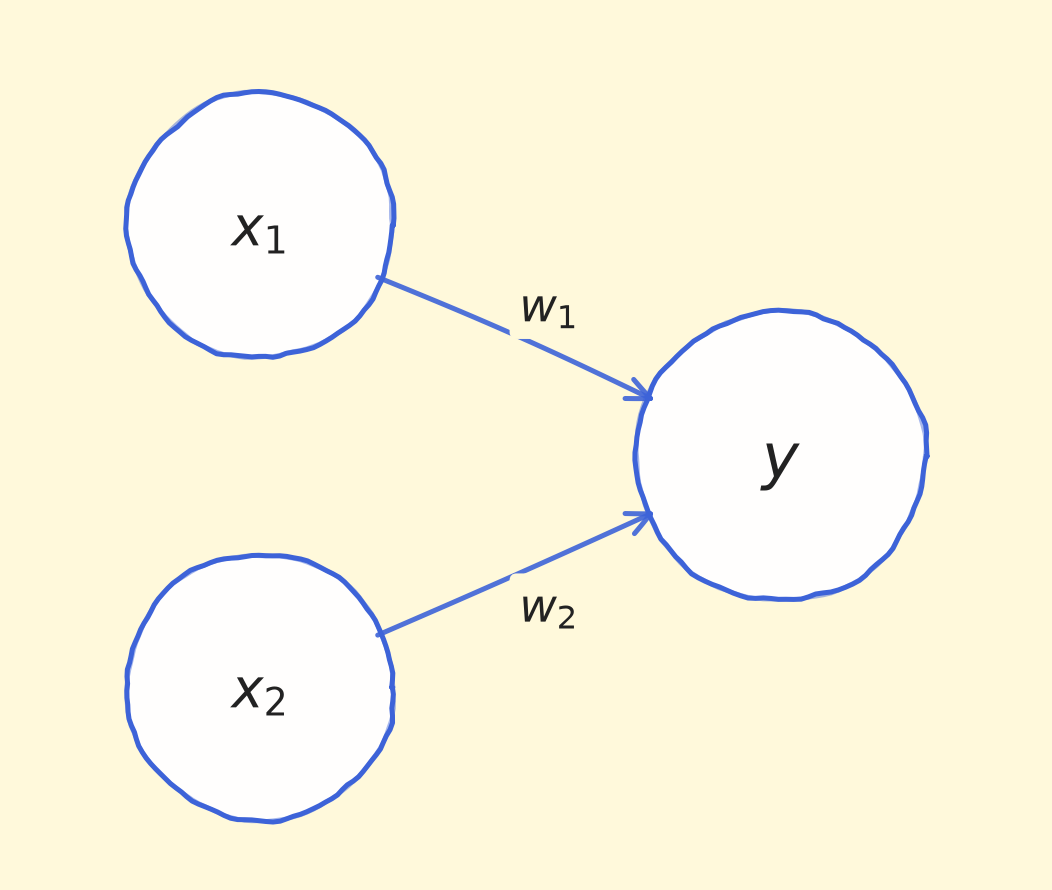
图中左侧两个圆圈是输入信号,右侧圆圈是输出信号,连接线上的是权重。在神经网络示意图中,这样的圆圈统称为神经元(neuron)或节点(node)——它是最基本的信号处理单元。输入信号沿连线送入神经元时,会先分别乘以各自连线上的权重;神经元再把这些加权后的信号求总和,只有当总和超过某个界限值时才输出1,这称为神经元被激活。用数学公式表示:
这里将界限的阈值设为0。除了权重之外,还增加了一个参数, 被称为偏置(bias)。
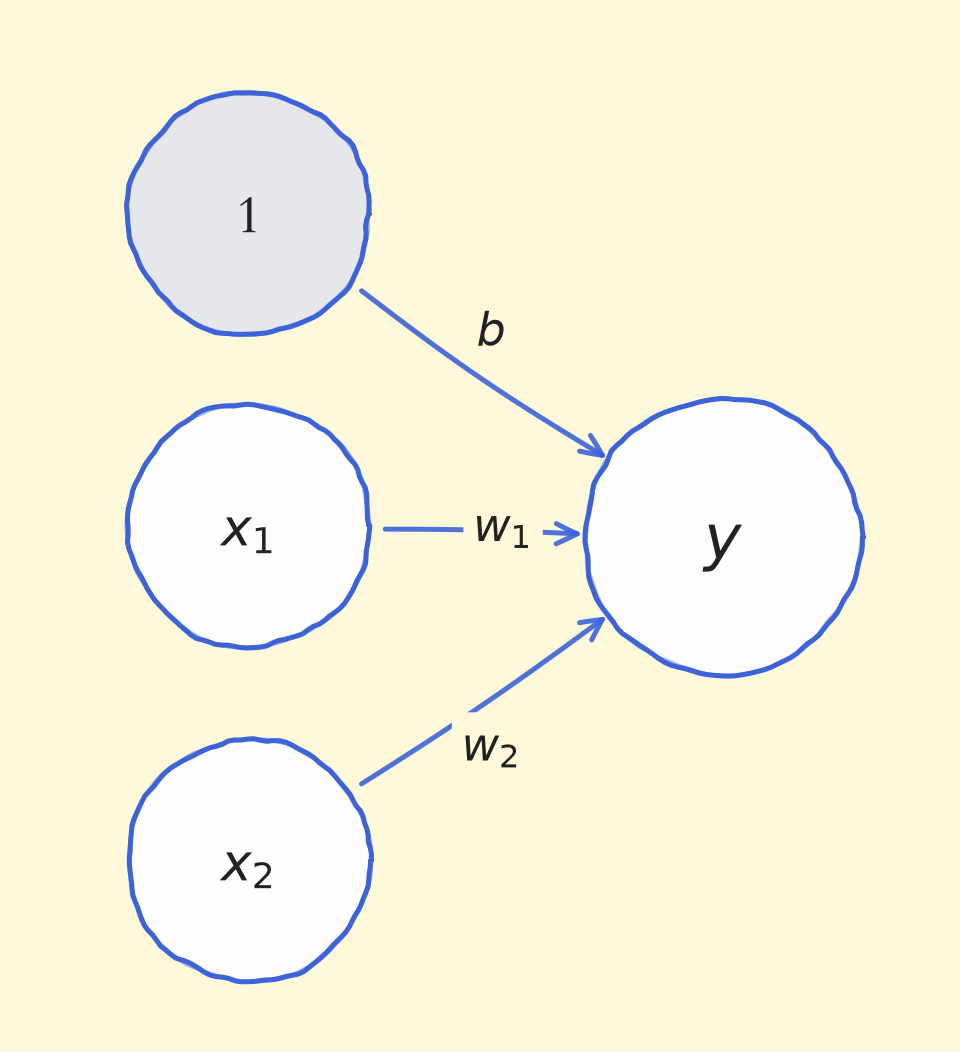
权重和偏置各管一件事: 感知机的多个输入信号都有各自的权重,这些权重发挥着控制各个信号的重要性的作用,权重越大,对应信号的重要性越高; 偏置则可以用来控制神经元被激活的容易程度——偏置越大,加权总和越容易超过0,神经元越容易被激活。
# 1.3.2 代码验证: 用感知机实现与门和或门
光看公式不直观,用NumPy把式(2.1)实现出来,顺便感受"偏置控制激活容易程度"——权重不动、只改偏置,同一个感知机就从与门变成或门:
import numpy as np

def step(x):
    """阶跃函数: x>0 输出1, 否则输出0"""
    return np.where(x > 0, 1, 0)

def perceptron(x1, x2, w1, w2, b):
    """感知机: 先加权求和, 再判断总和是否超过阈值0"""
    a = b + w1 * x1 + w2 * x2   # 加权总和
    return step(a)              # 超过阈值输出1, 否则输出0

# 与门(AND): 两个输入都为1才输出1
w1, w2, b = 0.5, 0.5, -0.7
print("与门 AND (w1=0.5, w2=0.5, b=-0.7):")
for x1, x2 in [(0, 0), (0, 1), (1, 0), (1, 1)]:
    print(f"  x1={x1}, x2={x2} -> y={perceptron(x1, x2, w1, w2, b)}")

# 权重不变, 只把偏置从-0.7调到-0.2, 就变成或门(OR): 任意输入为1就输出1
w1, w2, b = 0.5, 0.5, -0.2
print("\n或门 OR (w1=0.5, w2=0.5, b=-0.2):")
for x1, x2 in [(0, 0), (0, 1), (1, 0), (1, 1)]:
    print(f"  x1={x1}, x2={x2} -> y={perceptron(x1, x2, w1, w2, b)}")
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
与门 AND (w1=0.5, w2=0.5, b=-0.7):
  x1=0, x2=0 -> y=0
  x1=0, x2=1 -> y=0
  x1=1, x2=0 -> y=0
  x1=1, x2=1 -> y=1

或门 OR (w1=0.5, w2=0.5, b=-0.2):
  x1=0, x2=0 -> y=0
  x1=0, x2=1 -> y=1
  x1=1, x2=0 -> y=1
  x1=1, x2=1 -> y=1
2
3
4
5
6
7
8
9
10
11
两个结论一眼可见: ① 权重始终不变,两个输入地位同等重要; ② 只把偏置从-0.7调到-0.2,神经元就从"两个输入都为1才激活"(与门)变成"任意一个输入为1就激活"(或门)——这就是"偏置控制激活容易程度"最直接的体现。
# 1.3.3 异或门: 单层感知机解不了, 多层来救
AND、OR都能调出来,那**异或门(XOR,两个输入不同时输出1)**呢?先看几何直觉:
感知机在平面上是一条直线。AND、OR的正样本点都能用一条直线和负样本分开(线性可分);而XOR的正样本是、两个对角点——任何一条直线都无法把它们和、分开,这就是线性不可分问题。结论很关键: 单层感知机只能表示线性可分问题,权重和偏置再怎么调也救不了(这也是1969年Minsky《感知机》一书指出、曾让神经网络研究陷入寒冬的著名局限)。
出路不是找更聪明的直线,而是多叠一层。先观察: 只要把权重符号反过来,与门就变成与非门(NAND,只要不同时为1就输出1);再把NAND和OR的输出喂给一个AND,XOR就被组合出来了——这正是一个两层(多层)感知机:
def AND(x1, x2):
    # 与门: 两个输入都为1才输出1
    return perceptron(x1, x2, 0.5, 0.5, -0.7)

def NAND(x1, x2):
    # 与非门: 权重取AND的相反数, 偏置取相反数
    return perceptron(x1, x2, -0.5, -0.5, 0.7)

def OR(x1, x2):
    # 或门: 权重不变, 偏置从-0.7调到-0.2
    return perceptron(x1, x2, 0.5, 0.5, -0.2)

def XOR(x1, x2):
    # 第1层: NAND和OR各自看原始输入; 第2层: AND组合两个中间结果
    s1 = NAND(x1, x2)
    s2 = OR(x1, x2)
    return AND(s1, s2)

print("异或门 XOR (两层感知机: NAND+OR -> AND):")
for x1, x2 in [(0, 0), (0, 1), (1, 0), (1, 1)]:
    print(f"  x1={x1}, x2={x2} -> NAND={NAND(x1, x2)}, OR={OR(x1, x2)}, XOR={XOR(x1, x2)}")
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
异或门 XOR (两层感知机: NAND+OR -> AND):
  x1=0, x2=0 -> NAND=1, OR=0, XOR=0
  x1=0, x2=1 -> NAND=1, OR=1, XOR=1
  x1=1, x2=0 -> NAND=1, OR=1, XOR=1
  x1=1, x2=1 -> NAND=0, OR=1, XOR=0
2
3
4
5
几何上发生了什么?第一层的NAND和OR各自用一条直线把平面切开,相当于把输入空间弯成/折成两块区域;第二层再用一条直线在"弯折后的空间"里划分,就等价于在原平面上画出了折线形的决策边界。这就是多层神经网络的全部意义的雏形: 单层画直线,多层(配合非线性激活)可以任意弯折决策边界。理论上,只要隐藏层神经元足够多,多层网络可以逼近任意连续函数(通用近似定理,后续章节还会见面)。
注意: 这里的权重还是手工指定的。XOR告诉我们"多层结构有能力",但没回答"权重从哪来"——那要等到Day18反向传播才彻底解决。
# 1.4 引入激活函数: 把"两步处理"显式拆开
# 1.4.1 从式(2.1)到h(x)
再回头看式(2.1), 它其实包含了两步处理操作:
- 先按照输入各自的权重及偏置,计算出一个加权总和
- 再根据这个总和与阈值的大小关系,决定输出0还是1
如果定义一个函数:
那么式(2.1)就可以简化为:
# 1.4.2 显式拆成两步
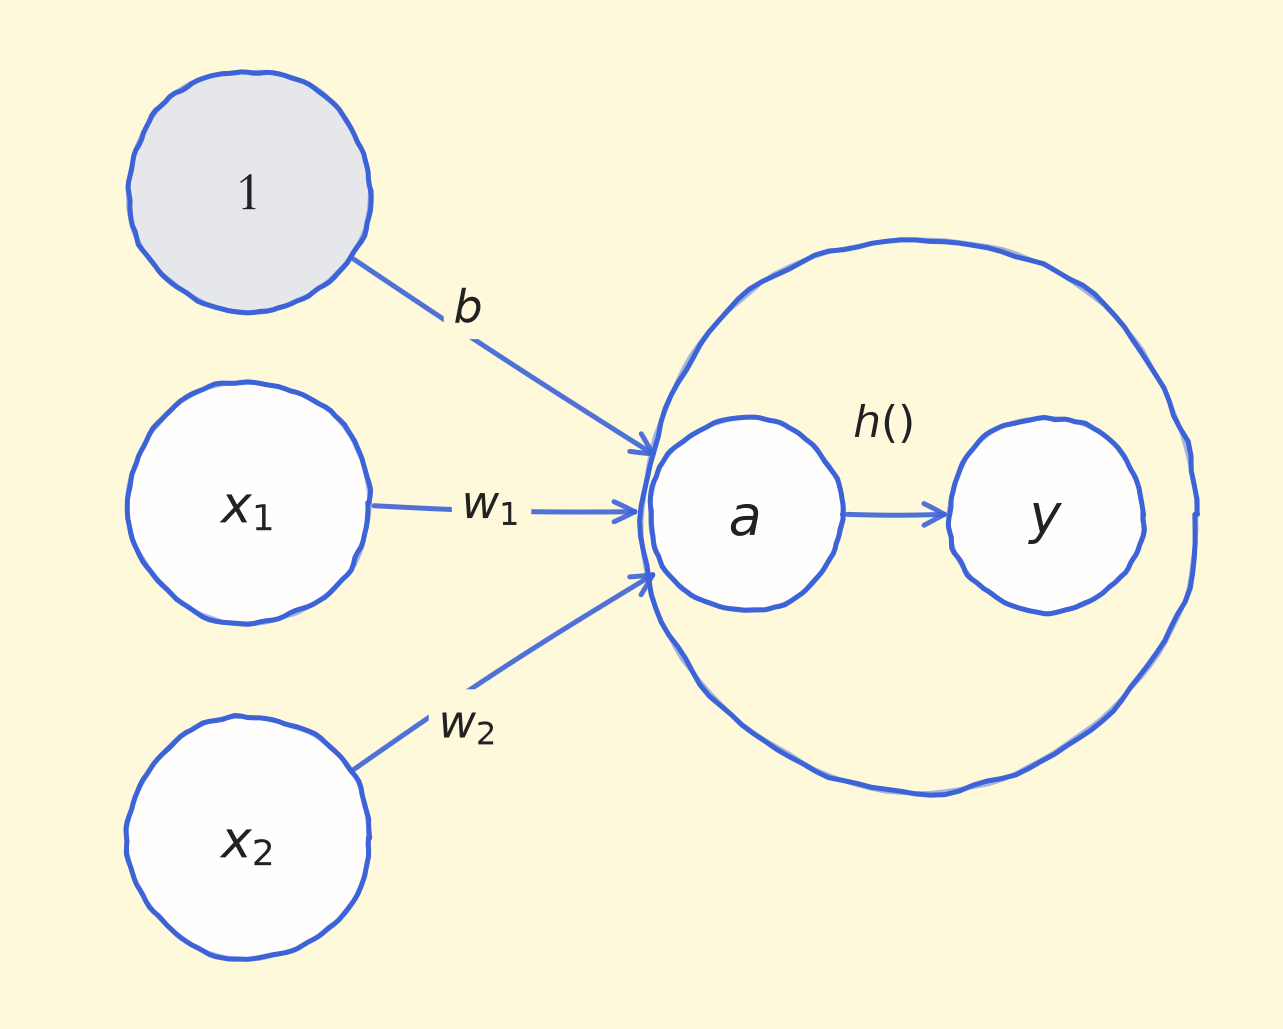
为了更明显地表示出两个处理步骤,可以进一步写成:
这里,我们将输入信号和偏置的加权总和记作。
可以将输入信号的加权总和转换为输出信号,起到"激活神经元"的作用,所以被称为激活函数(activation function)。
1.3.2节代码里的step函数和perceptron函数,正是式(2.4)、(2.5)的直接翻译——先算, 再过。这里用的是阶跃函数, 输出只有0和1,比较粗糙。一旦把它换成sigmoid、ReLU等更平滑的激活函数,感知机就升级成了真正的神经元,再层层堆叠就是多层神经网络——这正是明天要讲的内容。
# 1.5 激活函数的作用
激活函数是连接感知机和神经网络的桥梁, 在神经网络中起着至关重要的作用。
如果没有激活函数, 整个神经网络就等效于单层线性变换, 不论如何加深层数, 总是存在与之等效的"无隐藏层的神经网络"。激活函数必须是非线性函数, 也正是激活函数的存在为神经网络引入了非线性, 使得神经网络能够学习和表示复杂的非线性关系。
# 1.6 阶跃(Binary step)函数
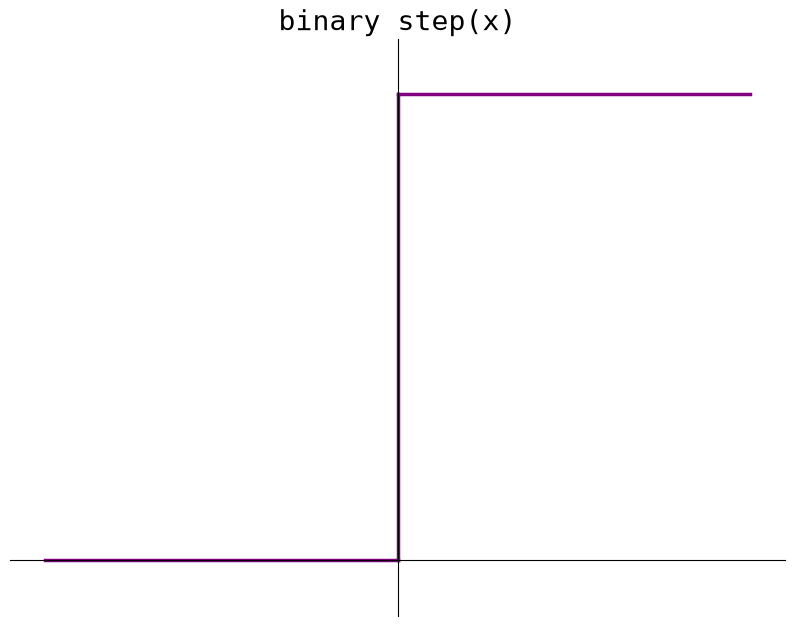
之前的感知机中, 式(2.2)表示的 就是最简单的激活函数, 它可以为输入设置一个"阈值"; 一旦超过这个阈值, 就切换输出(0或者1)。这种函数被称为"阶跃函数"。
阶跃函数的导数恒为0。
import numpy as np  # 统一在文首导入一次, 后文代码直接使用 np

def step_function_scalar(x):
    if x > 0:
        return 1
    else:
        return 0

# 标量测试
print("阶跃(标量):", step_function_scalar(3.0), step_function_scalar(-1.0))
2
3
4
5
6
7
8
9
10
阶跃(标量): 1 0
这里的 只能取一个数值(浮点数)。如果我们希望直接传入Numpy数组进行批量化的操作, 可以改进如下:
def step_function(x):
    return np.array(x > 0, dtype=int)

print("阶跃(批量):", step_function(np.array([-1.0, 0.0, 1.0, 2.0])))
2
3
4
阶跃(批量): [0 0 1 1]
把曲线画出来更直观。让坐标轴在原点交叉、隐藏上右边框, 就得到文中配图的样式:
import matplotlib.pyplot as plt  # 首次画图时导入一次, 后文直接使用 plt

x = np.arange(-5.0, 5.0, 0.01)
y = step_function(x)  # 复用上面定义的阶跃函数

fig, ax = plt.subplots(figsize=(8, 5))
ax.plot(x, y, color="#800080", lw=2.5)
# 让左、下两条坐标轴在(0,0)处交叉, 隐藏上、右边框
ax.spines["left"].set_position(("data", 0))
ax.spines["bottom"].set_position(("data", 0))
ax.spines["right"].set_visible(False)
ax.spines["top"].set_visible(False)
ax.set_title("binary step(x)", fontsize=14, family="monospace")
ax.set_ylim(-0.1, 1.1)  # 上下留白, 避免曲线贴边
plt.show()
2
3
4
5
6
7
8
9
10
11
12
13
14
15
为什么阶跃函数很快被淘汰? 因为它在 处不可导, 导数处处为0——这意味着梯度下降完全无法更新参数。它是感知机时代的遗产, 为后来的平滑激活函数铺了路。
# 1.7 Sigmoid函数
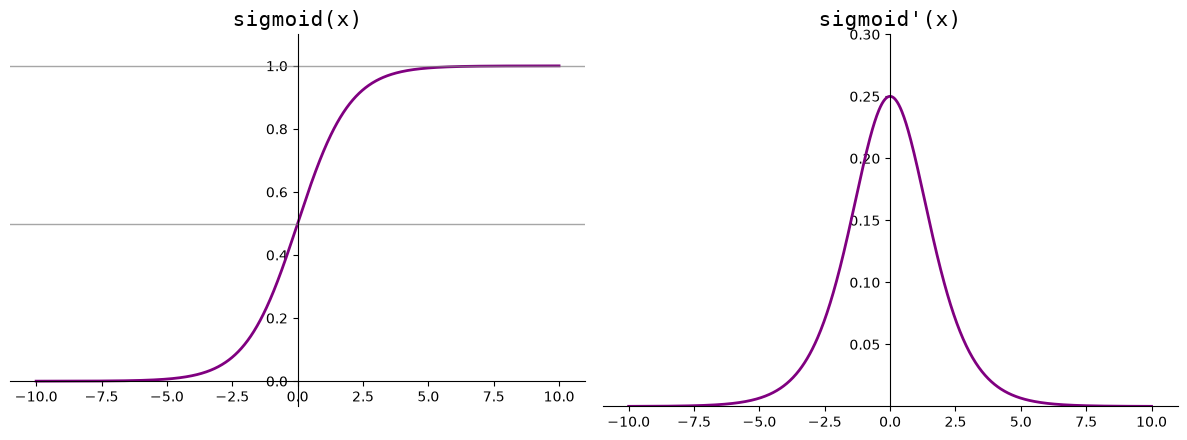
Sigmoid(也叫Logistic函数)是平滑的、可微的, 能将任意输入映射到区间(0,1)。常用于二分类的输出层。但因其涉及指数运算, 计算量相对较高。
Sigmoid的输入在 之外时, 其输出值变化很小, 可能导致信息丢失。
Sigmoid的输出并非以0为中心, 其输出值均大于0, 导致后续层的输入始终为正, 可能影响后续梯度更新方向。
Sigmoid的导数范围为(0,0.25), 梯度较小。当输入在 之外时, 导数接近0, 此时网络参数的更新将会极其缓慢。使用Sigmoid作为激活函数, 可能出现梯度消失(在逐层反向传播时, 梯度会呈指数级衰减)。
def sigmoid(x):
    return 1 / (1 + np.exp(-x))

x = np.array([-6.0, -2.0, 0.0, 2.0, 6.0])
print("Sigmoid输出:", np.round(sigmoid(x), 4))
print("Sigmoid导数:", np.round(sigmoid(x) * (1 - sigmoid(x)), 4))
2
3
4
5
6
Sigmoid输出: [0.0025 0.1192 0.5    0.8808 0.9975]
Sigmoid导数: [0.0025 0.105   0.25   0.105   0.0025]
2
光看数值还不够, 把曲线画出来才直观。先封装一个通用绘图函数, 后面所有激活函数都复用它——传入函数画单条曲线, 再传入导数则左右并排画 和 :
PURPLE = "#800080"  # 与本文配图一致的紫色

def plot_activation(name, f, df=None, xlim=(-5.0, 5.0),
                    ylim=(-0.1, 1.1), dylim=(-0.05, 0.3), grid=False):
    """绘制激活函数曲线; 传入 df 时, 左右两张子图分别画 f(x) 与 f'(x)。"""
    x = np.arange(xlim[0], xlim[1], 0.01)
    if df is None:
        fig, axes = plt.subplots(figsize=(8, 5))
        axes = [axes]
    else:
        fig, axes = plt.subplots(1, 2, figsize=(13, 4.5))

    def draw(ax, y, title, yl):
        ax.plot(x, y, color=PURPLE, lw=2.5)
        ax.spines["left"].set_position(("data", 0))   # 坐标轴在原点交叉
        ax.spines["bottom"].set_position(("data", 0))
        ax.spines["right"].set_visible(False)
        ax.spines["top"].set_visible(False)
        ax.set_title(title, fontsize=22, family="monospace")
        ax.set_ylim(*yl)
        if grid:
            ax.grid(axis="y", color="0.7")

    draw(axes[0], f(x), f"{name}(x)", ylim)
    if df is not None:
        draw(axes[1], df(x), f"{name}'(x)", dylim)
    plt.tight_layout()
    plt.show()

def sigmoid(x):
    return 1 / (1 + np.exp(-x))

# 输出压在(0,1); 导数是钟形, 最大只有0.25, 两侧迅速趋于0
# df=lambda t: sigmoid(t)*(1-sigmoid(t)):匿名函数,sigmoid 导数公式(sigma'(t)=sigma(t)(1-sigma(t)))
plot_activation(
    "sigmoid", sigmoid, lambda t: sigmoid(t) * (1 - sigmoid(t)),
    xlim=(-10, 10), ylim=(-0.05, 1.1), dylim=(-0.01, 0.30), grid=True)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
Sigmoid的核心矛盾: 它把输出压缩到(0,1)的直觉很好(概率!), 但导数最大只有0.25。如果网络有10层Sigmoid, 反向传播的梯度要连乘10个0.25, 最终只剩下约 ——参数几乎不更新。这是深度学习早期最大的绊脚石。
# 1.8 Tanh函数
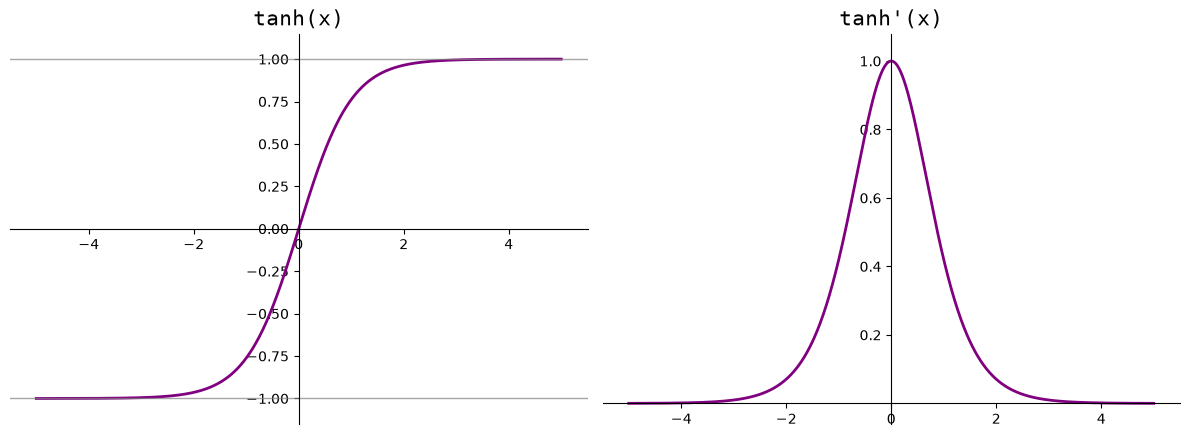
Tanh(双曲正切)将输入映射到区间(-1,1)。其关于原点中心对称。常用在隐藏层。
输入在 之外时, Tanh的输出值变化很小, 此时其导数接近0。
Tanh的输出以0为中心, 且其梯度相较于Sigmoid更大, 收敛速度相对更快。但同样也存在梯度消失现象。
def tanh(x):
    return np.tanh(x)

x = np.array([-3.0, -1.0, 0.0, 1.0, 3.0])
print("Tanh输出:", np.round(tanh(x), 4))
print("Tanh导数:", np.round(1 - tanh(x)**2, 4))
2
3
4
5
6
Tanh输出: [-0.9951 -0.7616  0.      0.7616  0.9951]
Tanh导数: [0.0099 0.42   1.     0.42   0.0099]
2
复用上面的plot_activation画出Tanh及其导数——输出压在 且关于原点对称, 导数最大值为1, 明显比Sigmoid的0.25"健康":
# 1 - tanh^2(x) 即 Tanh 的导数
plot_activation(
    "tanh", np.tanh, lambda t: 1 - np.tanh(t) ** 2,
    xlim=(-5, 5), ylim=(-1.15, 1.15), dylim=(-0.05, 1.05), grid=True)
2
3
4
Tanh相比Sigmoid的进步: 输出均值为0, 让下一层的输入分布更对称, 梯度方向更稳定。但本质上仍是饱和函数——输入一旦远离0, 导数就趋于0, 梯度消失的诅咒没有解除。
# 1.9 ReLU函数
注意: 时ReLU函数不可导, 此时我们默认使用左侧的函数。
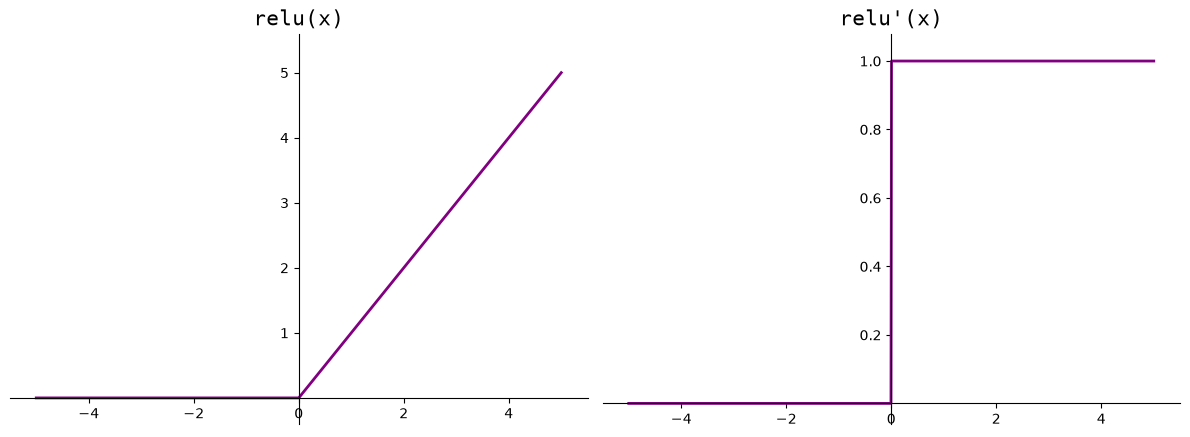
ReLU(Rectified Linear Unit, 修正线性单元)会将小于0的输入转换为0, 大于等于0的输入则保持不变。ReLU定义简单, 计算量小。常用于隐藏层。
ReLU作为激活函数不存在梯度消失。当输入小于0时, ReLU的输出为0, 这意味着在神经网络中, ReLU激活的节点只有部分是"活跃"的, 这种稀疏性有助于减少计算量和提高模型的效率。
当神经元的输入持续为负数时, ReLU的输出始终为0。这意味着神经元可能永远不会被激活, 从而导致"神经元死亡"问题。这会影响模型的学习能力, 特别是如果大量的神经元都变成了"死神经元"。为解决此问题, 可使用Leaky ReLU来代替ReLU作为激活函数。Leaky ReLU在负数区域引入一个小的斜率来解决"神经元死亡"问题。
def relu(x):
    return np.maximum(0, x)

x = np.array([-2.0, -0.5, 0.0, 1.0, 3.0])
print("ReLU输出:", relu(x))
print("ReLU导数:", np.where(x > 0, 1, 0))
2
3
4
5
6
ReLU输出: [0.  0.  0.  1.  3. ]
ReLU导数: [0 0 0 1 1]
2
同样画出ReLU及其导数: 负区输出和导数都恒为0, 正区是一条斜率恒为1的直线——这正是"死神经元"和"无梯度消失"这对矛盾的几何来源:
def relu(x):
    return np.maximum(0, x)

# 左图负区贴0、正区为y=x; 右图导数在0处"跳变", 负区0、正区1
plot_activation(
    "relu", relu, lambda t: np.where(t > 0, 1, 0),
    xlim=(-5, 5), ylim=(-0.5, 5.5), dylim=(-0.1, 1.1))
2
3
4
5
6
7
ReLU为什么统治了深度学习? ① 计算极简, 没有指数运算; ② 正区间导数恒为1, 彻底解决了Sigmoid/Tanh的梯度消失; ③ 天然的稀疏性, 让网络更高效。但它有个致命弱点——"死神经元": 一旦某神经元在训练初期学到负的偏置, 它以后就永远是0, 再也无法更新。2012年AlexNet用ReLU打赢ImageNet, 靠的是足够大的学习率和初始化技巧, 让神经元尽量不死。后来的变体(Leaky ReLU、PReLU、ELU)都是围绕这个问题在打补丁。
# 1.10 Softmax函数
Softmax将一个任意的实数向量转换为一个概率分布, 确保输出值的总和为1, 是二分类激活函数Sigmoid在多分类上的推广。Softmax常用于多分类问题的输出层, 用来表示类别的预测概率。
Softmax会放大输入中较大的值, 使得最大输入值对应的输出概率较大, 其他较小的值会被压缩。即在类别之间起到了一定的区分作用。
def softmax(x):
    if x.ndim == 2:
        x = x.T
        x = x - np.max(x, axis=0)
        y = np.exp(x) / np.sum(np.exp(x), axis=0)
        return y.T

    x = x - np.max(x)  # 溢出对策
    return np.exp(x) / np.sum(np.exp(x))

# 一维示例
a = np.array([1, 3, 5, 10])
print("Softmax [1,3,5,10]:", np.round(softmax(a), 6))
print("概率和:", np.sum(softmax(a)))

# 二维示例(模拟batch)
b = np.array([[1, 3, 5, 10], [0.5, 0.2, 0.1, -1.0]])
print("\nSoftmax 2D:")
print(np.round(softmax(b), 4))
print("每行和:", softmax(b).sum(axis=1))

# 溢出安全验证: 大数值输入
big = np.array([1000, 1001, 1002])
print("\n大数值Softmax:", np.round(softmax(big), 4))
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
Softmax [1,3,5,10]: [1.22000e-04 9.05000e-04 6.68600e-03 9.92287e-01]
概率和: 1.0

Softmax 2D:
[[1.000e-04 9.000e-04 6.700e-03 9.923e-01]
 [3.796e-01 2.812e-01 2.545e-01 8.470e-02]]
每行和: [1. 1.]

大数值Softmax: [0.09   0.2447 0.6652]
2
3
4
5
6
7
8
9
Softmax的本质: 它是Sigmoid从"二选一"到"n选一"的推广。输入中10虽然只比5大2倍, 但Softmax后它的概率是5的148倍——这种"赢者通吃"的特性, 让它在分类任务中特别有效。但注意, 数值稳定性是工程重点: 如果不先做 , 像 会直接溢出变成inf。
# 1.11 其他常见激活函数
除了上面五个"主将", 激活函数家族还有一大批针对特定问题优化的变体。它们大多是为了解决ReLU的死神经元问题, 或者让曲线更平滑、让梯度更健康。下面各变体的曲线图都复用1.3节定义的plot_activation函数, 只需给出函数表达式和坐标范围即可。
# 1.11.1 Identity(恒等函数)
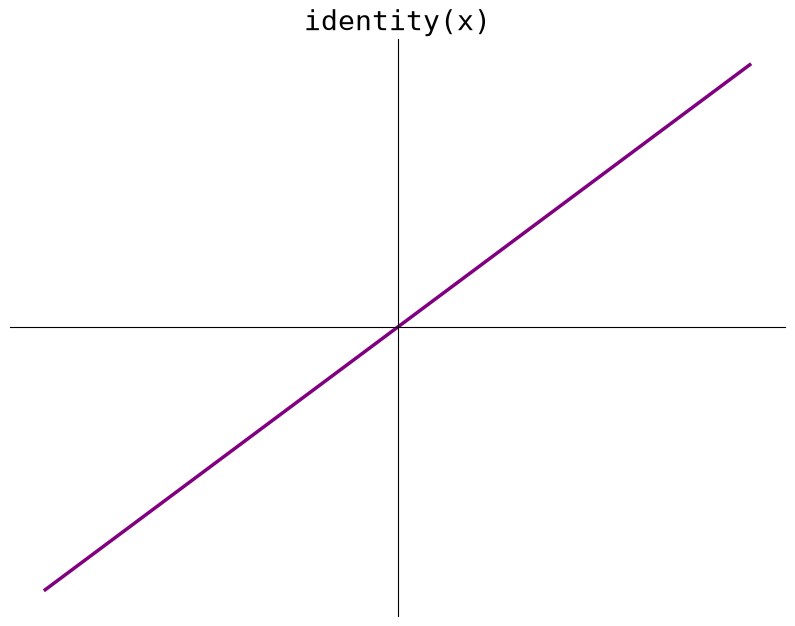
Identity就是"不激活", 输入原样输出。它的唯一作用场景是回归问题的输出层: 房价预测、温度预测等连续值输出, 不需要任何压缩, 线性输出即可。
def identity(x):
    return x

print("Identity:", identity(np.array([-2.0, 0.0, 3.5])))
2
3
4
Identity: [-2. 0. 3.5]
画出来就是一条穿过原点、斜率恒为1的直线, 不做任何压缩:
plot_activation("identity", lambda t: t, xlim=(-5, 5), ylim=(-5.5, 5.5))
# 1.11.2 Leaky ReLU(Leaky Rectified Linear Unit)
其中 是一个很小的常数(通常取0.01)。
def leaky_relu(x, alpha=0.01):
    return np.where(x > 0, x, alpha * x)

x = np.array([-3.0, -1.0, 0.0, 2.0])
print("Leaky ReLU(α=0.01):", leaky_relu(x))
print("Leaky ReLU导数:", np.where(x > 0, 1, 0.01))
2
3
4
5
6
Leaky ReLU(α=0.01): [-0.03 -0.01  0.    2.  ]
Leaky ReLU导数: [0.01 0.01 0.01 1.  ]
2
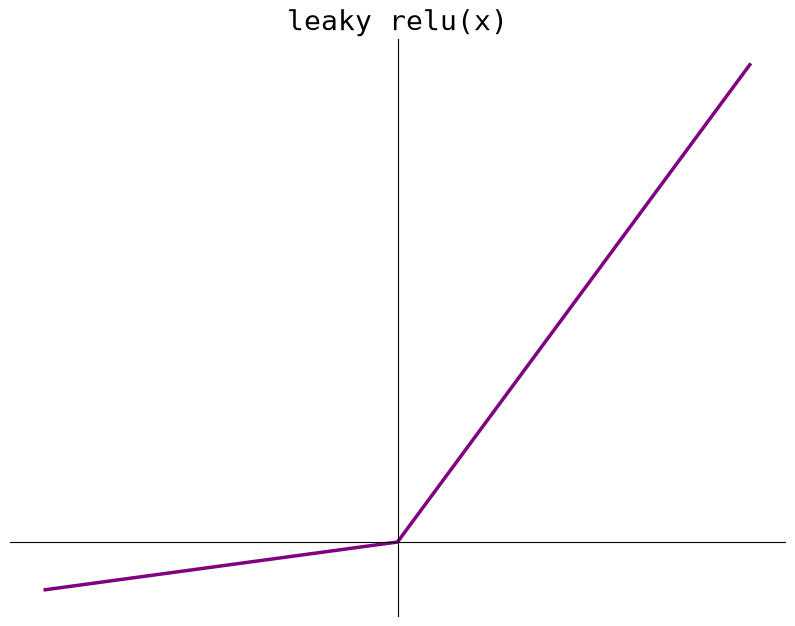
图上负区几乎贴着 轴( 时输出只有-0.05), 但这条"小缝隙"保证了负区梯度不再恒为0:
def leaky_relu(x, alpha=0.1):
    return np.where(x > 0, x, alpha * x)

plot_activation("leaky relu", leaky_relu, xlim=(-5, 5), ylim=(-5.5, 5.5))
2
3
4
Leaky ReLU的直觉: ReLU在负数区一刀切断(导数为0), 导致神经元死亡; Leaky ReLU给负数区留了一条"小缝隙"(斜率0.01), 让负输入也能产生微弱的梯度, 有机会"复活"。
# 1.11.3 PReLU(Parametric Rectified Linear Unit)
这里 是一个可训练的参数, 而非固定的常数。
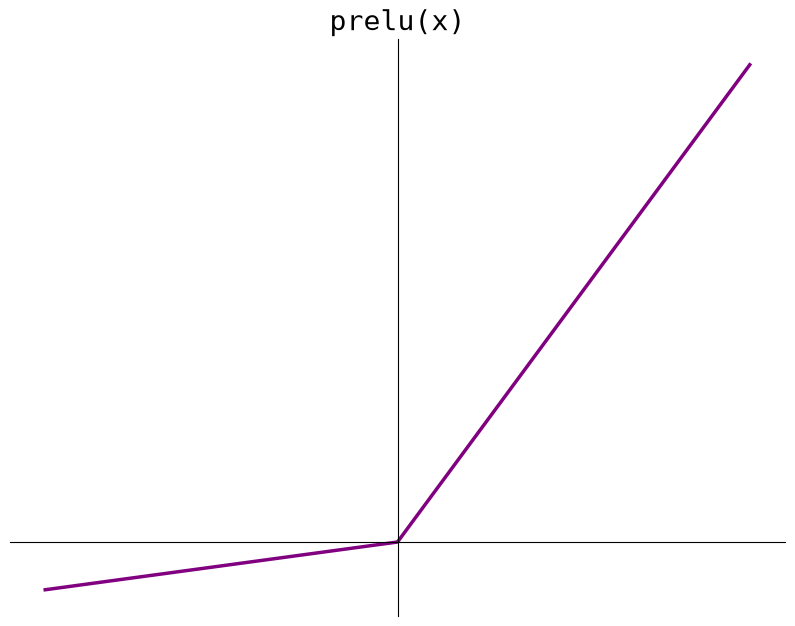
PReLU的核心思想: 与其人工设定 , 不如让网络自己学。每个神经元甚至每个通道都可以学到一个最优的 。代价是参数量微增, 但效果通常比Leaky ReLU更好。Kaiming He的PReLU论文正是ResNet的前身。
绘图时代入一个具体的 即可, 下面取论文中的典型初始值0.25——可以看到负区斜率明显比Leaky ReLU大:
plot_activation("prelu", lambda t: np.where(t > 0, t, 0.25 * t),
                xlim=(-5, 5), ylim=(-1.6, 5.5))
2
# 1.11.4 RReLU(Randomized Leaky ReLU)
这里 是一个在训练时从一个均匀分布中随机选择的参数。
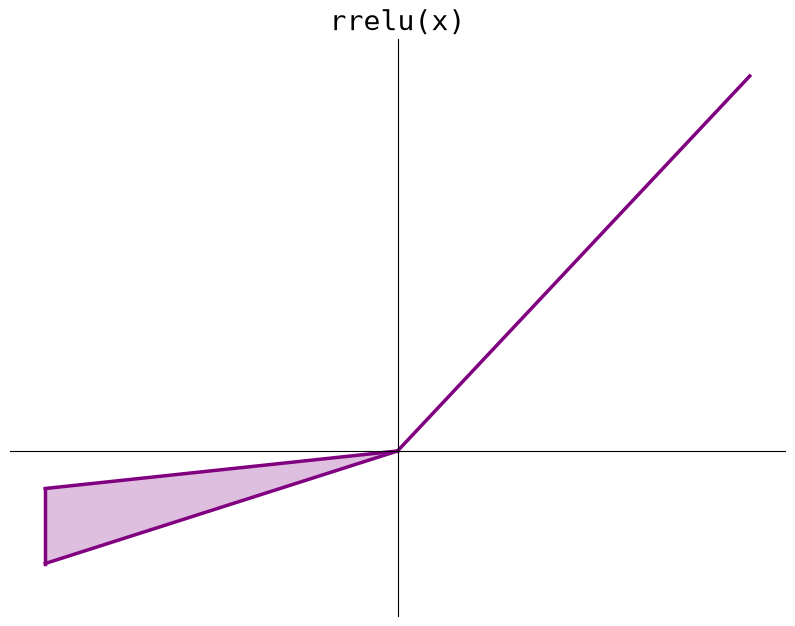
RReLU的角色: 它把Leaky ReLU的固定斜率变成随机采样, 相当于给负数区加了Dropout式的正则化。训练时随机, 测试时取平均。在某些任务上能缓解过拟合。
按RReLU论文, 训练时 从均匀分布 中随机采样。绘图时用fill_between画出整个随机取值带(阴影区), 再画一次采样得到的曲线:
x = np.arange(-5.0, 5.0, 0.01)
lower, upper = 1 / 8, 1 / 3      # α ~ U(1/8, 1/3)

fig, ax = plt.subplots(figsize=(8, 5))
xn = x[x <= 0]
# 阴影: 负区所有可能的随机斜率构成的扇形带
ax.fill_between(xn, lower * xn, upper * xn, color=PURPLE, alpha=0.25)
# 一次前向传播中随机采样一个 α
rng = np.random.default_rng(0)
alpha = rng.uniform(lower, upper)
ax.plot(x, np.where(x > 0, x, alpha * x), color=PURPLE, lw=2.5)
ax.spines["left"].set_position(("data", 0))
ax.spines["bottom"].set_position(("data", 0))
ax.spines["right"].set_visible(False)
ax.spines["top"].set_visible(False)
ax.set_title("rrelu(x)", fontsize=22, family="monospace")
ax.set_ylim(-5.5, 5.5)
plt.show()
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
# 1.11.5 ELU(Exponential Linear Unit)
def elu(x, alpha=1.0):
    return np.where(x > 0, x, alpha * (np.exp(x) - 1))

x = np.array([-2.0, -1.0, 0.0, 1.0])
print("ELU(α=1.0):", np.round(elu(x), 4))
2
3
4
5
ELU(α=1.0): [-0.8647 -0.6321 0. 1. ]
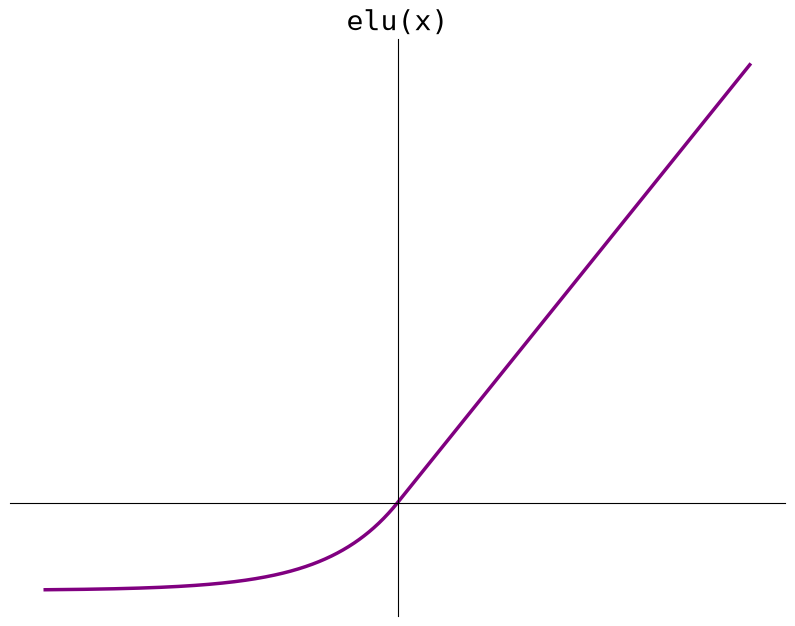
ELU的优势: ① 负数区平滑过渡到 , 输出均值更接近0, 缓解内部协变量偏移; ② 不像ReLU族那样在0点有"拐角", 梯度更平滑。代价是多了指数运算, 比ReLU慢。
曲线图上能清楚看到这两点: 正区与 重合, 负区没有尖角、平滑地弯向水平渐近线 :
def elu(x, alpha=1.0):
    return np.where(x > 0, x, alpha * (np.exp(x) - 1))

plot_activation("elu", elu, xlim=(-5, 5), ylim=(-1.6, 5.5))
2
3
4
# 1.11.6 Swish(也称Sigmoid Linear Unit, SiLU)
def swish(x):
    return x / (1 + np.exp(-x))

x = np.array([-3.0, -1.0, 0.0, 1.0, 3.0])
print("Swish:", np.round(swish(x), 4))
2
3
4
5
Swish: [-0.1423 -0.2689 0. 0.7311 2.8577]
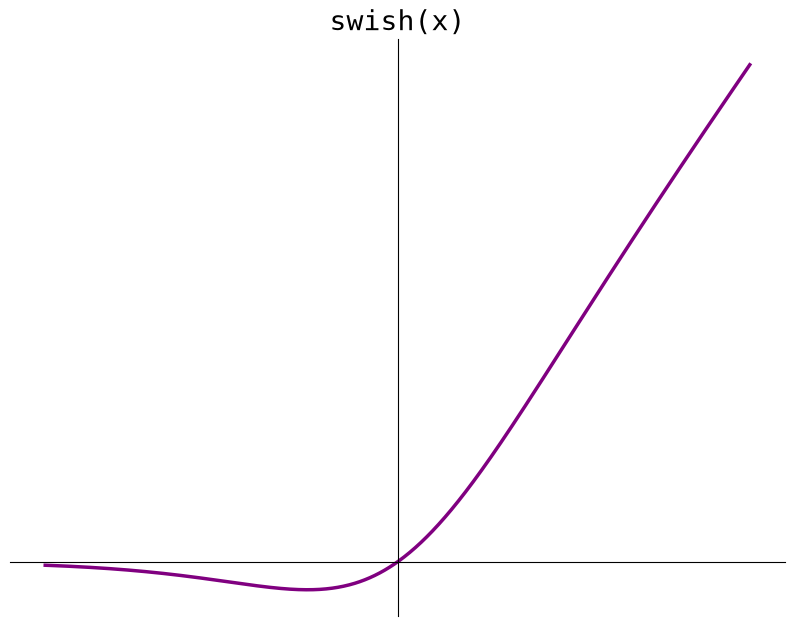
Swish的故事: Google用强化学习自动搜索最优激活函数, 搜出来的结果和Swish高度相似——这说明Swish是"数据驱动"得到的最优解之一。它的特点是负数区非单调: 先下降后趋于0, 大正数区近似线性。Transformer中的SiLU就是Swish的别名。
把曲线画出来, 负数区那个"先下凹、再回升到0"的小包(最小值约-0.28)就是Swish最显著的特征:
def swish(x):
    return x / (1 + np.exp(-x))

plot_activation("swish", swish, xlim=(-5, 5), ylim=(-0.8, 5.5))
2
3
4
# 1.11.7 Softplus
def softplus(x):
    return np.log(1 + np.exp(x))

x = np.array([-3.0, -1.0, 0.0, 1.0, 3.0])
print("Softplus:", np.round(softplus(x), 4))
2
3
4
5
Softplus: [0.0486 0.3133 0.6931 1.3133 3.0486]
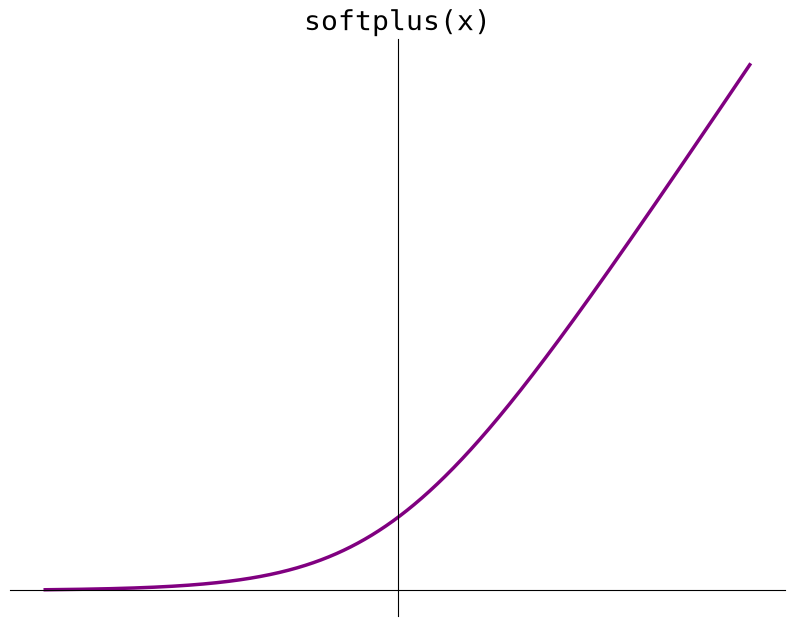
Softplus的优势 它是ReLU的平滑版本——没有0点的尖角, 处处可导, 导数恰好是Sigmoid。在某些需要平滑梯度的优化场景(如变分推断)中有用, 但日常深度学习中很少直接当激活函数用。
绘图时建议用np.logaddexp(0, x)代替np.log(1+np.exp(x)), 二者数学上完全等价, 但前者在 很大时不会因 溢出:
def softplus(x):
    return np.logaddexp(0, x)  # 等价于 ln(1 + e^x), 数值更稳定

plot_activation("softplus", softplus, xlim=(-5, 5), ylim=(-0.5, 5.5))
2
3
4
# 1.12 如何选择激活函数
# 1.12.1 隐藏层
首选ReLU, 如果效果不好可尝试Leaky ReLU等。
Sigmoid在隐藏层易导致梯度消失, 应尽量避免。
Tanh的输出均值为0, 对中心化数据更友好, 但仍可能引发梯度消失, 仅适用于浅层网络。
# 1.12.2 输出层
二分类选择Sigmoid。
多分类选择Softmax。
回归默认选择Identity。
# 小结
从感知机到多层网络,从阶跃到Softmax,今天的非线性引擎已经齐备。但网络搭好了,它凭什么知道自己猜得对不对、又该往哪调参数?Day17手撕一个三层网络跑通前向传播,再引入损失函数和梯度下降,把“学习”这件事真正落地。