
# 勤奋的凯尔森同学10000h刻意练习Day18:反向传播与训练稳定性 —— 从链式法则到梯度消失、初始化与正则化
所属专栏: 凯尔森的10000h刻意练习
Slogan: 一个36岁程序员, 研究生(学硕),前世界500强top20软件开发Java工程师,用10000小时深耕AI, 目标Top10 AI资深工程师, 全程日更记录。
手算梯度太慢,网络一深就扛不住——能不能让网络自己把每一层的梯度算出来?
Day17用数值梯度跑通了梯度下降并搭起了三层网络,但那种"每个参数扰动两次"的算法在多层网络上慢得不可接受。今天先用手写数字识别把SGD的完整闭环走一遍,再引入反向传播——它沿计算图用链式法则把每一层的梯度一次性算出来,是现代深度学习的基石。有了反向传播,网络能训深了;可深度又带来两个问题:梯度在层层连乘中走向消失或爆炸,而SGD本身在狭长损失面上也效率不高。后半节就围绕"稳住训练"展开:先用Momentum、AdaGrad、RMSProp、Adam等更聪明的优化器改进SGD,再用Xavier/He初始化和权值衰减、Dropout、早停、BN等正则化手段把训练稳住。
# 1.1 SGD综合实现:手写数字识别
应用案例:手写数字识别
我们还是考察之前手写数字识别的案例。方便起见,这次只实现一个2层的神经网络(中间只有1个隐藏层、后面是输出层),利用之前的数据集来进行学习,学习方法采用SGD。
首先我们先来实现一个TwoLayerNet类:
import numpy as np

def sigmoid(x):
    return 1 / (1 + np.exp(-x))

def softmax(a):
    a = a - np.max(a, axis=-1, keepdims=True)   # 防溢出
    return np.exp(a) / np.sum(np.exp(a), axis=-1, keepdims=True)

def cross_entropy_error(y, t):
    if y.ndim == 1:
        t = t.reshape(1, t.size)
        y = y.reshape(1, y.size)
    # 监督数据是one-hot向量时, 转为正确解标签索引
    if t.size == y.size:
        t = t.argmax(axis=1)
    batch_size = y.shape[0]
    return -np.sum(np.log(y[np.arange(batch_size), t] + 1e-7)) / batch_size

def numerical_gradient(f, x):
    h = 1e-4
    grad = np.zeros_like(x)
    it = np.nditer(x, flags=['multi_index'], op_flags=['readwrite'])
    while not it.finished:
        idx = it.multi_index
        tmp_val = x[idx]
        x[idx] = float(tmp_val) + h
        fxh1 = f(x)                 # f(x+h)
        x[idx] = tmp_val - h
        fxh2 = f(x)                 # f(x-h)
        grad[idx] = (fxh1 - fxh2) / (2 * h)
        x[idx] = tmp_val            # 还原
        it.iternext()
    return grad

class TwoLayerNet:

    def __init__(self, input_size, hidden_size, output_size, weight_init_std=0.01):
        # 初始化权重
        self.params = {}
        self.params['W1'] = weight_init_std * np.random.randn(input_size, hidden_size)
        self.params['b1'] = np.zeros(hidden_size)
        self.params['W2'] = weight_init_std * np.random.randn(hidden_size, output_size)
        self.params['b2'] = np.zeros(output_size)

    def predict(self, x):
        W1, W2 = self.params['W1'], self.params['W2']
        b1, b2 = self.params['b1'], self.params['b2']

        a1 = np.dot(x, W1) + b1
        z1 = sigmoid(a1)
        a2 = np.dot(z1, W2) + b2
        y = softmax(a2)

        return y

    # x:输入数据, t:监督数据
    def loss(self, x, t):
        y = self.predict(x)

        return cross_entropy_error(y, t)

    def accuracy(self, x, t):
        y = self.predict(x)
        y = np.argmax(y, axis=1)
        if t.ndim != 1:                 # one-hot标签取最大值索引
            t = np.argmax(t, axis=1)

        accuracy = np.sum(y == t) / float(x.shape[0])
        return accuracy

    # x:输入数据, t:监督数据
    def numerical_gradient(self, x, t):
        loss_W = lambda W: self.loss(x, t)

        grads = {}
        grads['W1'] = numerical_gradient(loss_W, self.params['W1'])
        grads['b1'] = numerical_gradient(loss_W, self.params['b1'])
        grads['W2'] = numerical_gradient(loss_W, self.params['W2'])
        grads['b2'] = numerical_gradient(loss_W, self.params['b2'])

        return grads

    def gradient(self, x, t):
        """反向传播求梯度(比numerical_gradient快数百倍)
        numerical_gradient每个参数都要扰动两次跑前向, 784维时每迭代79520次前向;
        反向传播只需一次前向+一次反向, 一次迭代就把所有层的梯度全算出来。
        """
        W1, W2 = self.params['W1'], self.params['W2']
        b1, b2 = self.params['b1'], self.params['b2']
        grads = {}
        batch_num = x.shape[0]

        # 前向传播(保存中间结果供反向使用)
        a1 = np.dot(x, W1) + b1
        z1 = sigmoid(a1)
        a2 = np.dot(z1, W2) + b2
        y = softmax(a2)

        # 反向传播
        # Softmax+交叉熵的合并梯度: y - t (详见1.7节推导)
        dy = (y - t) / batch_num

        # Affine层2: a2 = z1·W2 + b2
        grads['W2'] = np.dot(z1.T, dy)
        grads['b2'] = np.sum(dy, axis=0)
        dz1 = np.dot(dy, W2.T)

        # Sigmoid的导数: z1 * (1 - z1)
        da1 = dz1 * z1 * (1 - z1)

        # Affine层1: a1 = x·W1 + b1
        grads['W1'] = np.dot(x.T, da1)
        grads['b1'] = np.sum(da1, axis=0)

        return grads
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
然后我们再利用SGD对神经网络进行训练学习:
import os
import numpy as np
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import MinMaxScaler

# TwoLayerNet 已在上一个代码块定义, 这里直接使用

def load_data():
    """优先用Kaggle MNIST(28x28=784维); 离线环境兜底用sklearn内置digits(8x8=64维)"""
    if os.path.exists("../data/train.csv"):
        import pandas as pd
        data = pd.read_csv("../data/train.csv")
        X_raw, y_raw = data.drop("label", axis=1).values, data["label"].values
    else:
        from sklearn.datasets import load_digits
        digits = load_digits()
        X_raw, y_raw = digits.data, digits.target
    x_train, x_test, t_train, t_test = train_test_split(
        X_raw, y_raw, test_size=0.3, random_state=42, stratify=y_raw)
    scaler = MinMaxScaler()                    # 归一化参数只从训练集学
    x_train = scaler.fit_transform(x_train)
    x_test = scaler.transform(x_test)
    return x_train, x_test, t_train, t_test

x_train, x_test, t_train, t_test = load_data()

# 整数标签转one-hot(等价于原 load_mnist(one_hot_label=True))
t_train = np.eye(10)[t_train]
t_test = np.eye(10)[t_test]

network = TwoLayerNet(input_size=x_train.shape[1], hidden_size=50, output_size=10)

iters_num = 10000  # 适当设定循环的次数
train_size = x_train.shape[0]
batch_size = 100
learning_rate = 0.1

train_loss_list = []
train_acc_list = []
test_acc_list = []

# 注意: Python 3里 / 是真除法得float, 必须用 // 取整, 否则
# digits下1257/100=12.57, i % 12.57 == 0 只在 i=0 成立, 准确率曲线只有1个点
iter_per_epoch = max(int(train_size // batch_size), 1)

for i in range(iters_num):
    batch_mask = np.random.choice(train_size, batch_size)
    x_batch = x_train[batch_mask]
    t_batch = t_train[batch_mask]

    # 计算梯度: 用反向传播(gradient), 不要用numerical_gradient(会慢数百倍)
    grad = network.gradient(x_batch, t_batch)

    # 更新参数
    for key in ('W1', 'b1', 'W2', 'b2'):
        network.params[key] -= learning_rate * grad[key]

    loss = network.loss(x_batch, t_batch)
    train_loss_list.append(loss)

    if i % iter_per_epoch == 0:
        train_acc = network.accuracy(x_train, t_train)
        test_acc = network.accuracy(x_test, t_test)
        train_acc_list.append(train_acc)
        test_acc_list.append(test_acc)
        print("train acc, test acc | " + str(train_acc) + ", " + str(test_acc))

# 绘制图形
markers = {'train': 'o', 'test': 's'}
x = np.arange(len(train_acc_list))
plt.plot(x, train_acc_list, label='train acc')
plt.plot(x, test_acc_list, label='test acc', linestyle='--')
plt.xlabel("epochs")
plt.ylabel("accuracy")
plt.ylim(0, 1.0)
plt.legend(loc='lower right')
plt.show()
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
为什么用gradient而不是numerical_gradient? 先说结论:慢的不是"没用GPU",是那行numerical_gradient。实测对比(2层网络,batch=100):
| 梯度方式 | 64维(digits)单次迭代 | 10000次迭代 | 784维(MNIST)单次迭代 | 10000次迭代 |
|---|---|---|---|---|
numerical_gradient | 0.35 s | ≈ 1 小时 | 14 s | ≈ 40 小时 |
gradient(反向传播) | 0.062 ms | 0.6 s | 0.83 ms | 8.3 s |
原因:numerical_gradient要对每个参数扰动两次、各跑一遍完整前向。64维时参数量3760→每迭代7520次前向;784维时参数量39760→每迭代79520次前向。这是Python循环里的几万次极小矩阵运算,GPU搬上去只会更慢(每次kernel启动都有固定开销,而单次前向在CPU上才0.066ms,纯属给启动开销打工)。所以真正要改的是"怎么算梯度",不是"在哪算"。换反向传播后,纯numpy版10000次迭代实测3.7秒,digits上test acc≈0.96。
关于GPU(M1 Pro):M1 Pro上只有PyTorch的MPS(Metal)后端可用,CuPy/JAX-CUDA都要NVIDIA CUDA,装了也跑不了。但这个网络规模(batch=100,hidden=50)下MPS大概率不快甚至更慢——100×64@64×50这种矩阵太小,GPU利用率极低。真想看到GPU收益,得是hidden_size上千、batch上千、或者换成CNN(那时候MPS才有明显加速)。PyTorch版需pip install torch torchvision(macOS≥12.3、torch≥1.12),且MPS对float64支持有限,要用float32。
# 1.2 计算图
1.1节的SGD用数值梯度更新参数,每个参数都要扰动两次才能算出梯度;网络一深,这种"逐参数试错"的开销就扛不住。能不能让网络一次性把每一层的梯度都算出来?可以,这就是反向传播,而反向传播需要用计算图作为"语言"来描述整个前向计算。
计算图将计算过程用图表示出来。这里说的图是数据结构中的图,通过多个节点和边表示(连接节点的直线称为边)。可以把计算图想象成一条流水线:原料(输入)从一端进入,经过一道道工序(节点),每道工序只做一件简单的事,最终产出成品(输出);每道工序只关心自己手里的料和操作,不需要知道整条流水线在干嘛——这正是下面"局部计算"的直观画面。
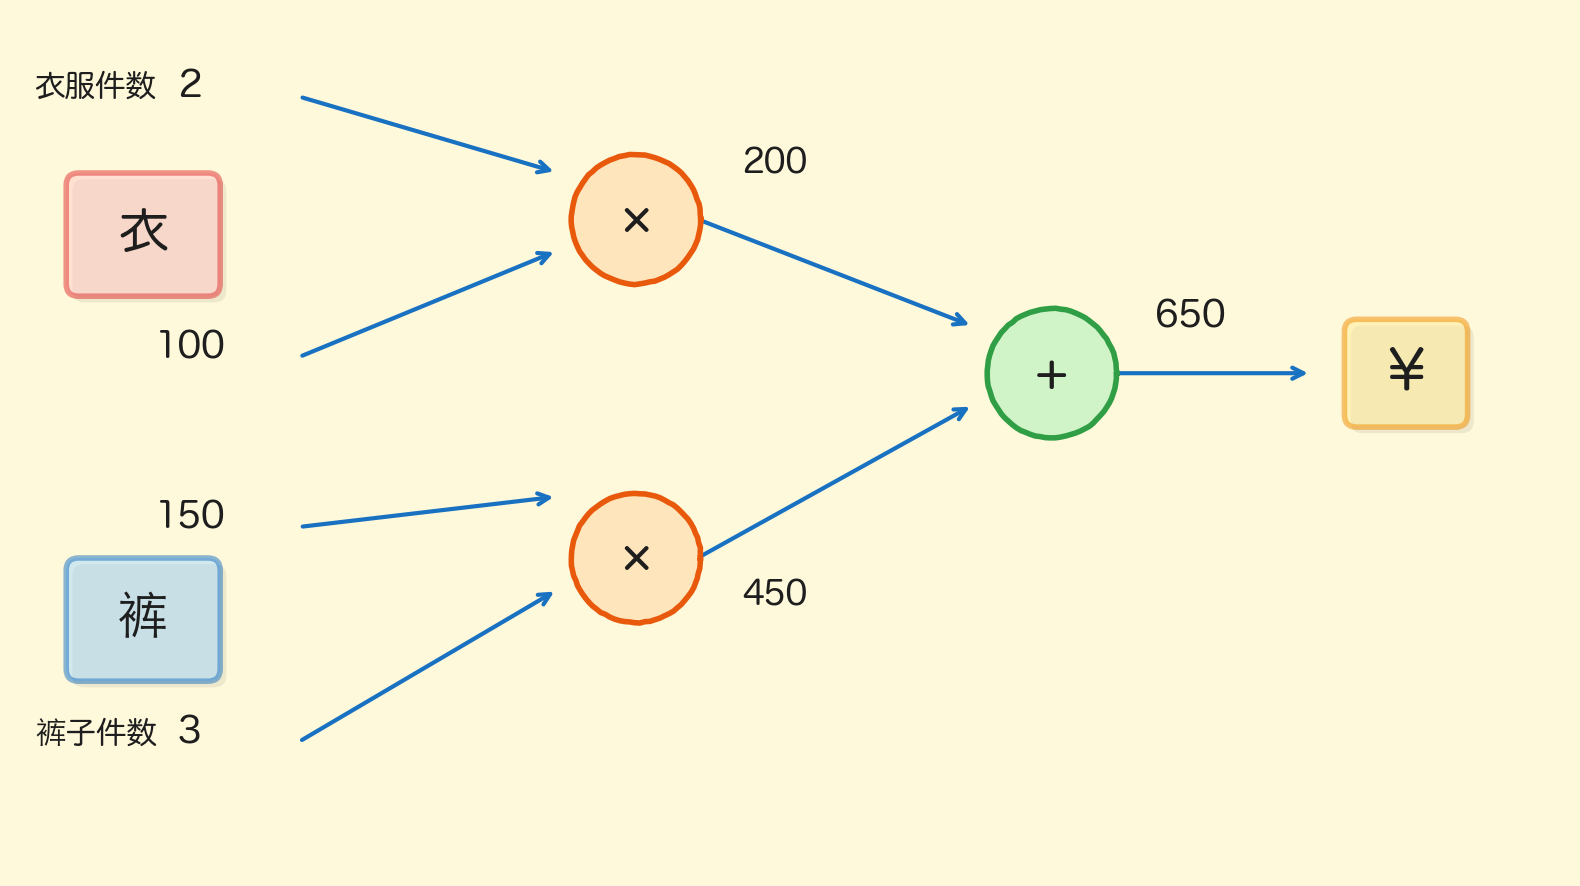
如上就是 的计算图表示。
计算图的基本计算原则,就是从输入出发、按照箭头方向,从左到右依次进行计算,最终得到输出结果。这个过程,其实就是 前向传播(forward)。
计算图的特点是可以通过传递"局部计算"获得最终结果。即只需根据与自己相关的信息输出接下来的结果。无论全局的计算有多么复杂,各个节点所要做的就是进行局部计算并传递计算结果,最终得出全局的复杂计算的结果。
如果增加更多的计算环节,比如再乘以一个"零售加价系数",计算图如下所示。
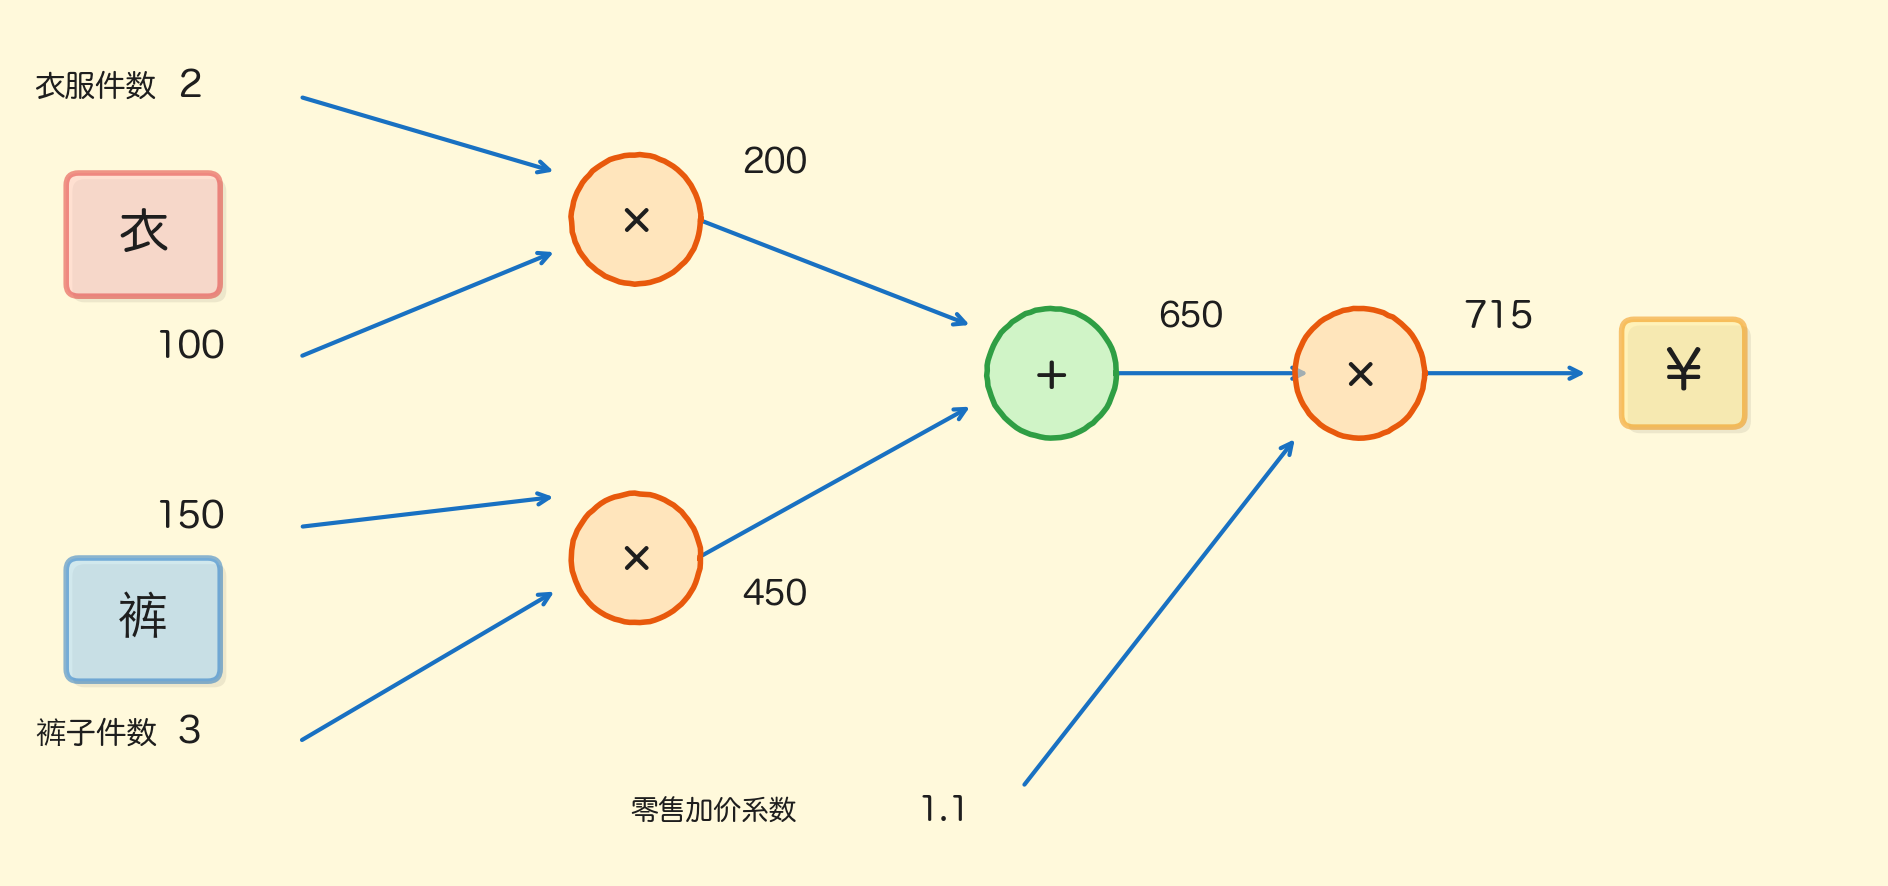
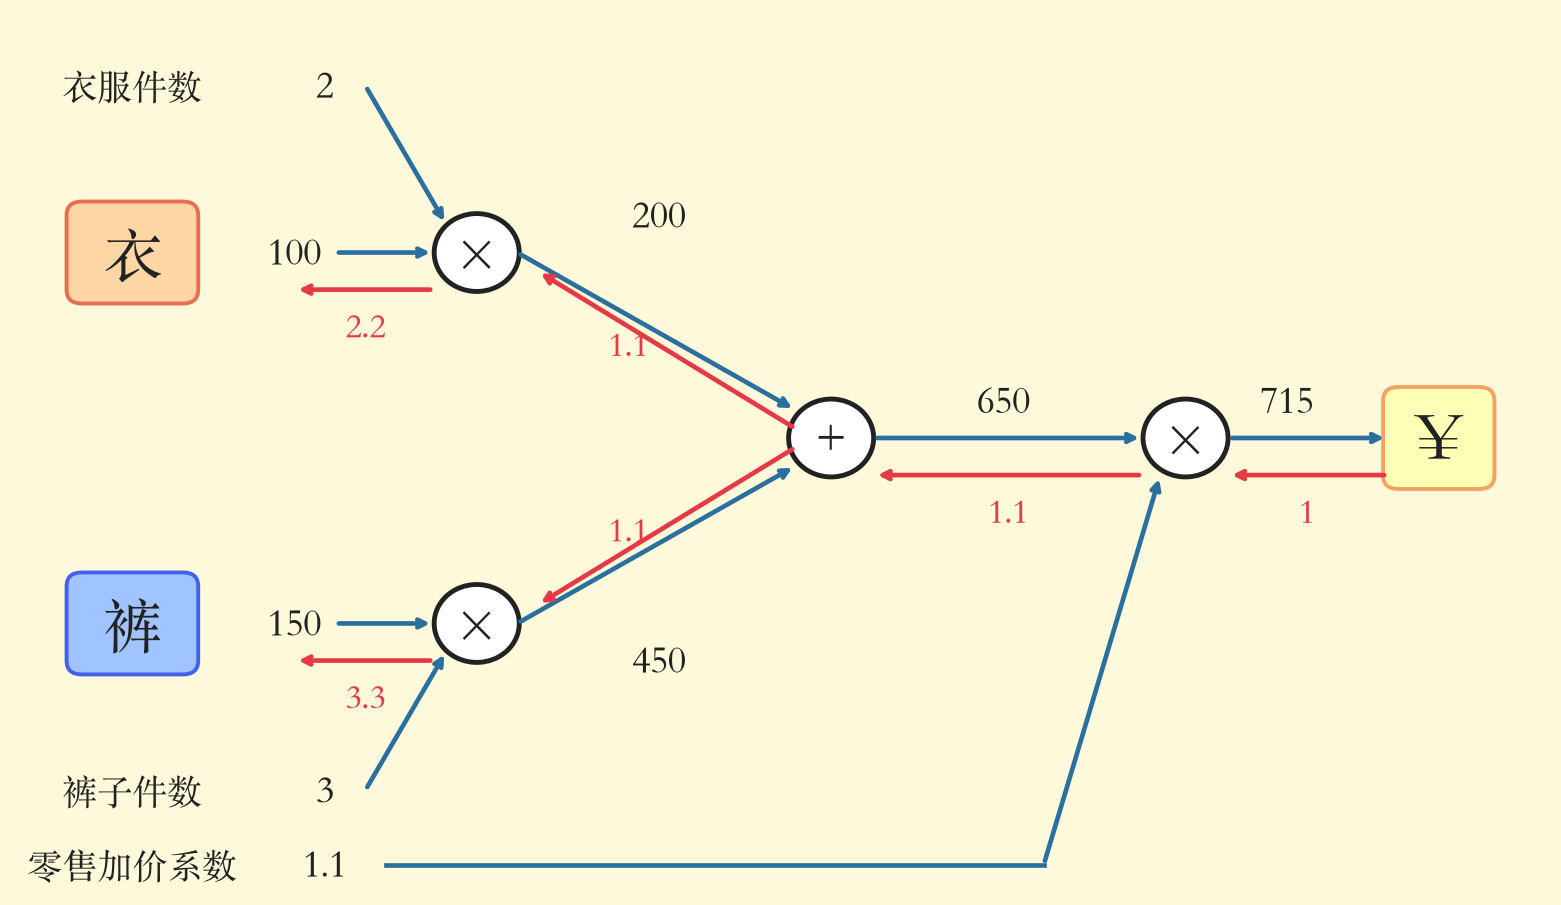
如果我们进一步考虑,当衣服的价格上涨(输入变化)时,会多大程度上影响最后要支付的金额(输出结果)?
将输入的衣服价格记为x,输出的支付金额记为L,这其实就是要求导数值 。在计算图上,我们可以利用反向(从右到左)的传递来方便地计算导数。这个过程,就可以叫做 反向传播(backward)。
# 1.3 链式法则
反向传播将局部导数向反方向传递,传递的原理基于链式法则。反向传播时将信号乘以节点的局部导数然后传递给下一个节点。
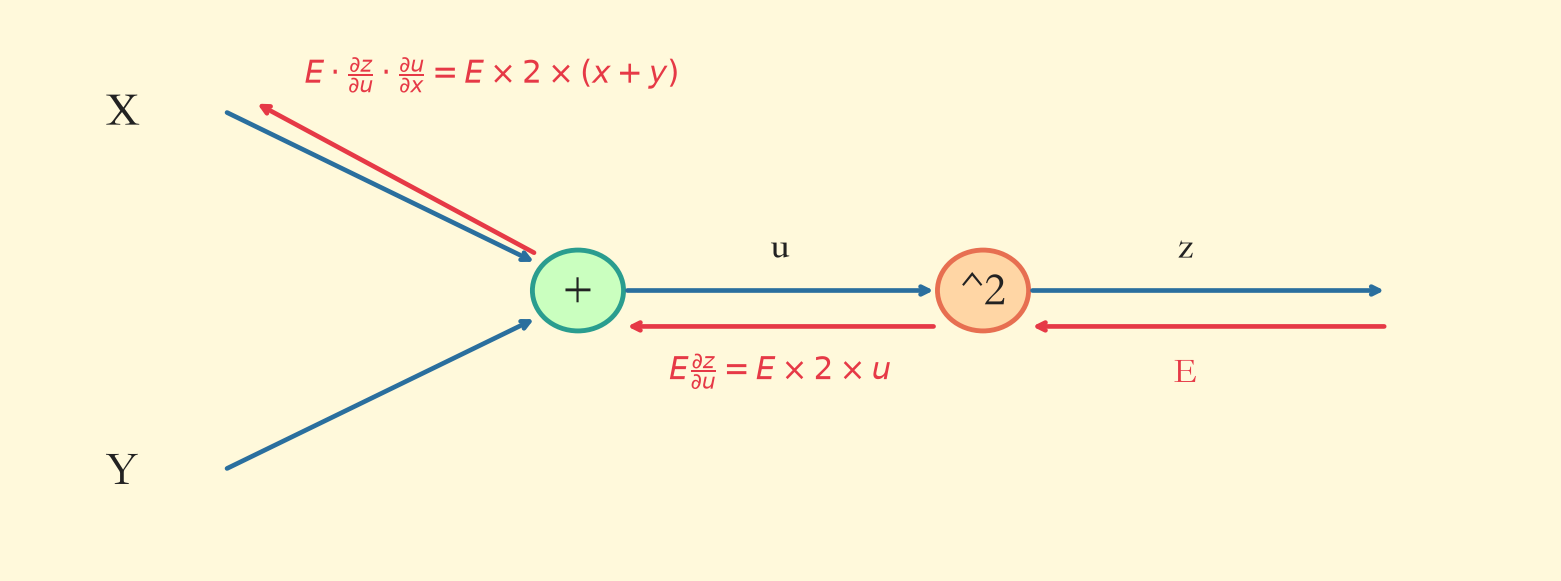
对于复合函数,令,则
现用计算图表示:
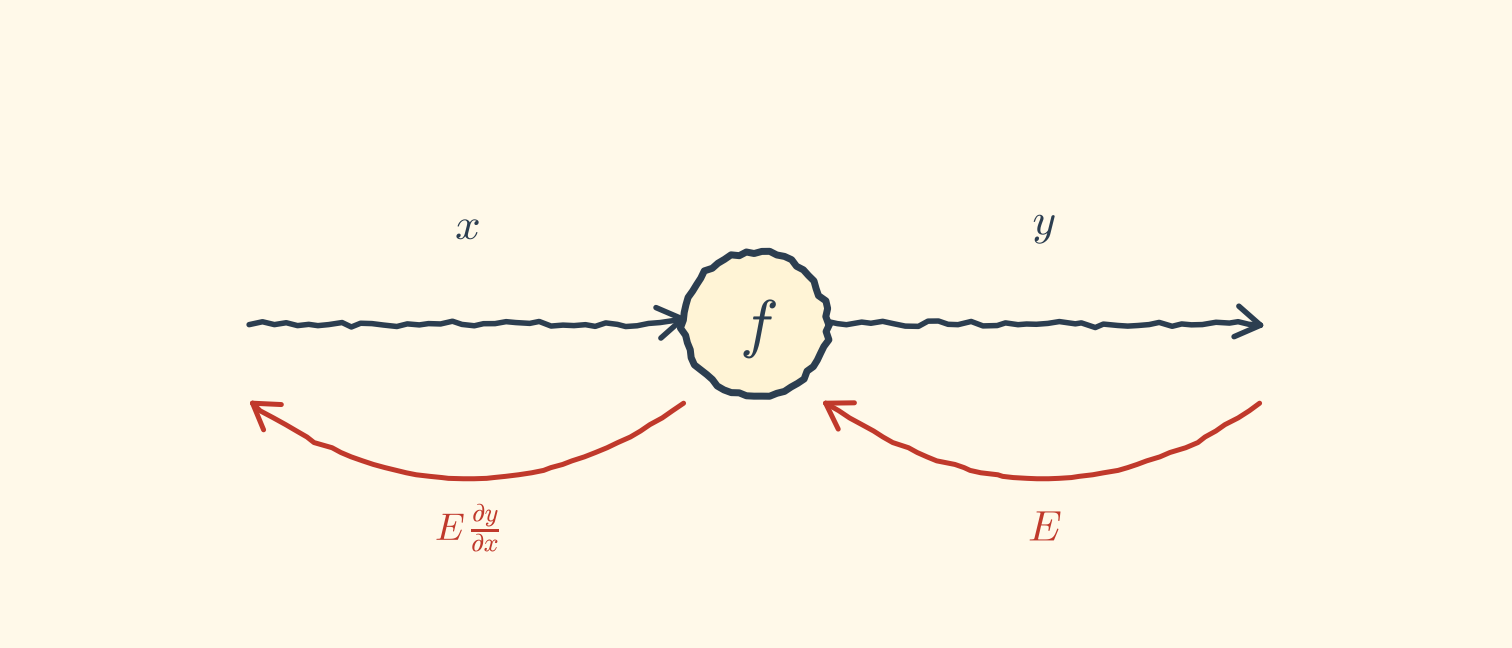
怎么直观理解这个链式法则?要想知道变化一点点时跟着变化多少,可以分两步走:先看变化一点点时中间变量变化多少(即),再看变化一点点时变化多少(即),两者相乘就是最终答案。复合函数像一根链条,每一节只负责自己那一段的变化率,连起来就是端到端的变化率——这正是反向传播能把每一层的局部导数"串"起来、一次性得到全局梯度的原因。
# 1.4 反向传播
利用计算图的反向传播,可以很容易地计算出输出关于输入的偏导数。
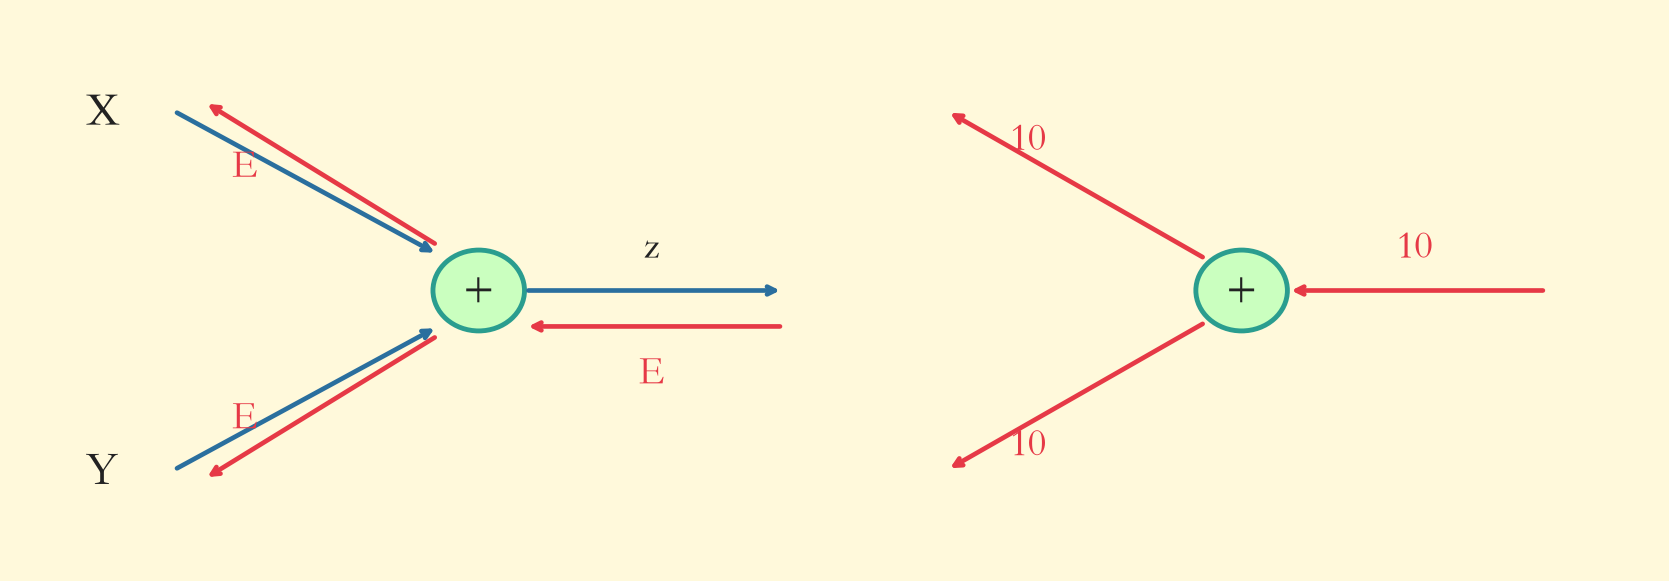
# 1.4.1 加法节点的反向传播
对于,,。道理很直白:每增加1,也跟着增加1,导数就是1;同理。因此加法的反向传播会将上游传来的值原样向下游传递——加法节点在反向传播里就像一根直通管道,信号怎么进来就怎么出去。
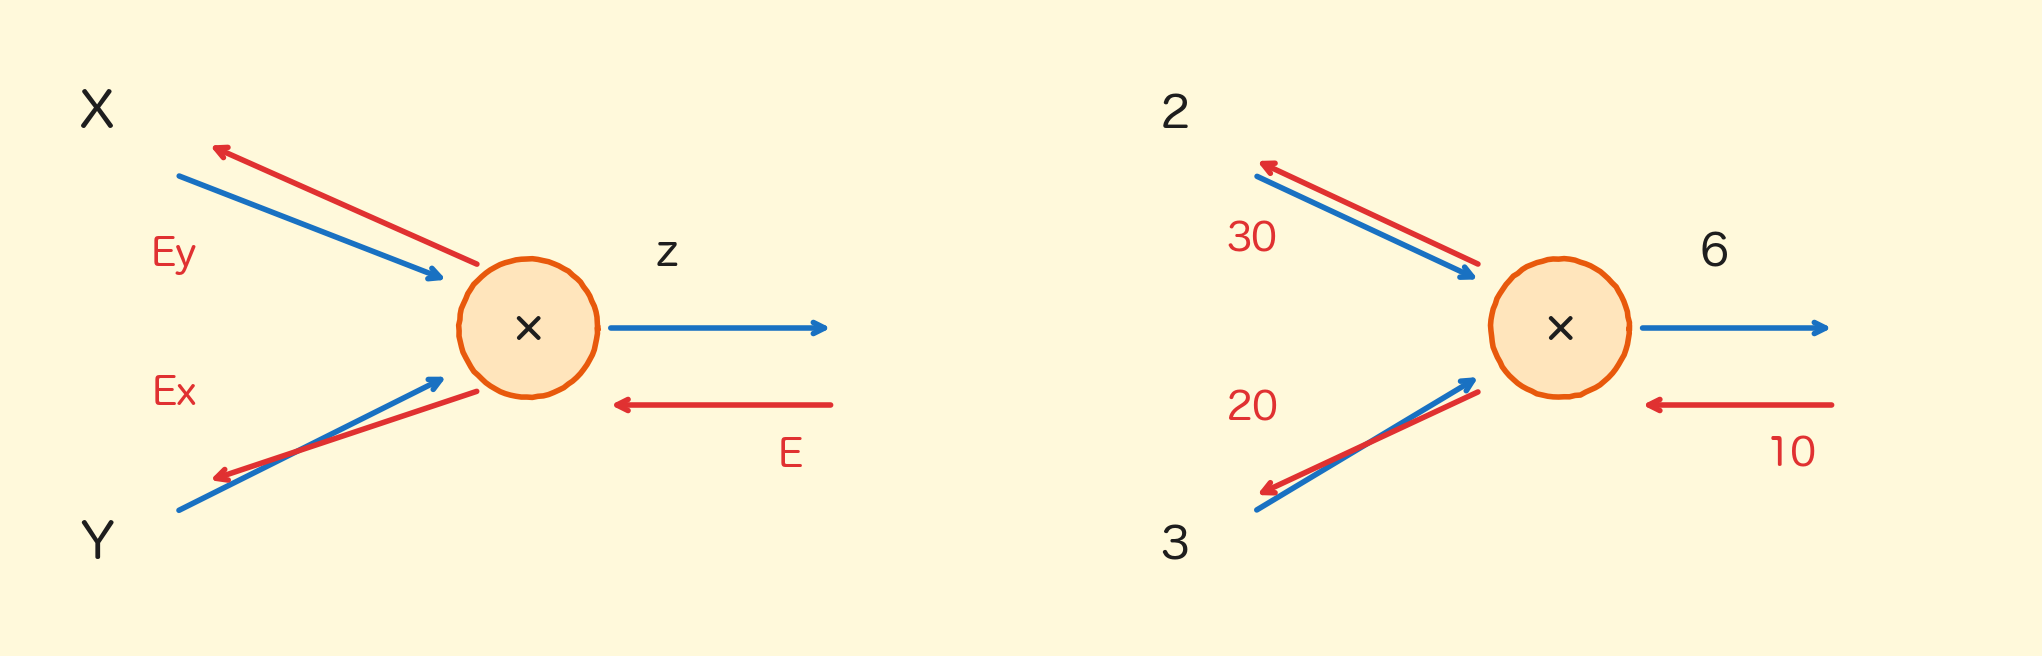
# 1.4.2 乘法节点的反向传播
对于,,。可以这样理解:对的导数就是把换成它的"搭档",因为每变化1个单位,就变化个单位。因此乘法的反向传播会将上游传来的值乘以"另一个输入"向下游传递——也就是把正向传播时的两个输入翻转一下,所以代码实现里要保存前向的输入,反向时才能取出对应的搭档值。
# 1.5 激活层的反向传播和实现
现在将计算图应用到神经网络中。神经网络中一步重要的计算操作就是激活函数,下面就来讨论各种激活函数的反向传播,基于这些我们就可以用代码实现激活层的完整功能了。
# 1.5.1 ReLU的反向传播
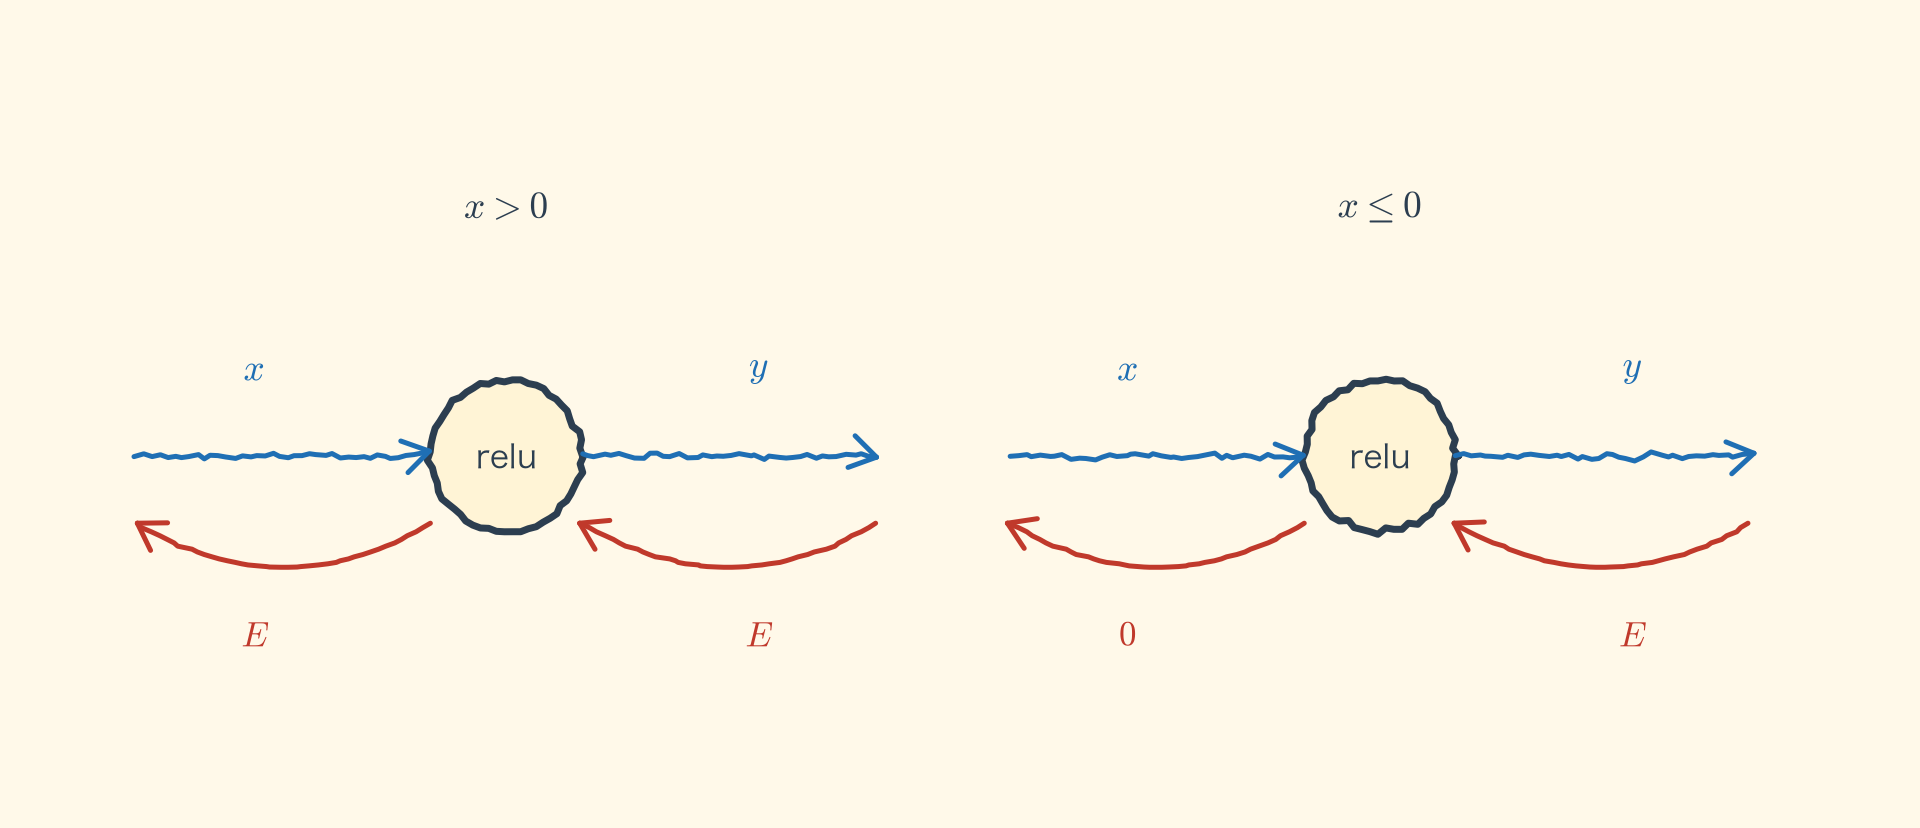
对于ReLU函数:
其导数为:
分为 和 两种情况分别讨论,反向传播的计算图如下:
ReLU层可以在代码中实现为一个类 Relu:
class Relu:
    def __init__(self):
        self.mask = None

    def forward(self, x):
        self.mask = (x <= 0)
        out = x.copy()
        out[self.mask] = 0

        return out

    def backward(self, dout):
        dout[self.mask] = 0
        dx = dout

        return dx
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
# 1.5.2 Sigmoid的反向传播
对于Sigmoid函数:
其导数为:
逐步拆解这步推导:把看成,对外层用幂函数求导、对内层再求一次导(注意的导数是,负负得正),就得到第一步。接着把分子拆成,再注意到,代入就得到。这个结果特别讨喜:导数完全由函数自身表达,反向传播时只要把前向传播保存的输出值拿出来,乘以即可,不需要重新算。
利用计算图的反向传播,也可以得到相同的结果:
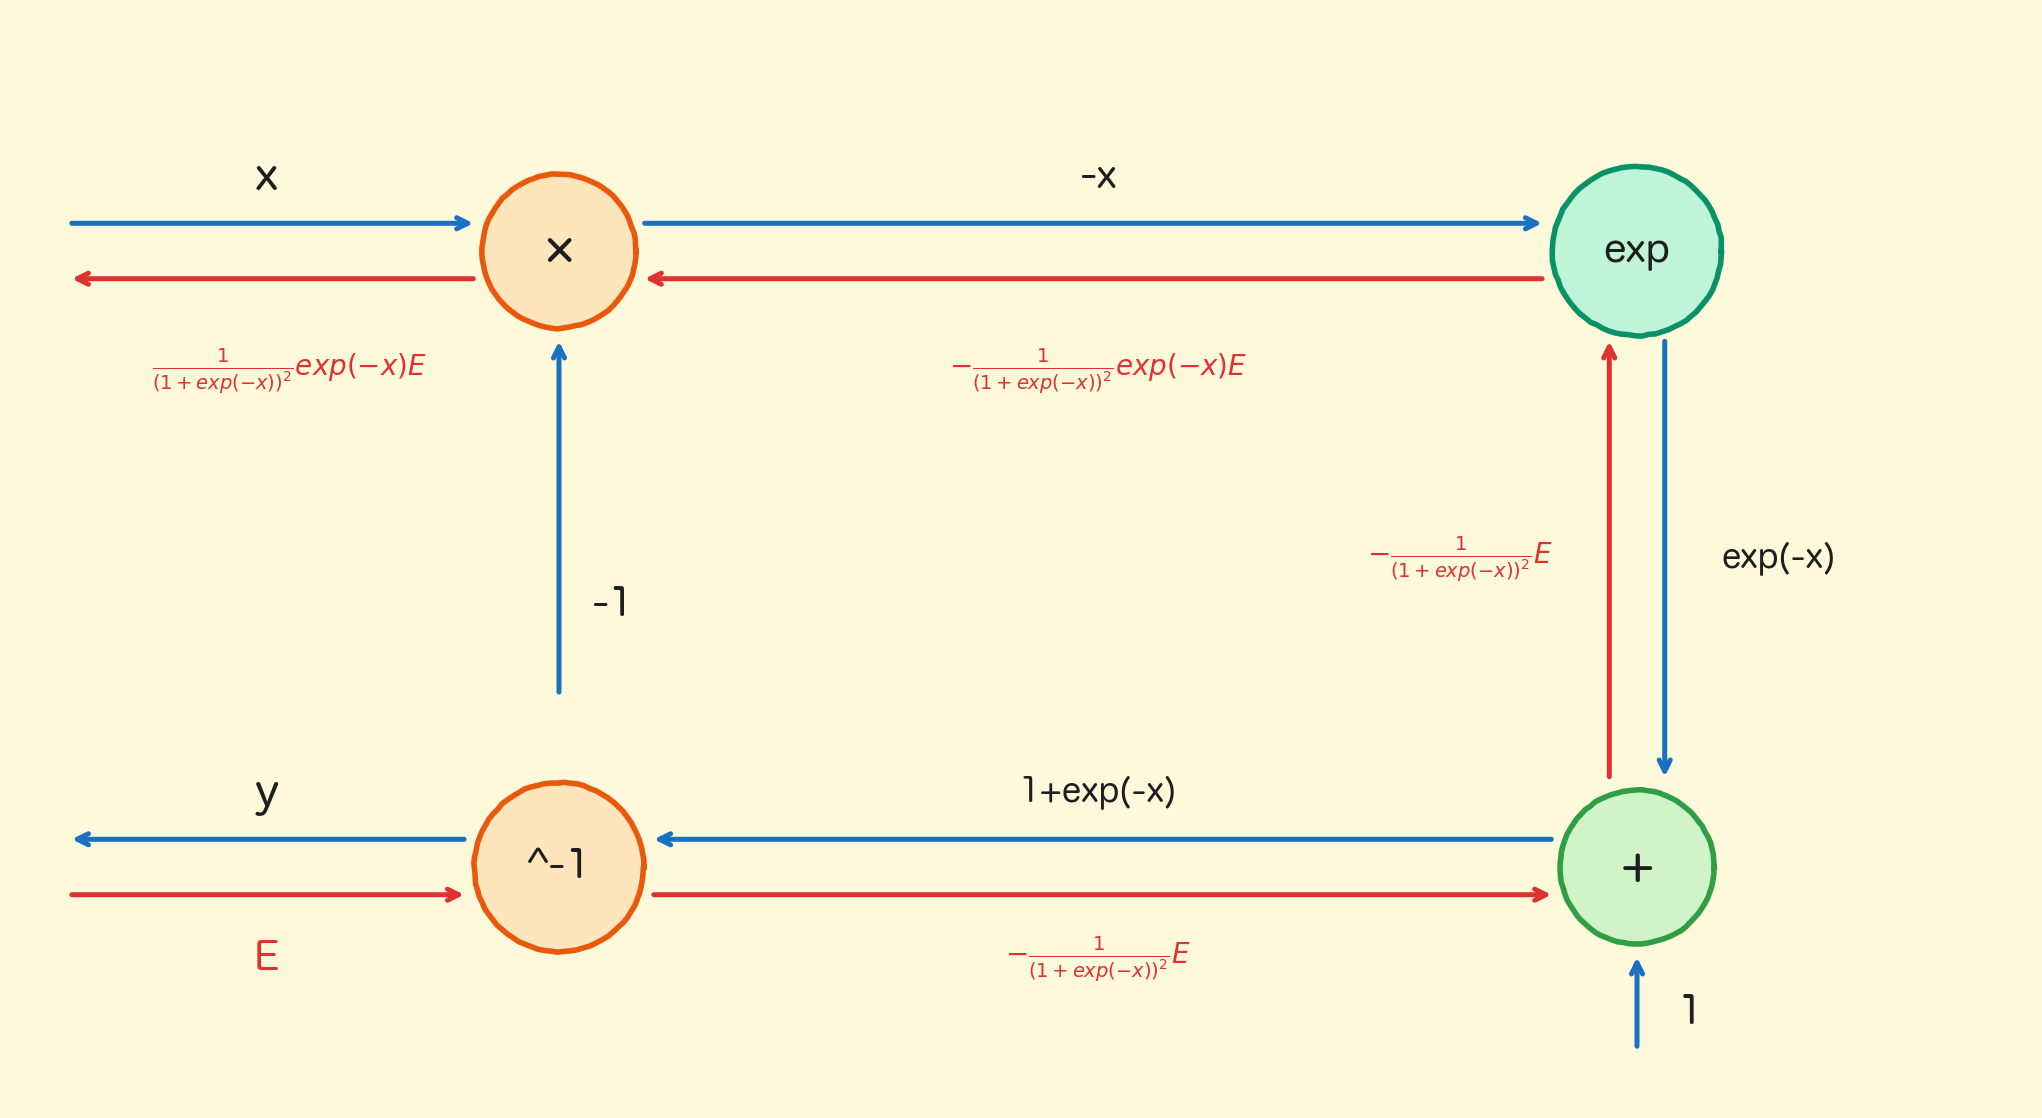
简化得:
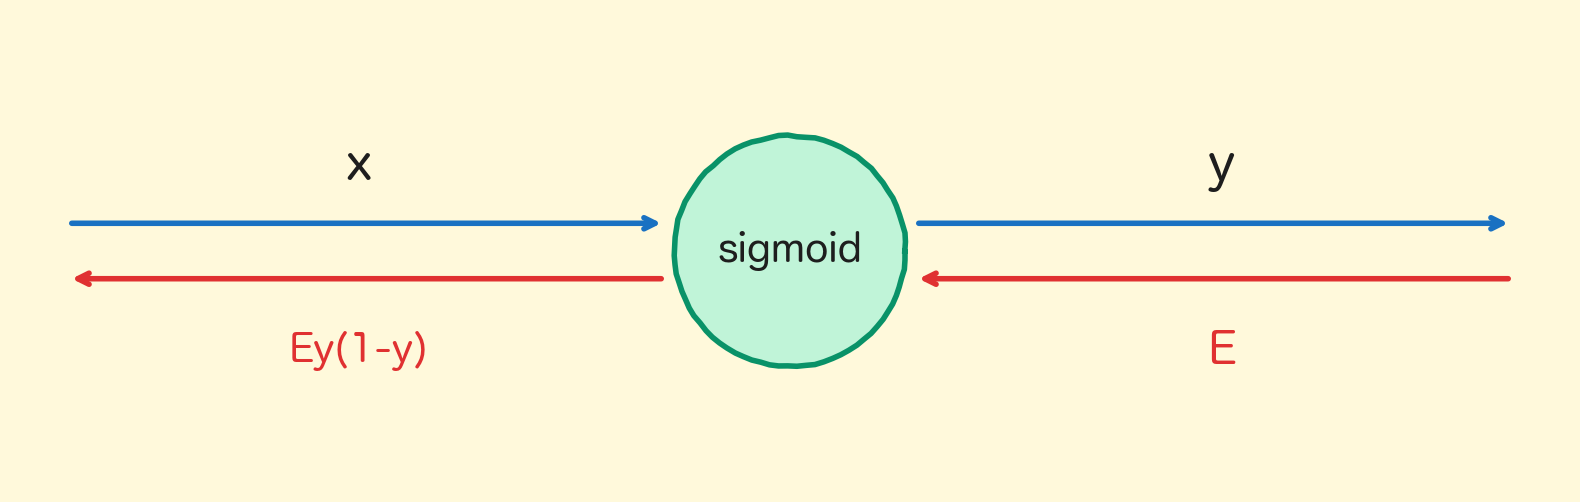
Sigmoid层可以在代码中实现为一个类 Sigmoid:
class Sigmoid:
    def __init__(self):
        self.out = None

    def forward(self, x):
        out = sigmoid(x)
        self.out = out
        return out

    def backward(self, dout):
        dx = dout * (1.0 - self.out) * self.out

        return dx
2
3
4
5
6
7
8
9
10
11
12
13
# 1.6 Affine的反向传播和实现
在全连接层(Fully Connected Layer,Dense Layer)中,每个输入节点与输出节点相连,通过权重矩阵和偏置进行线性变换,这种操作在几何领域称为仿射变换(Affine transformation,几何中,仿射变换包括一次线性变换和一次平移,分别对应神经网络的加权求和运算与加偏置运算)。
考虑N个数据一起进行正向传播的情况,写成矩阵计算形式:
这里的是形状为的矩阵,m就是Affine层输入神经元的个数;而是形状为的权重矩阵,n就是Affine层输出神经元的个数。
根据矩阵求导的运算法则,可以得到损失函数关于、的偏导数:
为什么会出现转置?关键在于矩阵乘法的链式法则要求"形状对得上"。前向传播是,其中是、是、是。反向传播时,上游传来的形状和一样是,而我们要算的形状必须和一样是。把()乘以某个矩阵得到的结果,这个矩阵只能是的转置();同理()需要()乘以()。一句话记:前向谁在左、反向它的转置就在左,乘法顺序整体翻转。
用计算图的反向传播计算如下:
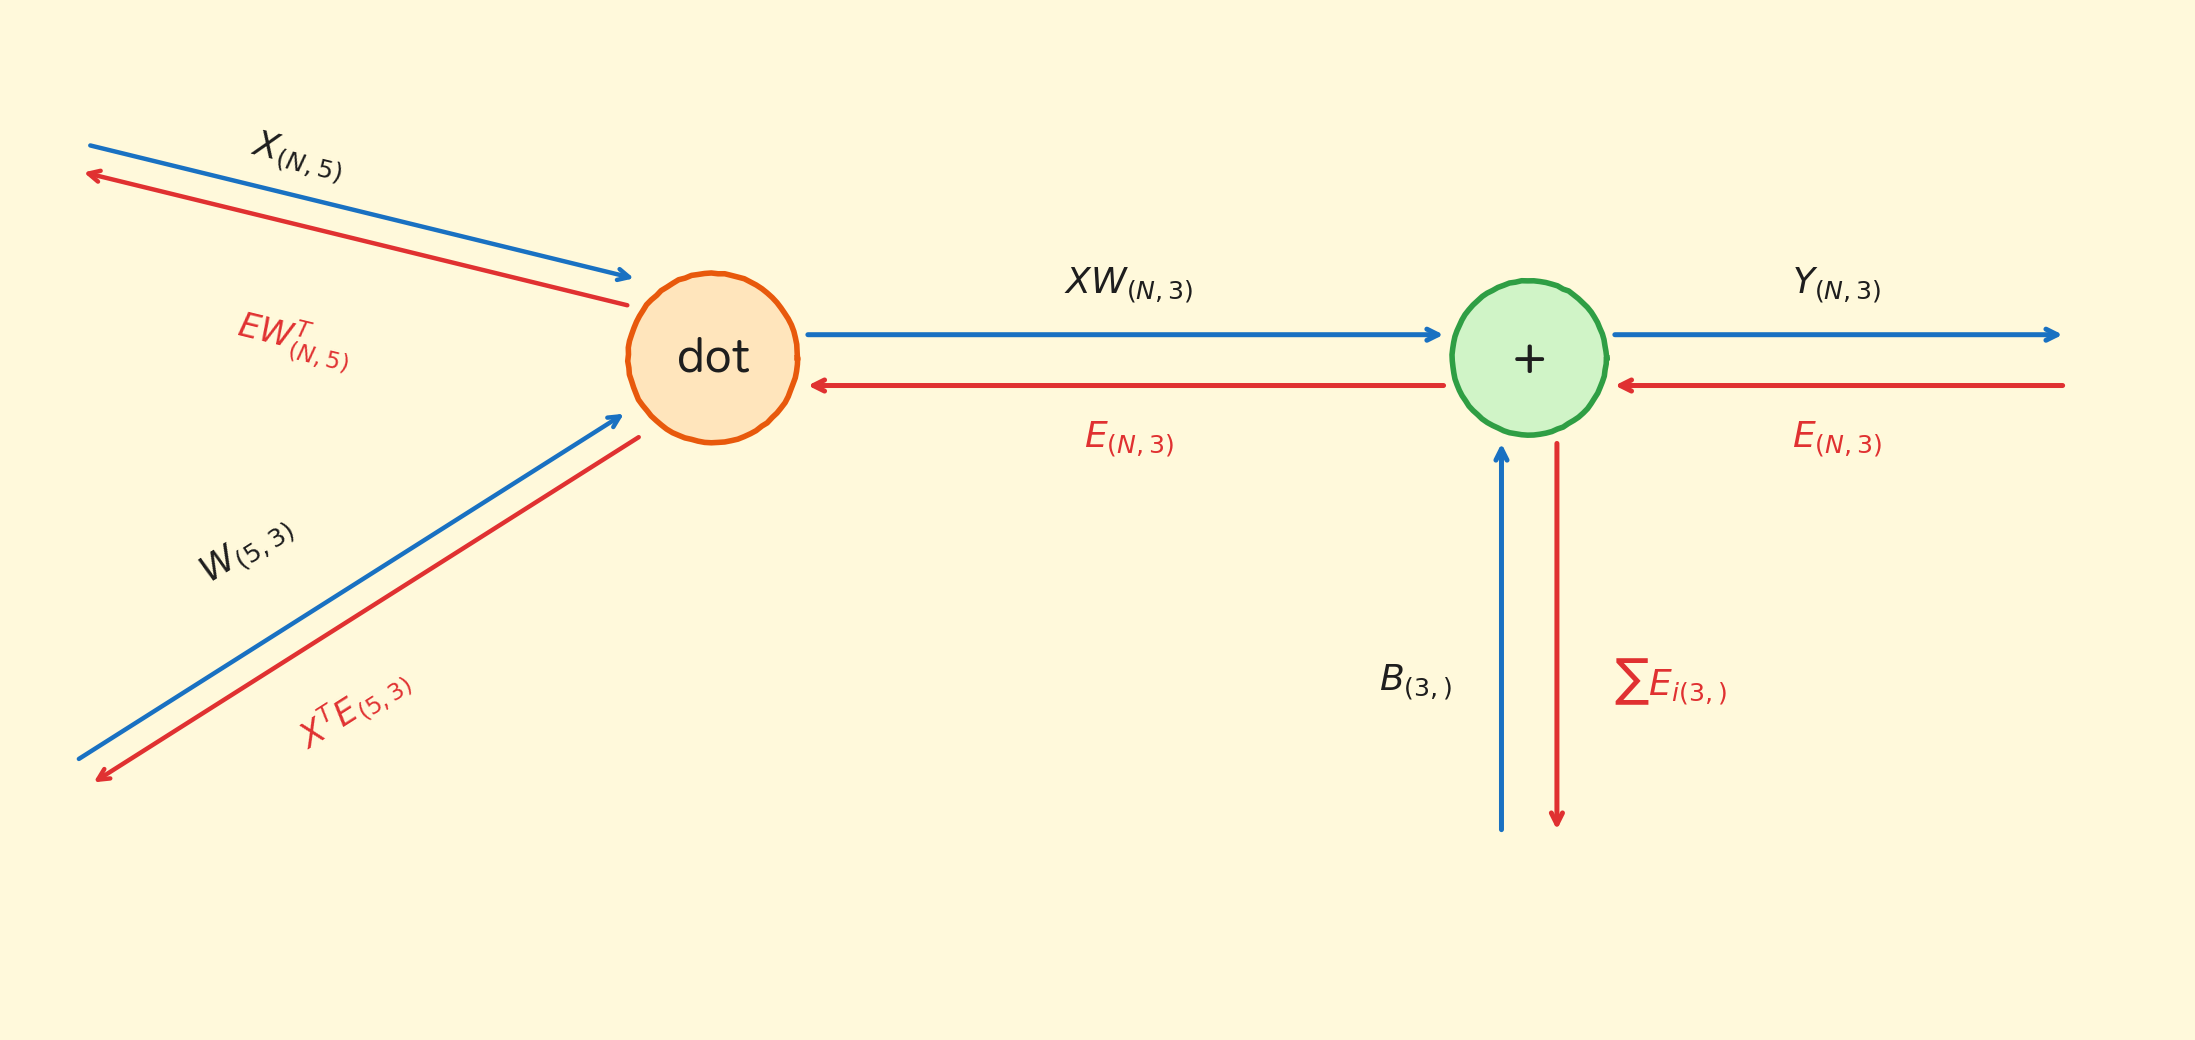
这里令,需要注意矩阵的形状要满足矩阵乘法的要求。
Affine层可以在代码中实现为一个类 Affine:
class Affine:
    def __init__(self, W, b):
        self.W = W
        self.b = b

        self.x = None
        self.original_x_shape = None
        # 权重和偏置参数的导数
        self.dW = None
        self.db = None

    def forward(self, x):
        # 对应张量
        self.original_x_shape = x.shape
        x = x.reshape(x.shape[0], -1)
        self.x = x

        out = np.dot(self.x, self.W) + self.b

        return out

    def backward(self, dout):
        dx = np.dot(dout, self.W.T)
        self.dW = np.dot(self.x.T, dout)
        self.db = np.sum(dout, axis=0)

        dx = dx.reshape(*self.original_x_shape)

        return dx
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
# 1.7 输出层的反向传播和实现
在输出层,我们一般使用Softmax作为激活函数。
对于Softmax函数:
其偏导数为:
单独看Softmax时,每个输出对每个输入都有非零的偏导数,整个雅可比矩阵是满的,反向传播时代价不小。而对于输出层,一般会直接将结果代入损失函数的计算。对于我们之前介绍的分类问题,这里选择交叉熵误差(Cross Entropy Error)作为损失函数,就可以得到一个Softmax-with-Loss层,它包含了Softmax和Cross Entropy Loss两部分。
导数的计算会比较复杂,可以用计算图表示如下:
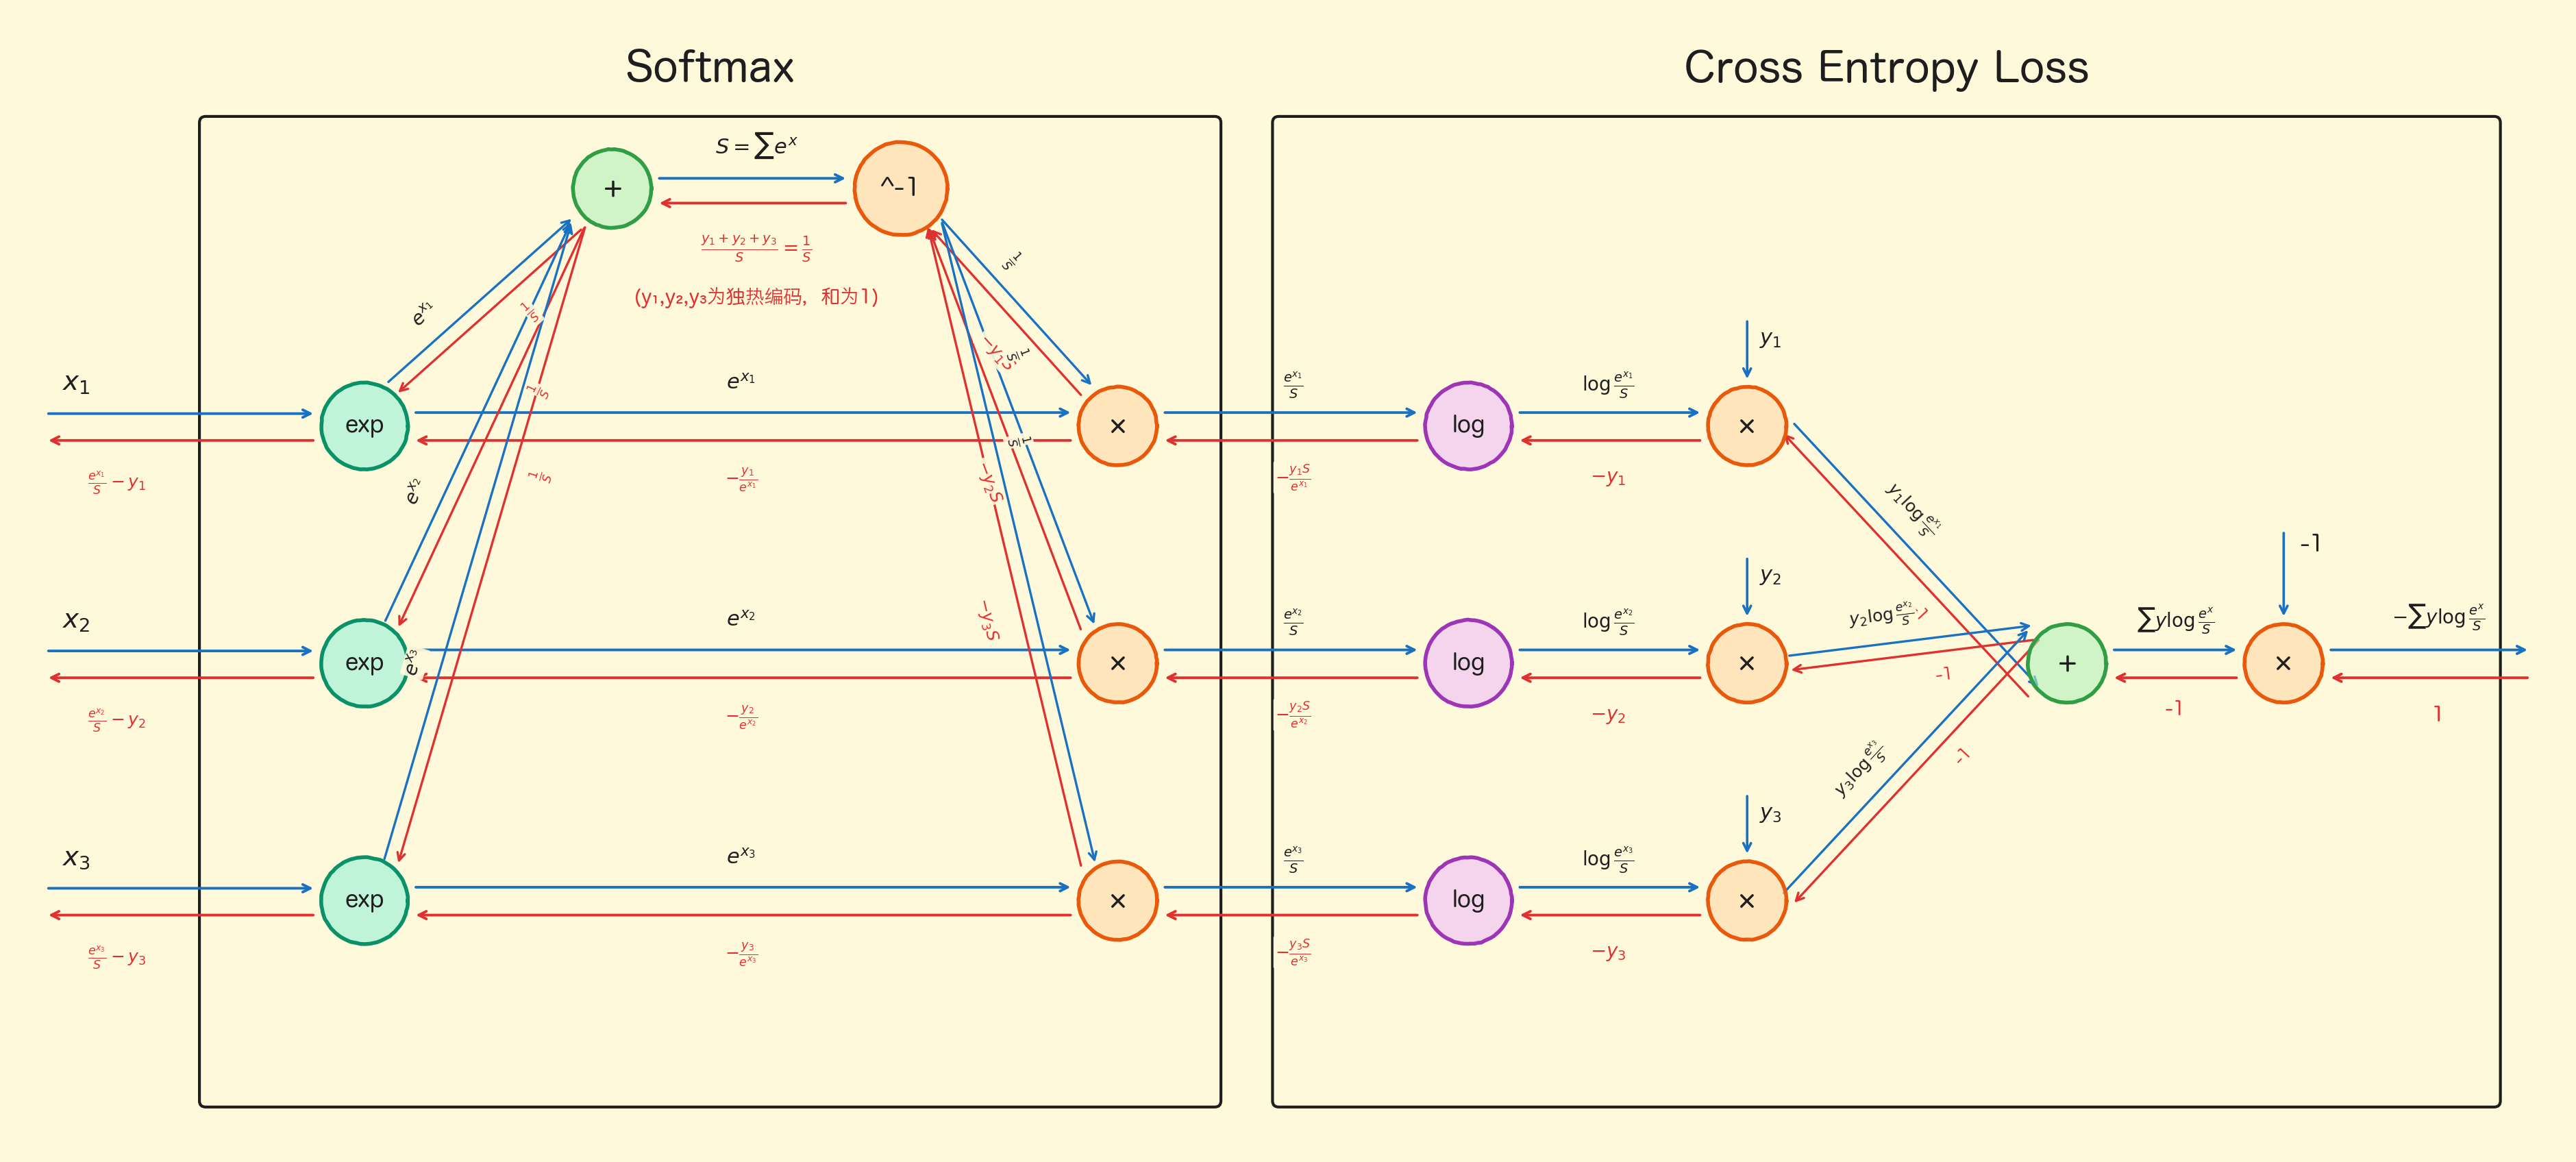
简化得:
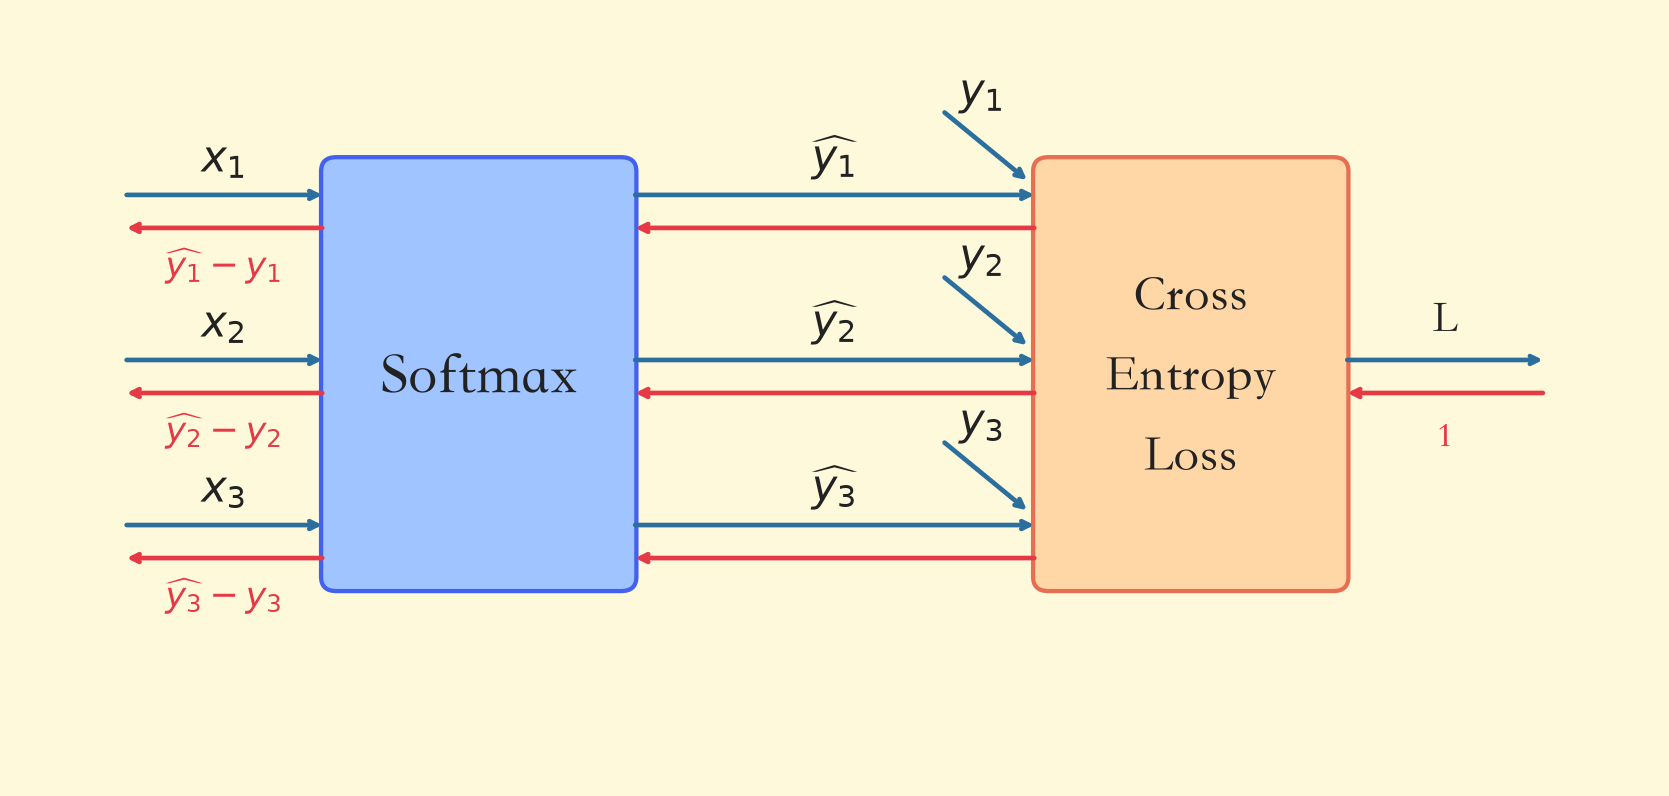
为什么最后的结果会那么简洁、直接变成?把链式法则展开看清楚。设Softmax输出,交叉熵。
第一步,交叉熵对求导:,形式上很干净。
第二步,用链式法则,代入Softmax那两种偏导数(时为,时为),注意分子里的会把分母上的约掉、负号也抵消:
最后一步用到了one-hot标签。也就是说,Softmax那个看起来很复杂的雅可比矩阵,一旦配上交叉熵损失,满矩阵里的项就互相抵消,只剩下一个"预测概率减去标签"的差值——这正是交叉熵损失配Softmax的原因,也是为什么代码里反向传播只需一行(self.y - self.t) / batch_size。
在代码中可以实现为一个类 SoftmaxWithLoss:
class SoftmaxWithLoss:
    def __init__(self):
        self.loss = None
        self.y = None # softmax的输出
        self.t = None # 监督数据

    def forward(self, x, t):
        self.t = t
        self.y = softmax(x)
        self.loss = cross_entropy_error(self.y, self.t)

        return self.loss

    def backward(self, dout=1):
        batch_size = self.t.shape[0]
        if self.t.size == self.y.size: # 监督数据是one-hot-vector的情况
            dx = (self.y - self.t) / batch_size
        else:
            dx = self.y.copy()
            dx[np.arange(batch_size), self.t] -= 1
            dx = dx / batch_size

        return dx
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
# 1.8 反向传播的综合代码实现
现在可以在之前手写数字识别案例的基础上,对SGD的计算过程进行优化。核心就是使用误差的反向传播法来计算梯度,而不是使用差分数值计算;这将大大提升学习的效率。
对于二层网络TwoLayerNet,隐藏层由一个Affine层和一个ReLU层组成,输出层则由一个Affine层和一个Softmax-with-Loss层组成。由于之前已经实现了各层的类,现在只要用"搭积木"的方式将它们拼接在一起就可以了。
将TwoLayerNet类的代码实现改进如下:
import numpy as np
from collections import OrderedDict

# Relu / Sigmoid / Affine / SoftmaxWithLoss 各层已在前文逐个定义,
# numerical_gradient 已在1.1节定义, 这里直接组装成反向传播版网络

class TwoLayerNet:

    def __init__(self, input_size, hidden_size, output_size, weight_init_std = 0.01):
        # 初始化权重
        self.params = {}
        self.params['W1'] = weight_init_std * np.random.randn(input_size, hidden_size)
        self.params['b1'] = np.zeros(hidden_size)
        self.params['W2'] = weight_init_std * np.random.randn(hidden_size, output_size)
        self.params['b2'] = np.zeros(output_size)

        # 生成层
        self.layers = OrderedDict()
        self.layers['Affine1'] = Affine(self.params['W1'], self.params['b1'])
        self.layers['Relu1'] = Relu()
        self.layers['Affine2'] = Affine(self.params['W2'], self.params['b2'])

        self.lastLayer = SoftmaxWithLoss()

    def predict(self, x):
        for layer in self.layers.values():
            x = layer.forward(x)

        return x

    # x:输入数据, t:监督数据
    def loss(self, x, t):
        y = self.predict(x)
        return self.lastLayer.forward(y, t)

    def accuracy(self, x, t):
        y = self.predict(x)
        y = np.argmax(y, axis=1)
        if t.ndim != 1 : t = np.argmax(t, axis=1)

        accuracy = np.sum(y == t) / float(x.shape[0])
        return accuracy

    # x:输入数据, t:监督数据
    def numerical_gradient(self, x, t):
        loss_W = lambda W: self.loss(x, t)

        grads = {}
        grads['W1'] = numerical_gradient(loss_W, self.params['W1'])
        grads['b1'] = numerical_gradient(loss_W, self.params['b1'])
        grads['W2'] = numerical_gradient(loss_W, self.params['W2'])
        grads['b2'] = numerical_gradient(loss_W, self.params['b2'])

        return grads

    def gradient(self, x, t):
        # forward
        self.loss(x, t)

        # backward
        dout = 1
        dout = self.lastLayer.backward(dout)

        layers = list(self.layers.values())
        layers.reverse()
        for layer in layers:
            dout = layer.backward(dout)

        # 设定
        grads = {}
        grads['W1'], grads['b1'] = self.layers['Affine1'].dW, self.layers['Affine1'].db
        grads['W2'], grads['b2'] = self.layers['Affine2'].dW, self.layers['Affine2'].db

        return grads
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
接下来的训练过程,跟之前是一样的,只需要调用新的梯度计算函数即可。
# 1.9 深度神经网络及其问题:梯度消失与梯度爆炸
# 1.9.1 深度学习:用更深的网络分层传递信息
当神经网络的层数加深时,往往可以有效地提高识别精度;特别是对于大规模的复杂问题,通常都需要用更多的层来分层次传递信息,而且可以有效减少网络的参数数量,从而使得学习更加高效。使用深度神经网络进行的学习就被称为深度学习(Deep Learning)。
ILSVRC是近年来机器视觉领域最受追捧且最具权威的学术竞赛之一,代表了图像领域的最高水平。它包含多个测试项目,其中最有名的就是"类别分类"(Classification),该项目会进行1000个类别的分类,比试识别精度。自从2012年以后的ILSVRC比赛,优胜队伍采用的方法基本上都是以深度学习为基础的。
可以说,深度学习代表了目前人工智能领域的发展方向,正以超乎想象的速度发展并改变我们的生活。可深度也是一把双刃剑:层数一多,梯度在反向传播中就开始失稳,这就是接下来要讨论的梯度消失与梯度爆炸。
# 1.9.2 梯度消失:前面层学不动了
在某些神经网络中,随着网络深度的增加,梯度在隐藏层反向传播时倾向于变小。这就意味着,前面隐藏层中的神经元要比后面的学习起来更慢。这种现象被称为"梯度消失"。
直觉上:靠近输出的层梯度信号很强、学得很快,但信号往前传一层就衰减一点,传到靠近输入的层时已经微弱到几乎为零——前面层的参数几乎不更新,整个网络等于只有后面几层在干活,深度带来的红利全白费了。
# 1.9.3 梯度爆炸:步子大到把网络冲飞
与之对应,如果我们进行一些特殊的调整(比如初始权重很大),可以让梯度反向传播时不会明显减小,从而解决梯度消失的问题;然而这样一来,前面层的梯度又会变得非常大,引起网络不稳定,无法再从训练数据中学习。这种现象被称为"梯度爆炸"。
基于梯度学习的深度神经网络中,梯度本身是不稳定的,前面层中的梯度可能"消失",也可能"爆炸"。
# 1.9.4 一个容易理解的解释:连乘系数决定生死
对于梯度消失和梯度爆炸,一个容易理解的解释是:当反向传播进行很多层的时候,每一层都对前一层梯度乘以了一个系数;因此当这个系数比较小(小于1)时,越往前传递,梯度就会越小、训练越慢,导致梯度消失;而如果这个系数比较大,则越往前传递梯度就会越大,导致梯度爆炸。
把层的连乘写出来就是:每个略小于1(比如0.9),100层之后就是,梯度直接没了;每个略大于1(比如1.1),100层之后就是,梯度直接爆炸。深层网络难训练,难就难在这个连乘对系数极其敏感。这也正是ReLU能缓解梯度消失的原因:它的导数非0即1,连乘中的被钉在1附近,梯度不再逐层衰减。
# 1.9.5 怎么办:从三个方向入手
所以,深度神经网络的训练是比较复杂的,会有一系列的问题。研究表明,激活函数的选择、权重的初始化,甚至学习算法的实现方式都是影响因素;另外,网络的架构和其他一些超参数也有重要影响。
为了让深度神经网络的学习更加稳定、高效,我们需要更好的参数更新方法、合理的参数初始值与超参数设置,此外还要解决过拟合的问题——这正是接下来三节的内容:更新参数方法的优化、参数初始化、正则化。
# 1.10 更新参数方法的优化:从SGD到Adam
对于深度神经网络的学习,之前更新参数的方法是随机梯度下降法(SGD)。这种方法比较简单,也非常经典,但在很多具体问题中并不是最高效的。
# 1.10.1 SGD的缺点
SGD的更新方式可以写为:
这里W是要更新的权重参数(矩阵),损失函数L关于W的梯度就是;而η表示学习率。
我们可以将SGD单独包装成一个类:
class SGD:
    def __init__(self, lr=0.01):
        self.lr = lr

    def update(self, params, grads):
        for key in params.keys():
            params[key] -= self.lr * grads[key]
2
3
4
5
6
7
SGD有以下问题:
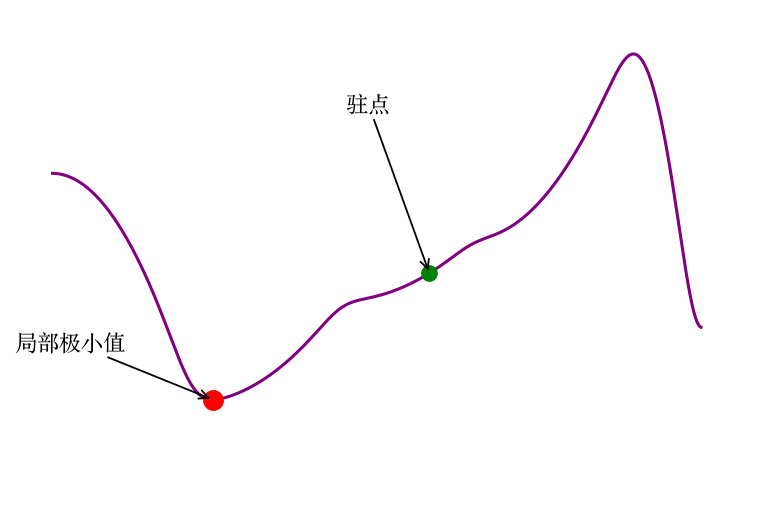
- 局部最优解:陷入局部最优,尤其在非凸函数中,难以找到全局最优解。
- 鞍点:陷入鞍点,梯度为0,导致训练停滞。
- 收敛速度慢:高维或非凸函数中,收敛速度较慢。
- 学习率选择:学习率过大导致震荡或不收敛,过小则收敛速度慢。
# 1.10.2 Momentum:给梯度加上惯性
原始的梯度下降法直接使用当前梯度来更新参数:
而Momentum(动量法)会保存历史梯度并给予一定的权重,使其也参与到参数更新中:
- :历史(负)梯度的加权和
- :历史梯度的权重
- :当前梯度,即
- :学习率
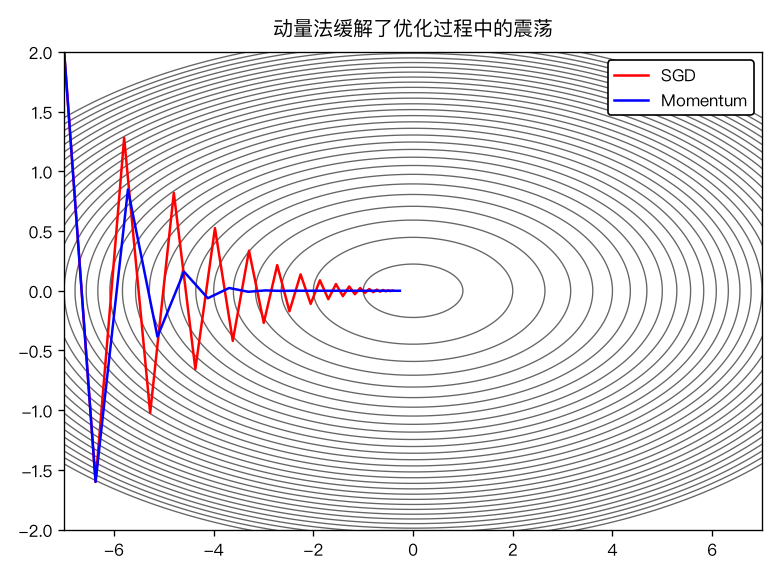
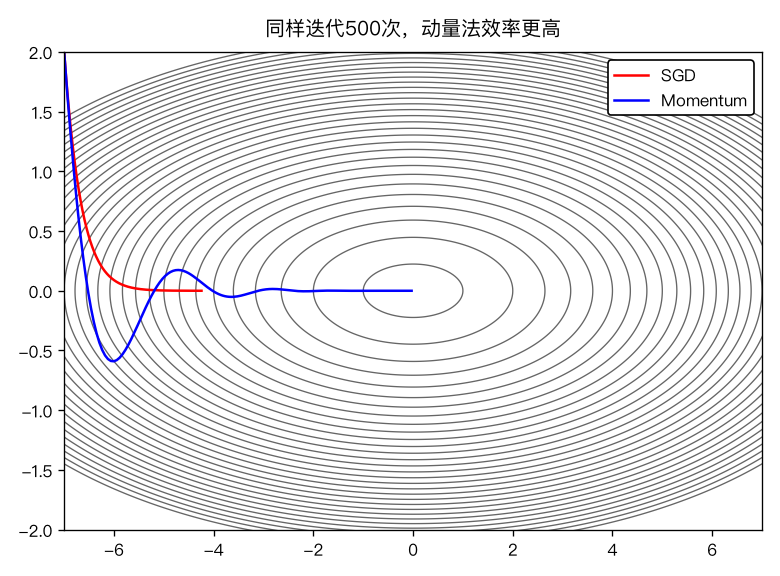
动量法有时能够减缓优化过程中的震荡,加快优化的速度。因为其会累计历史梯度,也可以有效避免鞍点问题。
直觉上就像小球下坡:SGD每步只看当前坡度,在狭长的山谷里会沿两侧崖壁来回震荡;Momentum让小球带上速度,震荡方向的分量正负抵消,前进方向的分量越滚越大——震荡小了,速度还快了。到了鞍点,梯度虽然为0,但惯性还在,小球能直接冲过去。
Momentum的代码实现如下:
import numpy as np


class Momentum:
    def __init__(self, lr=0.01, momentum=0.9):
        self.lr = lr
        self.momentum = momentum
        self.v = None

    def update(self, params, grads):
        if self.v is None:
            self.v = {}
            for key, val in params.items():
                self.v[key] = np.zeros_like(val)

        for key in params.keys():
            self.v[key] = self.momentum * self.v[key] - self.lr * grads[key]
            params[key] += self.v[key]
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
# 1.10.3 学习率衰减:先大步快跑,再小步微调
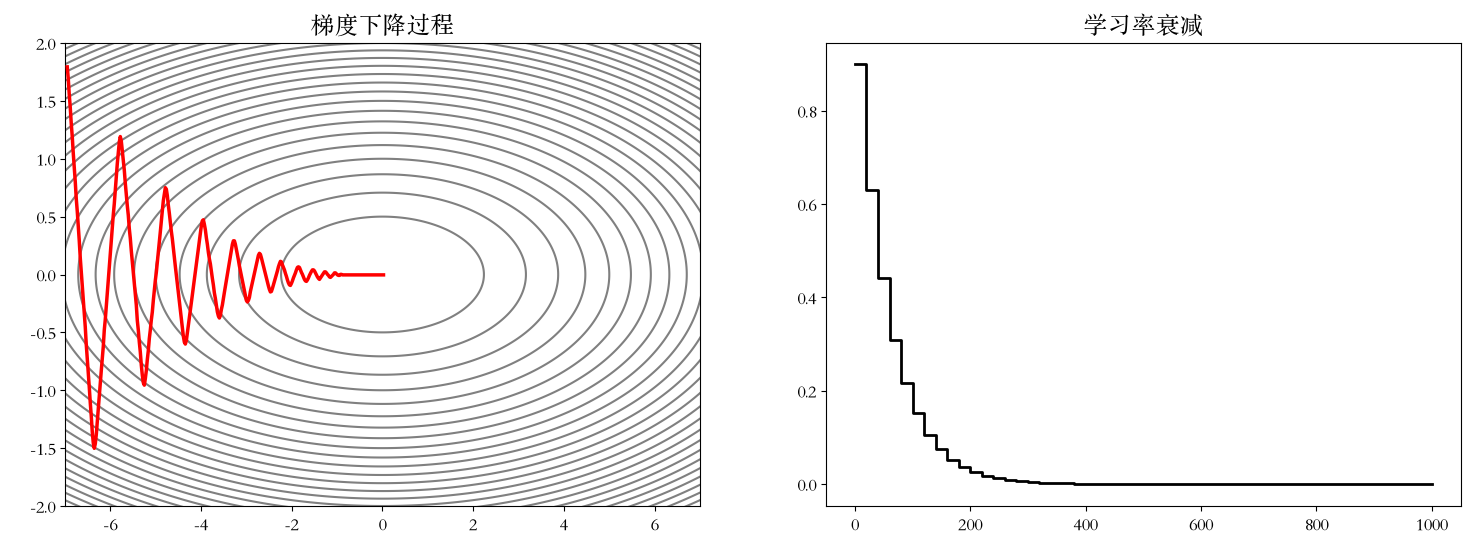
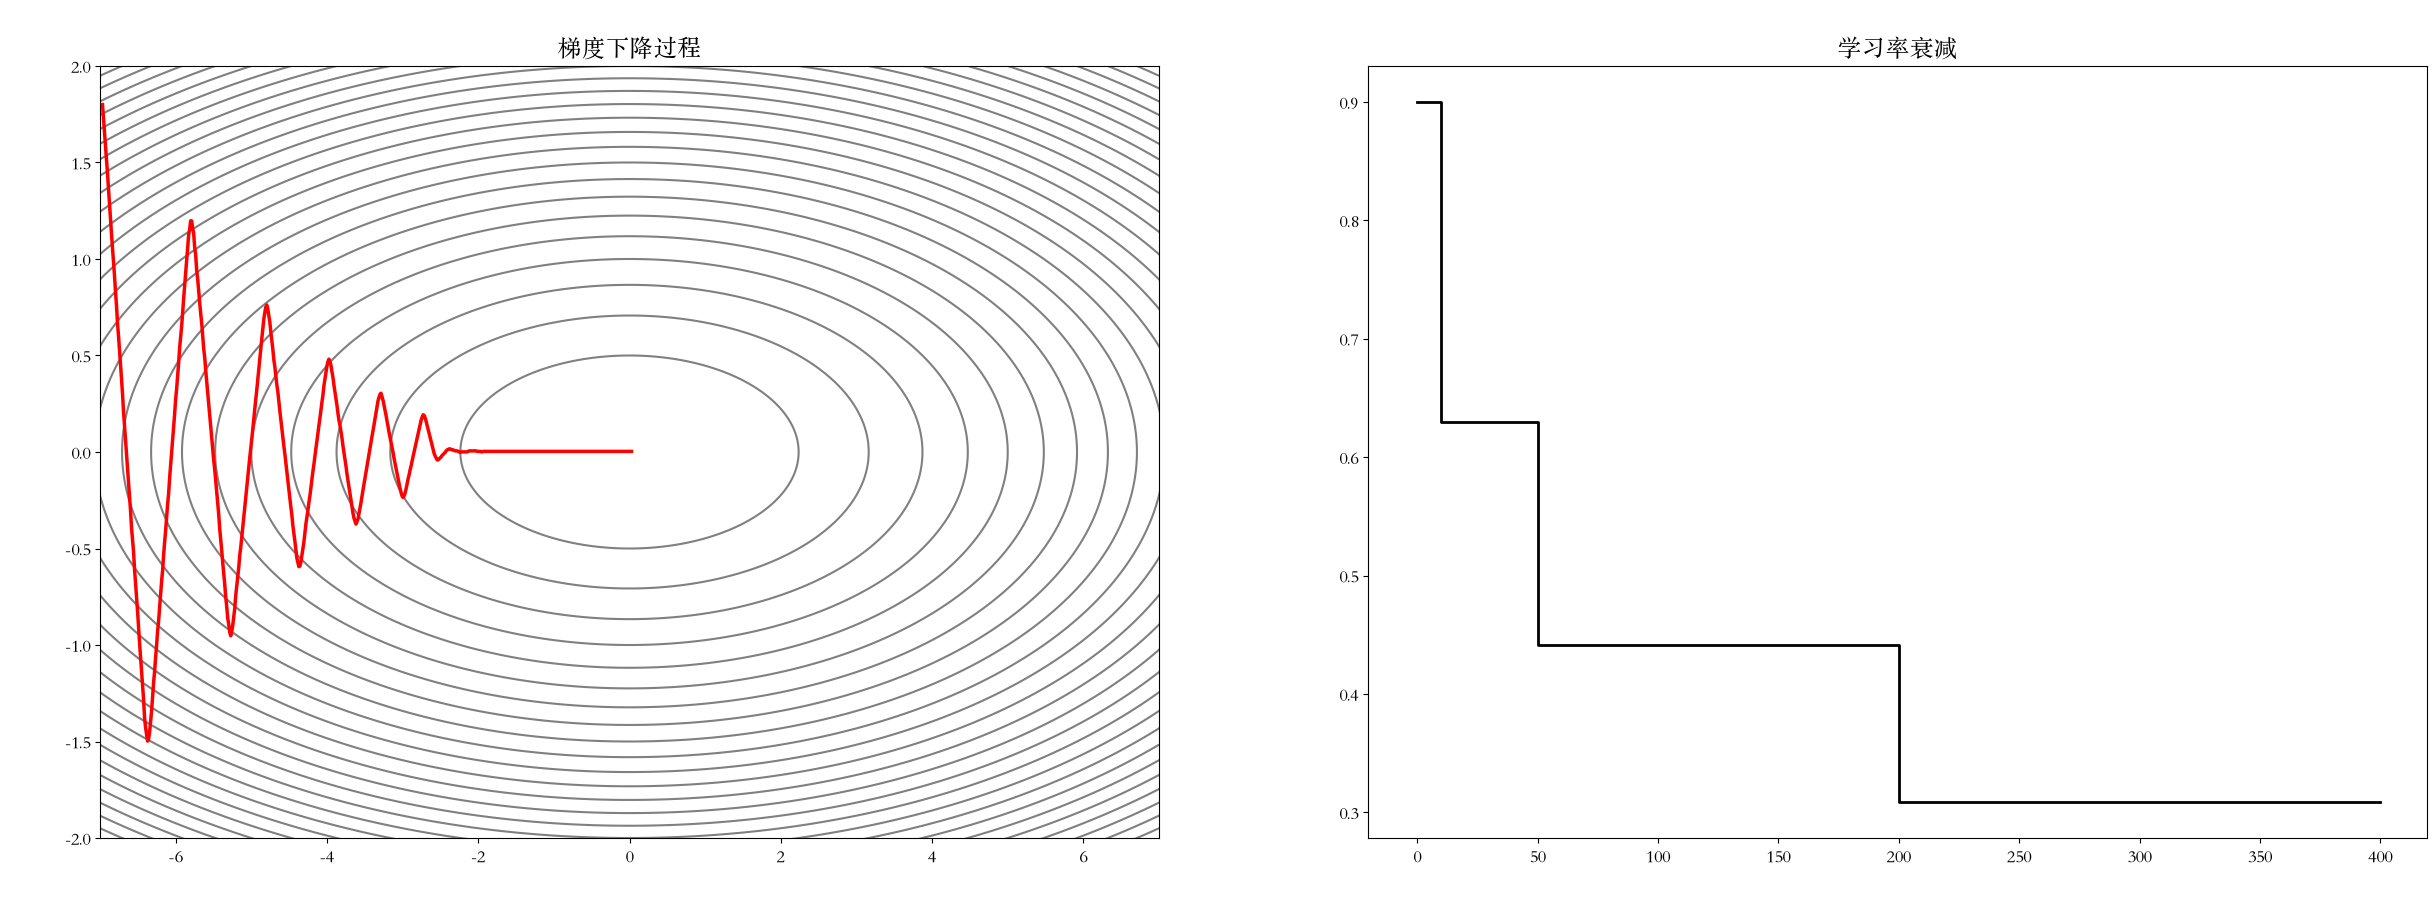
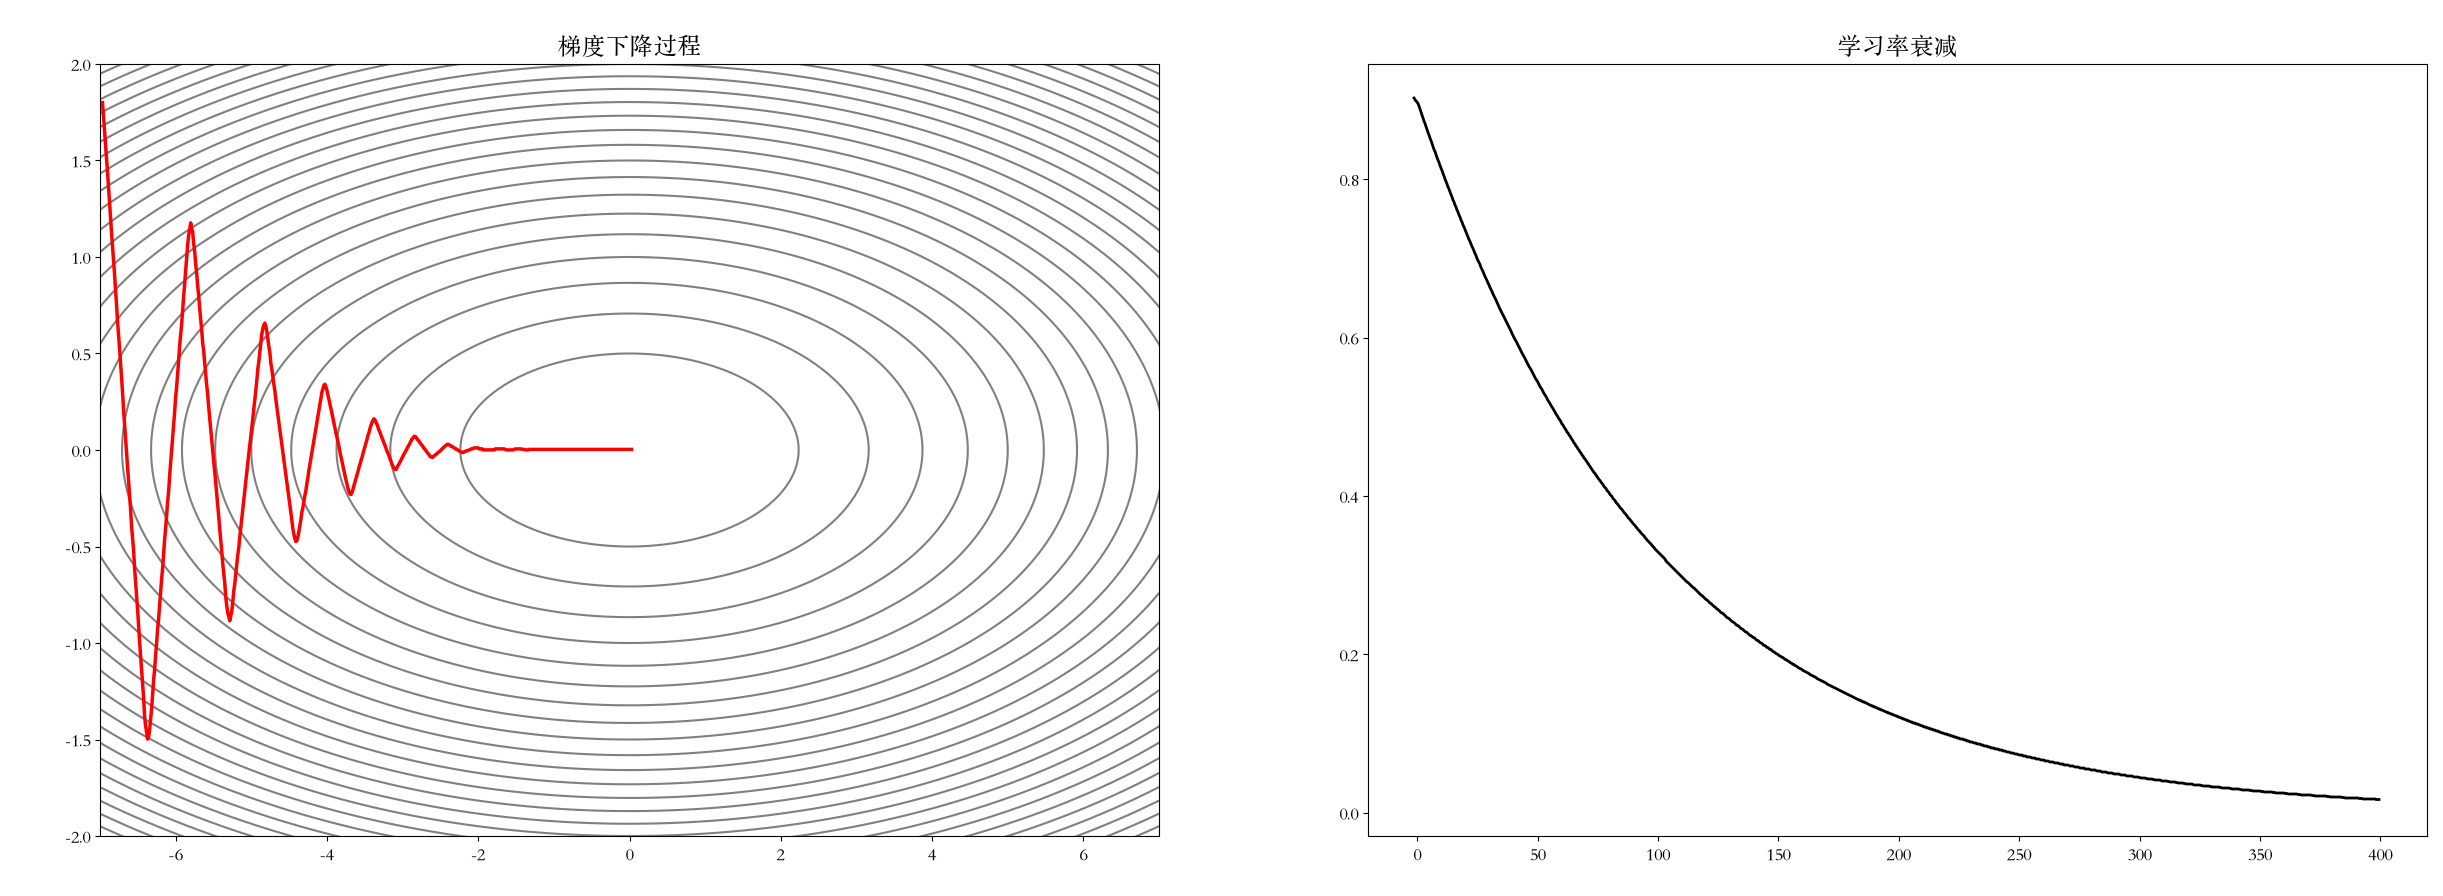
深度学习模型训练中调整最频繁的当属学习率,好的学习率可以使模型逐渐收敛并获得更好的精度。较大的学习率可以加快收敛速度,但可能在最优解附近震荡或不收敛;较小的学习率可以提高收敛的精度,但训练速度慢。学习率衰减是一种平衡策略,初期使用较大学习率快速接近最优解,后期逐渐减小学习率,使参数更稳定地收敛到最优解。
等间隔衰减
每隔固定的训练周期(epoch),学习率按一定的比例下降,也称为"步长衰减"。例如,使学习率每隔20 epoch衰减为之前的0.7:
指定间隔衰减
在指定的epoch,让学习率按照一定的系数衰减。例如,使学习率在epoch达到[10,50,200]时衰减为之前的0.7:
指数衰减
学习率按照指数函数进行衰减。例如,使学习率以0.99为底数,epoch为指数衰减:
# 1.10.4 AdaGrad:给每个参数定制学习率
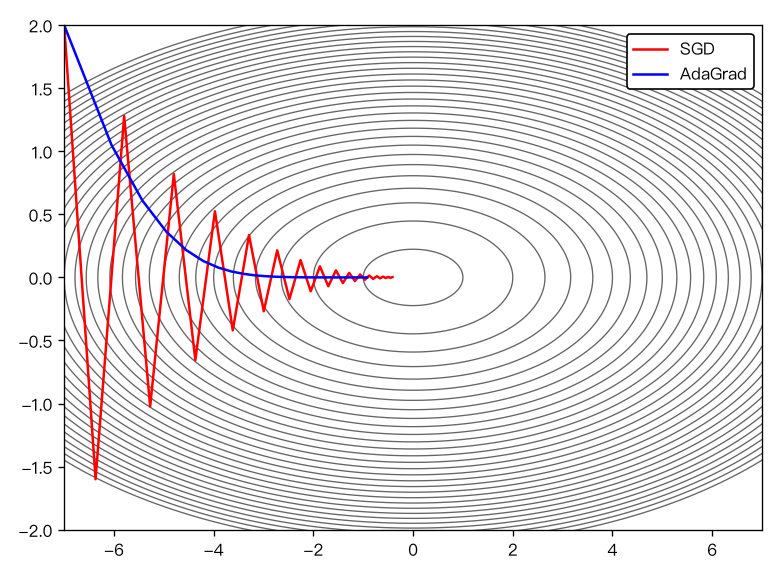
AdaGrad(Adaptive Gradient,自适应梯度)会为每个参数适当地调整学习率,并且随着学习的进行,学习率会逐渐减小。
:历史梯度的平方和
这里表示梯度的逐元素平方(对应位置的元素自己乘自己),即,这里的表示对应矩阵元素的乘法;而逐轮累加这些平方项,所以叫"历史梯度的平方和"。
:一个微小值(常取),防止分母为0,代码里对应
+ 1e-7
直觉上:经常大幅更新的参数,累积得快,有效学习率就衰减得快——"你已经学得很多了,步子收一收";很少更新的参数,小,学习率保持较大——"你还没怎么动,步子放大点"。每个参数各取所需,这就是"自适应"。
使用AdaGrad时,学习越深入,更新的幅度就越小。如果无止境地学习,更新量就会变为0,完全不再更新——这是它最大的毛病,也为后面的RMSProp埋下伏笔。
AdaGrad的代码实现如下:
import numpy as np


class AdaGrad:
    def __init__(self, lr=0.01):
        self.lr = lr
        self.h = None

    def update(self, params, grads):
        if self.h is None:
            self.h = {}
            for key, val in params.items():
                self.h[key] = np.zeros_like(val)

        for key in params.keys():
            self.h[key] += grads[key] * grads[key]
            params[key] -= self.lr * grads[key] / (np.sqrt(self.h[key]) + 1e-7)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
# 1.10.5 RMSProp:忘掉遥远的过去
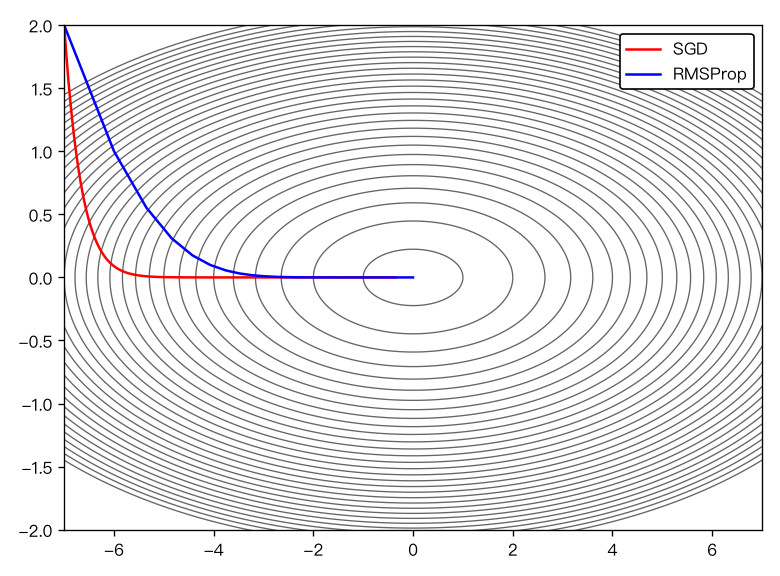
RMSProp(Root Mean Square Propagation,均方根传播)是在AdaGrad基础上的改进,它并非将过去所有梯度一视同仁的相加,而是逐渐遗忘过去的梯度,采用指数移动加权平均,呈指数地减小过去梯度的尺度。
- :历史梯度平方和的指数移动加权平均
- :权重
AdaGrad的是单调递增的,训练越久学习率越小,最后彻底不动;RMSProp给旧梯度乘上衰减系数,让只反映"最近"的梯度尺度,学习率就不会无限衰减下去。改动只有一行,效果却立竿见影——这也是工程里常见的改进模式:不改变思想,只修掉那个最要命的副作用。
# 1.10.6 Adam:动量和自适应学习率的合体
Adam(Adaptive Moment Estimation,自适应矩估计)融合了Momentum和AdaGrad的方法。
- :学习率
- :一阶动量系数和二阶动量系数
- :迭代次数,从1开始
- :一个微小值,防止分母为0(代码实现里通常取)
就是Momentum里的历史梯度加权和(一阶矩),就是AdaGrad/RMSProp里的梯度平方加权(二阶矩);和是对前两个量的偏差修正——因为和初始化为0,训练前期会偏向0,分别除以和把这个偏差校正回来。方向上看动量、步长上看自适应,两头的好处都占了,这就是Adam成为深度学习默认优化器的原因。
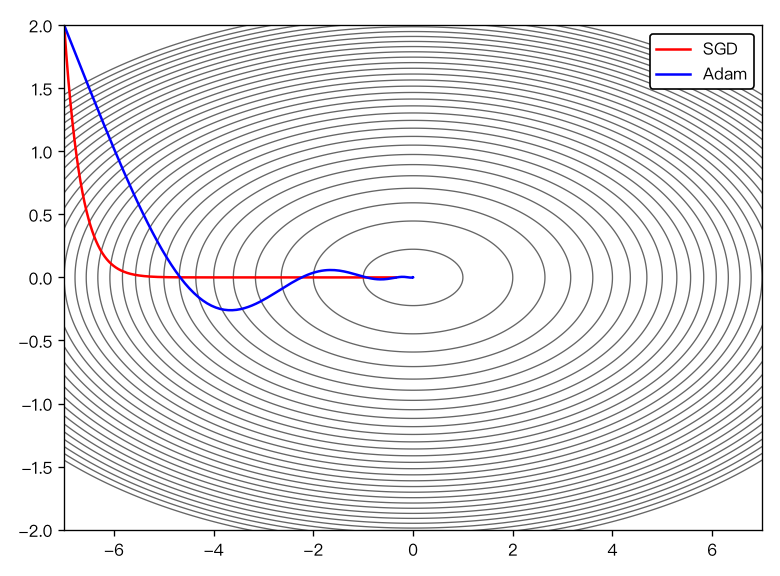
上图对比了五种优化器在一个峡谷形损失曲面上的轨迹:Momentum仍有轻微震荡、AdaGrad越走越慢差点熄火、Adam又快又稳。今天先用直觉理解这些轨迹;等到Day20学会torch.optim后,会用一段统一代码在同一个损失曲面上复现这五条轨迹,五行代码换一个优化器,可以直接对照本节的公式。
上面五张对比图的生成代码如下。峡谷形损失函数,等高线呈扁椭圆(x方向平缓、y方向陡峭,比例)。起点,图1中SGD学习率0.9(y方向每步衰减因子,震荡着缓慢收敛,而Momentum把震荡迅速压掉):
import numpy as np
import matplotlib.pyplot as plt

# -----------------------------------------------------------------------------
# 1. 目标函数与梯度定义: f(x, y) = 0.05 * x^2 + y^2
# -----------------------------------------------------------------------------
def f(x, y):
    return 0.05 * x**2 + y**2

def grad_f(x, y):
    return np.array([0.1 * x, 2.0 * y])

# -----------------------------------------------------------------------------
# 2. 各优化器轨迹算法实现
# -----------------------------------------------------------------------------
def get_sgd_path(init_pos=(-7.0, 2.0), lr=0.9, steps=30):
    pos = np.array(init_pos, dtype=float)
    path = [pos.copy()]
    for _ in range(steps):
        g = grad_f(pos[0], pos[1])
        pos -= lr * g
        path.append(pos.copy())
    return np.array(path)

def get_momentum_path(init_pos=(-7.0, 2.0), lr=0.9, gamma=0.12, steps=30):
    pos = np.array(init_pos, dtype=float)
    v = np.zeros(2)
    path = [pos.copy()]
    for _ in range(steps):
        g = grad_f(pos[0], pos[1])
        v = gamma * v - lr * g
        pos += v
        path.append(pos.copy())
    return np.array(path)

def get_momentum_low_lr_path(init_pos=(-7.0, 2.0), lr=0.01, gamma=0.9, steps=500):
    pos = np.array(init_pos, dtype=float)
    v = np.zeros(2)
    path = [pos.copy()]
    for _ in range(steps):
        g = grad_f(pos[0], pos[1])
        v = gamma * v - lr * g
        pos += v
        path.append(pos.copy())
    return np.array(path)

def get_adagrad_path(init_pos=(-7.0, 2.0), lr=0.95, steps=30, eps=1e-8):
    pos = np.array(init_pos, dtype=float)
    h = np.zeros(2)
    path = [pos.copy()]
    for _ in range(steps):
        g = grad_f(pos[0], pos[1])
        h += g * g
        pos -= (lr / (np.sqrt(h) + eps)) * g
        path.append(pos.copy())
    return np.array(path)

def get_rmsprop_path(init_pos=(-7.0, 2.0), lr=0.1, decay=0.99, steps=100, eps=1e-8):
    pos = np.array(init_pos, dtype=float)
    h = np.zeros(2)
    path = [pos.copy()]
    for _ in range(steps):
        g = grad_f(pos[0], pos[1])
        h = decay * h + (1.0 - decay) * (g * g)
        pos -= (lr / (np.sqrt(h) + eps)) * g
        path.append(pos.copy())
    return np.array(path)

def get_adam_path(init_pos=(-7.0, 2.0), lr=0.1, beta1=0.9, beta2=0.999, steps=200, eps=1e-8):
    pos = np.array(init_pos, dtype=float)
    m = np.zeros(2)
    v = np.zeros(2)
    path = [pos.copy()]
    for t in range(1, steps + 1):
        g = grad_f(pos[0], pos[1])
        m = beta1 * m + (1.0 - beta1) * g
        v = beta2 * v + (1.0 - beta2) * (g * g)
        m_hat = m / (1.0 - beta1**t)
        v_hat = v / (1.0 - beta2**t)
        pos -= (lr / (np.sqrt(v_hat) + eps)) * m_hat
        path.append(pos.copy())
    return np.array(path)

# -----------------------------------------------------------------------------
# 3. 画图通用函数
# -----------------------------------------------------------------------------
def plot_optimizer_comparison(path_red, path_blue, label_red, label_blue, title=None):
    fig, ax = plt.subplots(figsize=(6.5, 4.8), dpi=120)

    # 绘制背景等高线
    x = np.linspace(-7.2, 7.2, 300)
    y = np.linspace(-2.1, 2.1, 300)
    X, Y = np.meshgrid(x, y)
    Z = f(X, Y)

    levels = np.arange(0.05, 4.6, 0.15)
    ax.contour(X, Y, Z, levels=levels, colors='#666666', linewidths=0.8)

    # 绘制优化路径
    ax.plot(path_red[:, 0], path_red[:, 1], color='red', linewidth=1.5, label=label_red)
    ax.plot(path_blue[:, 0], path_blue[:, 1], color='blue', linewidth=1.5, label=label_blue)

    # 设置坐标轴范围与刻度
    ax.set_xlim(-7.0, 7.0)
    ax.set_ylim(-2.0, 2.0)
    ax.set_xticks([-6, -4, -2, 0, 2, 4, 6])
    ax.set_yticks([-2.0, -1.5, -1.0, -0.5, 0.0, 0.5, 1.0, 1.5, 2.0])

    ax.tick_params(axis='both', which='major', labelsize=10)

    if title:
        ax.set_title(title, fontsize=12, pad=10)

    ax.legend(loc='upper right', frameon=True, facecolor='white', edgecolor='black', framealpha=1.0, fontsize=10)

    plt.tight_layout()
    return fig, ax

# -----------------------------------------------------------------------------
# 4. 生成 5 张对应的图像对象
# -----------------------------------------------------------------------------
# 图 1: SGD vs Momentum (高学习率震荡对比)
path_sgd_high = get_sgd_path(lr=0.9, steps=30)
path_mom_high = get_momentum_path(lr=0.9, gamma=0.12, steps=30)
fig1, _ = plot_optimizer_comparison(
    path_sgd_high, path_mom_high,
    'SGD', 'Momentum',
    title='动量法缓解了优化过程中的震荡'
)

# 图 2: SGD vs Momentum (500次迭代低学习率效率对比)
path_sgd_low = get_sgd_path(lr=0.01, steps=500)
path_mom_low = get_momentum_low_lr_path(lr=0.01, gamma=0.9, steps=500)
fig2, _ = plot_optimizer_comparison(
    path_sgd_low, path_mom_low,
    'SGD', 'Momentum',
    title='同样迭代500次,动量法效率更高'
)

# 图 3: SGD vs AdaGrad
path_adagrad = get_adagrad_path(lr=0.95, steps=30)
fig3, _ = plot_optimizer_comparison(
    path_sgd_high, path_adagrad,
    'SGD', 'AdaGrad'
)

# 专门为图 4 和图 5 增加 SGD 迭代次数至 3000 次,使其沿着 y=0 延伸至原点附近
path_sgd_long = get_sgd_path(lr=0.01, steps=3000)

# 图 4: SGD vs RMSProp
path_rmsprop = get_rmsprop_path(lr=0.1, decay=0.99, steps=100)
fig4, _ = plot_optimizer_comparison(
    path_sgd_long, path_rmsprop,
    'SGD', 'RMSProp'
)

# 图 5: SGD vs Adam
path_adam = get_adam_path(lr=0.1, beta1=0.9, beta2=0.999, steps=200)
fig5, _ = plot_optimizer_comparison(
    path_sgd_long, path_adam,
    'SGD', 'Adam'
)

plt.show()
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
85
86
87
88
89
90
91
92
93
94
95
96
97
98
99
100
101
102
103
104
105
106
107
108
109
110
111
112
113
114
115
116
117
118
119
120
121
122
123
124
125
126
127
128
129
130
131
132
133
134
135
136
137
138
139
140
141
142
143
144
145
146
147
148
149
150
151
152
153
154
155
156
157
158
159
160
161
162
163
164
# 1.11 参数初始化:好的开始是成功的一半
优化器决定了参数"怎么走",而参数的初始位置决定了"从哪开始走"——参数初始化方案的选择在神经网络学习中起着举足轻重的作用,它对保持数值稳定性至关重要。此外,初始化方案还能与激活函数的选择有趣地结合在一起:选择哪个激活函数以及如何初始化参数,会决定优化算法收敛的快慢;糟糕的选择可能会让训练直接陷入梯度爆炸或梯度消失。
# 1.11.1 常数初始化:所有权重一个值
所有权重参数初始化为一个常数,即
这里为全1矩阵,为初始化的常数。
注意:将权重初始值设为0将无法正确进行学习。严格地说,不能将权重初始值设成一样的值。因为这意味着反向传播时权重全部都会进行相同的更新,被更新为相同的值(对称的值)。这使得神经网络拥有许多不同的权重的意义丧失了。为了防止"权重均一化"(瓦解权重的对称结构),必须随机生成初始值。
直觉上:同一层的神经元如果初始权重都一样,那它们前向算出的输出一样、反向收到的梯度一样、更新后的值还一样——训练多久都保持完全同步,等于一层只有一个神经元在工作。随机初始化就是要打破这种对称性。
# 1.11.2 单位矩阵初始化
权重参数初始化为单位矩阵,即
这里为单位矩阵,即主对角线上元素为1,其他元素为0。
# 1.11.3 正态分布初始化:最常用的随机化
权重参数按指定均值与标准差正态分布初始化。因为不能直接将权重初始化为相同的常数,所以需要对参数进行随机初始化。最常见的随机分布就是正态分布(也叫高斯分布),记作。
其概率密度函数为:
# 1.11.4 均匀分布初始化:区间内等概率
权重参数在指定区间内均匀分布初始化。均匀分布一般记作。
其概率密度函数为:
# 1.11.5 Xavier初始化(Glorot初始化):输入输出一起考虑
Xavier初始化根据输入和输出的神经元数量调整权重的初始范围,确保每一层的输出方差与输入方差相近。
Xavier正态分布初始化:均值为0,标准差为的正态分布。
Xavier均匀分布初始化:区间内均匀分布。
其中表示输入数,表示输出数。
Xavier初始化参数适用于Sigmoid和Tanh等激活函数,能有效缓解梯度消失或爆炸问题。
思想很直白:前向传播时,每层输出的方差应该和输入差不多,信号才不会逐层放大或衰减;反向传播时同理。同时照顾两个方向,分母里就是。
# 1.11.6 He初始化(Kaiming初始化):为ReLU量身定制
He初始化根据输入的神经元数量调整权重的初始范围。
He正态分布初始化:均值为0,标准差为的正态分布。
He均匀分布初始化:区间内均匀分布。
其中表示输入数。
He初始化参数主要适用于ReLU及其变体(如Leaky ReLU)激活函数。
为什么ReLU要单独一套?因为ReLU会把负半轴的输出直接砍掉,每层输出方差天然减半,Xavier的尺度对它就偏小了;He把方差补上这个因子2,只按输入数定标准差,前向信号在ReLU网络里才能保持稳定。经验法则一句话:Sigmoid/Tanh用Xavier,ReLU家族用He。
# 1.11.7 实验:初始化到底怎样影响各层的激活值
光看公式没感觉,我们搭一个5层的全连接网络(每层100个神经元),喂入1000个随机输入,然后观察每一层激活值的分布——这是《深度学习入门:基于Python的理论与实现》第6章的经典实验。
先看Sigmoid网络,分别用标准差1、标准差0.01和Xavier初始化:
import numpy as np
import matplotlib.pyplot as plt

np.random.seed(42)
x_data = np.random.randn(1000, 100)  # 1000个样本, 100个输入节点
node_num, n_layers = 100, 5

def sigmoid(x):
    return 1 / (1 + np.exp(-x))

def forward(x, scale, activator):
    # 每一层都用scale指定的标准差随机初始化, 记录每层的激活值
    activations = {}
    for i in range(n_layers):
        w = np.random.randn(node_num, node_num) * scale
        x = activator(x @ w)
        activations[i] = x
    return activations

# 三种初始化下的各层激活值直方图(每行一种初始化, 每列一层)
settings = [("W std=1", 1.0), ("W std=0.01", 0.01),
            ("Xavier: sqrt(1/n)", np.sqrt(1.0 / node_num))]
fig, axes = plt.subplots(3, n_layers, figsize=(14, 7))
for row, (title, scale) in enumerate(settings):
    acts = forward(x_data, scale, sigmoid)
    for i in range(n_layers):
        axes[row, i].hist(acts[i].flatten(), bins=30, range=(0, 1), color="purple")
        axes[row, i].set_ylim(0, 12000)
        axes[row, i].set_title(f"{title} layer {i+1}", fontsize=9)
plt.tight_layout()
plt.show()

# 用各层激活值的标准差量化"分布的广度"
for title, scale in settings:
    acts = forward(x_data, scale, sigmoid)
    print(title, "各层激活标准差:", [round(acts[i].std(), 3) for i in range(n_layers)])
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
W std=1 各层激活标准差: [0.459, 0.441, 0.435, 0.435, 0.425]
W std=0.01 各层激活标准差: [0.025, 0.012, 0.012, 0.012, 0.013]
Xavier: sqrt(1/n) 各层激活标准差: [0.209, 0.138, 0.123, 0.122, 0.114]
2
3
三种初始化对应三种典型的"死法":
- 标准差1:每层的直方图都挤在0和1两端——Sigmoid在饱和区导数接近0,反向传播梯度逐层连乘衰减,这就是梯度消失的现场。
- 标准差0.01:所有激活都挤在0.5附近一条细缝里,标准差只有0.01出头——梯度虽然不会消失,但所有神经元输出几乎相同,网络的表达力被浪费掉了。
- Xavier:每层激活都保持适中的广度(标准差0.1~0.2),而且5层之后没有明显收窄——信号和梯度都能顺畅地传到最前面的层。
再看ReLU网络。ReLU会把负半轴输出直接置0,只看"死神经元比例"难以区分不同初始化的效果,我们改看每层激活值的平均值——小标准差初始化会让信号逐层衰减到彻底消失:
relu = lambda z: np.maximum(0, z)
for title, scale in [("W std=0.01", 0.01), ("He: sqrt(2/n)", np.sqrt(2.0 / node_num))]:
    acts = forward(x_data, scale, relu)
    print(title, "各层平均激活值:", [round(acts[i].mean(), 4) for i in range(n_layers)])
2
3
4
W std=0.01 各层平均激活值: [0.0395, 0.0026, 0.0002, 0.0, 0.0]
He: sqrt(2/n) 各层平均激活值: [0.5689, 0.5823, 0.6199, 0.5549, 0.5206]
2
标准差0.01时,平均激活值0.0395 → 0.0026 → 0.0002,到第4层直接归零——前向信号传着传着没了,反向梯度同样传不回去;换成He初始化后,5层的平均激活值始终稳定在0.55上下。这个实验把"Xavier配Sigmoid、He配ReLU"从一条需要背诵的规则,变成了肉眼可见的直方图。
# 1.12 正则化:抑制过拟合的常用方法
初始化让训练稳了,可一旦模型把训练集背得滚瓜烂熟、测试集却跟不上,就轮到正则化出场了。机器学习的问题中,过拟合是一个很常见的问题。
过拟合指的是能较好拟合训练数据,但不能很好地拟合不包含在训练数据中的其他数据。机器学习的目标是提高泛化能力,希望即便是不包含在训练数据里的未观测数据,模型也可以进行正确的预测。因此可以通过正则化方法来抑制过拟合。
常用的正则化方法有权值衰减、Dropout、早停法等。Batch Normalization的首要作用是稳定每层激活值的分布、让训练更快更稳,抑制过拟合只是它的附带效果之一,下面一并介绍。
# 1.12.1 Batch Normalization批量标准化:把每层输入拉回标准分布
Batch Normalization最重要的目的,其实是调整各层的激活值分布使其拥有适当的广度,BN层通常放在线性层(全连接层/卷积层)之后,激活函数之前。它有着以下优点:
- 可以使学习快速进行(允许更高的学习率)
- 不那么依赖初始值(对于初始值不用那么神经质)
- 抑制过拟合(降低Dropout等的必要性)
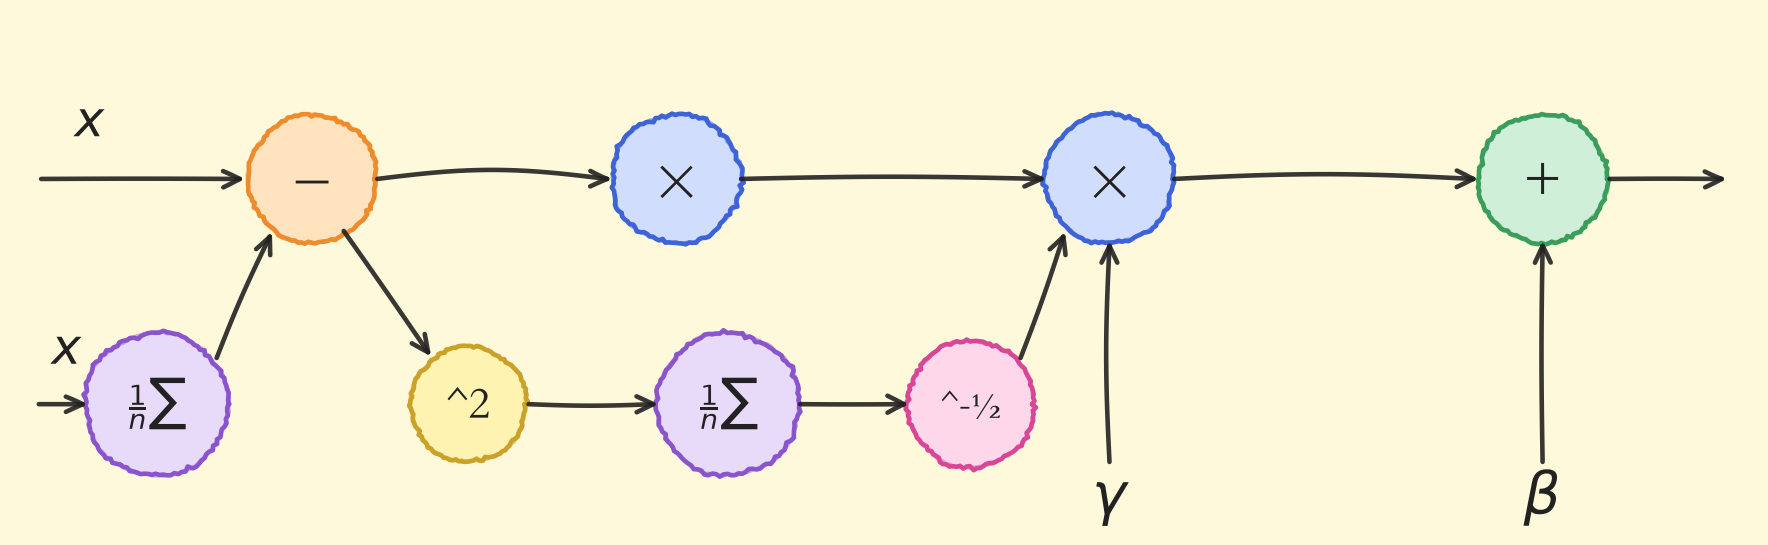
Batch Normalization会先对数据进行标准化,再对数据进行缩放和平移:
- :一个微小值,防止分母为0
- :系数,可通过学习调整
- :偏置,可通过学习调整
为什么标准化之后还要缩放平移?因为强制成均值0、方差1的分布可能不是这一层最想要的(比如会把Sigmoid的输入全压在线性区);和让网络自己学回需要的分布形状——既享受了标准化带来的稳定性,又不损失表达能力。
下图为Batch Normalization的计算图:
# 1.12.2 权值衰减:对大权重开罚单
通过在学习的过程中对大的权重进行"惩罚",可以有效地抑制过拟合,这种方法被称为权值衰减。因为很多过拟合产生的原因,就是权重参数取值过大。
一般会对损失函数加上一个权重的范数;最常见的就是L2范数的平方:
- :表示权重的L2范数,即
- :控制正则化强度的超参数。
惩罚项求导之后得到;所以在求权重梯度时,需要为之前误差反向传播法的结果,再加上。
直觉上:过拟合的模型往往靠某几个特别大的权重硬背训练数据;加了惩罚项之后,梯度里多了这一项,权重越大被往回拉的力越强——没有足够证据(数据梯度)支撑的权重会被逐渐压回0附近,模型被迫用更"平滑"的方式拟合数据,泛化自然变好。
# 1.12.3 Dropout随机失活:每次训练一个子网络
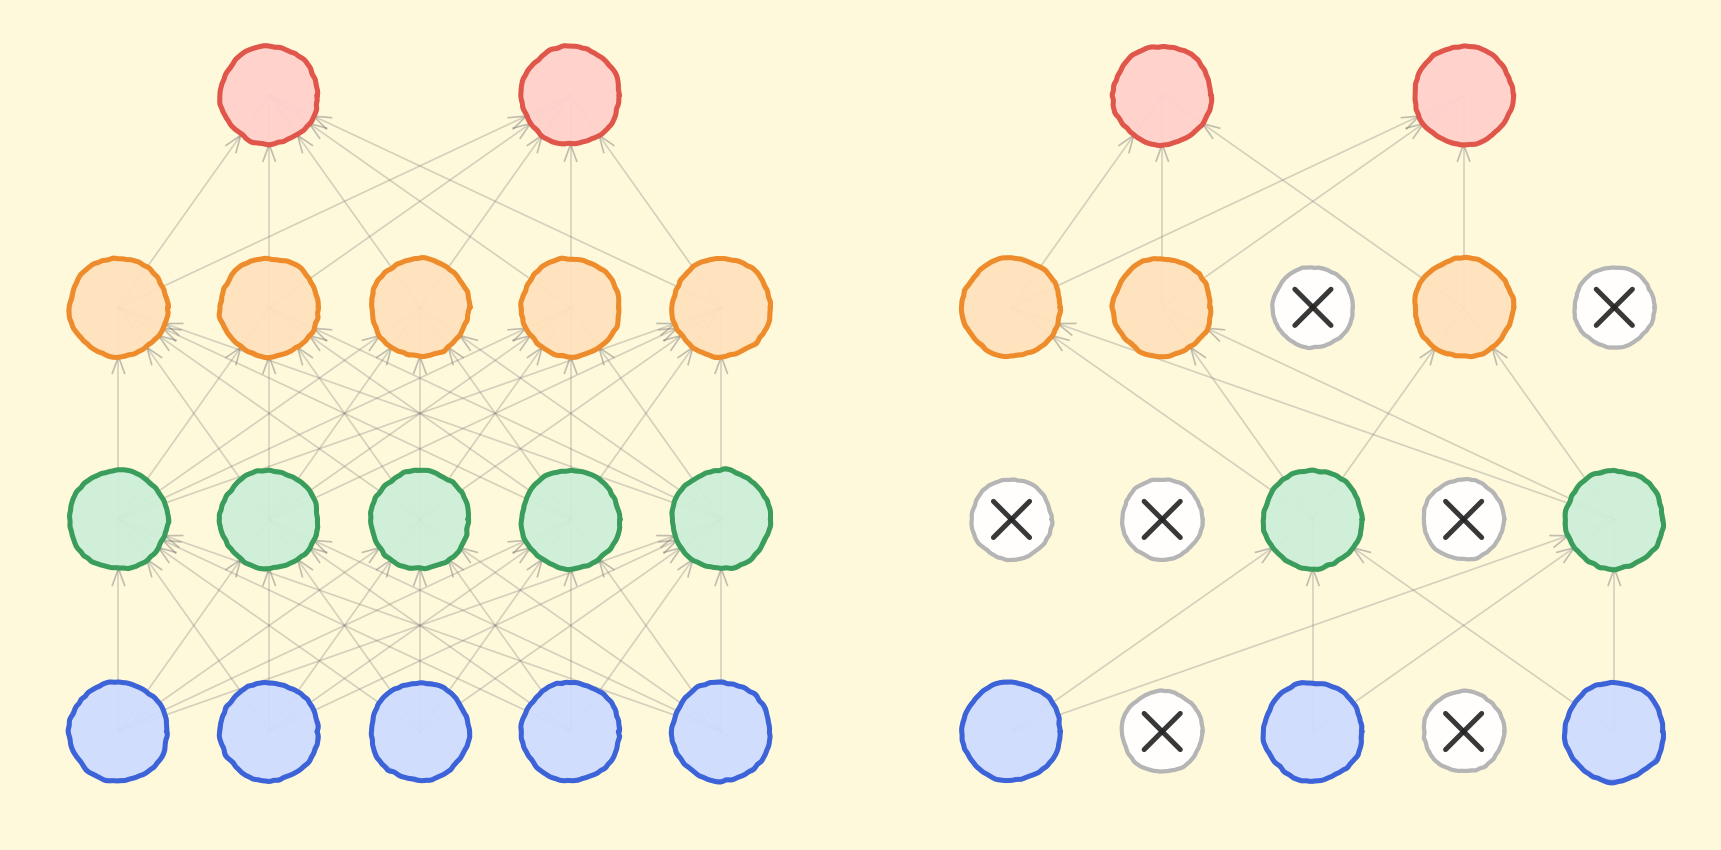
Dropout(随机失活,暂退法)是一种在学习的过程中随机关闭神经元的方法。
训练时以概率随机关闭神经元,迫使网络不依赖特定神经元,增强鲁棒性,同时未被关闭的神经元的输出值以的比例进行缩放,以保持期望值不变;而测试时通常不使用Dropout,即所有神经元保持激活状态并且不进行缩放。
Dropout会有隐式集成的效果(每次迭代训练不同的子网络,测试时近似集成效果)。
Dropout在全连接层和卷积层均适用,尤其对大规模网络效果显著。Dropout通常放在激活函数之后、下一层线性层(全连接层/卷积层)之前。
为什么要乘?假设某层原来输出期望是,随机关掉比例后,不缩放的话期望变成——训练和测试的数值尺度就对不上了。乘上之后期望恢复为,测试时不用改任何代码。而"每次迭代关掉不同的神经元"意味着每次实际训练的都是一个不同的子网络,测试时全体神经元一起工作,就近似了个子网络的集成投票——一个模型白嫖了集成学习的效果。
# 1.12.4 早停法:在验证误差抬头之前收手
训练神经网络时,训练误差几乎一定会一直下降,但验证误差往往先降后升——后面那段上升就是模型开始背训练集、泛化变差的信号。**早停法(Early Stopping)**的做法很朴素:训练过程中持续监控验证集误差,记录下验证误差最低的那组参数;当验证误差连续若干轮(称为patience)不再刷新最低纪录,就停止训练并返回记录的最佳参数。
早停法有一个漂亮的解释:训练步数本身等价于一种隐式的正则化——训练越久参数可以走得越远、权重可以长得越大;在恰当的步数停下,等效于把权重约束在初始值附近的一个区域内,和权值衰减限制的思路殊途同归。
实现早停有三个要点缺一不可:
- 判定信号必须是验证集误差,不能用训练误差(它永远在降);
- 要保存最佳时刻的参数,而不是停下时刻的参数——停下时验证误差往往已经反弹了;
patience要给足:验证误差偶尔波动一两轮很正常,一上升就停会误杀。
今天只建立概念,带验证循环、最佳权重保存和patience计数的完整PyTorch实现,放在Day21训练工程化里统一给出。
# 1.12.5 实验:权值衰减把权重从20压回2
权值衰减到底有没有用?我们构造一个注定过拟合的场景:40维特征里只有8维真正有用,330个样本只取30个训练,却配一个200个隐藏单元的大网络。对比有无权值衰减时训练集/测试集准确率的变化:
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split

# 40维特征里只有8个真有用, 330个样本只拿30个训练——刻意制造过拟合
X, y = make_classification(n_samples=330, n_features=40, n_informative=8,
                           n_redundant=2, n_classes=3, n_clusters_per_class=1,
                           random_state=42)
x_train, x_test, y_train, y_test = train_test_split(
    X, y, train_size=30, stratify=y, random_state=42)

def one_hot(y, k):
    Y = np.zeros((len(y), k))
    Y[np.arange(len(y)), y] = 1
    return Y
Ytr = one_hot(y_train, 3)

def softmax(a):
    a -= a.max(axis=1, keepdims=True)
    e = np.exp(a)
    return e / e.sum(axis=1, keepdims=True)

def accuracy(x, y, W1, b1, W2, b2):
    a1 = np.maximum(0, x @ W1 + b1)
    return (softmax(a1 @ W2 + b2).argmax(axis=1) == y).mean()

def train(lmbda, steps=8000, lr=0.1):
    # lmbda即权值衰减系数lambda, 梯度上额外加一项lmbda*W
    rng = np.random.default_rng(1)
    W1 = rng.normal(0, np.sqrt(2/40), (40, 200)); b1 = np.zeros(200)
    W2 = rng.normal(0, np.sqrt(2/200), (200, 3));  b2 = np.zeros(3)
    m = len(x_train)
    hist = []
    for t in range(steps):
        z1 = x_train @ W1 + b1
        a1 = np.maximum(0, z1)
        p = softmax(a1 @ W2 + b2)
        if t % 200 == 0:
            hist.append((accuracy(x_train, y_train, W1, b1, W2, b2),
                         accuracy(x_test,  y_test,  W1, b1, W2, b2)))
        dz = (p - Ytr) / m
        dW2 = a1.T @ dz + lmbda * W2   # 权值衰减项
        db2 = dz.sum(axis=0)
        da1 = dz @ W2.T
        dz1 = da1 * (z1 > 0)
        dW1 = x_train.T @ dz1 + lmbda * W1
        db1 = dz1.sum(axis=0)
        W1 -= lr * dW1; b1 -= lr * db1
        W2 -= lr * dW2; b2 -= lr * db2
    return np.array(hist), (W1, W2)

hist_no, (W1a, W2a) = train(lmbda=0.0)    # 无权值衰减
hist_wd, (W1b, W2b) = train(lmbda=0.01)   # lambda=0.01

steps = np.arange(0, 8000, 200)
plt.plot(steps, hist_no[:, 0], "r-", label="train, no decay")
plt.plot(steps, hist_no[:, 1], "r--", label="test, no decay")
plt.plot(steps, hist_wd[:, 0], "b-", label="train, weight decay")
plt.plot(steps, hist_wd[:, 1], "b--", label="test, weight decay")
plt.xlabel("steps")
plt.ylabel("accuracy")
plt.legend()
plt.show()

print("无衰减   训练/测试: %.3f/%.3f, 权重L2范数: %.1f, %.1f"
      % (hist_no[-1, 0], hist_no[-1, 1], np.linalg.norm(W1a), np.linalg.norm(W2a)))
print("lambda=0.01 训练/测试: %.3f/%.3f, 权重L2范数: %.1f, %.1f"
      % (hist_wd[-1, 0], hist_wd[-1, 1], np.linalg.norm(W1b), np.linalg.norm(W2b)))
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
无衰减   训练/测试: 1.000/0.710, 权重L2范数: 20.1, 3.2
lambda=0.01 训练/测试: 1.000/0.730, 权重L2范数: 1.9, 2.0
2
两组训练准确率都冲到了100%——30个训练样本被200个隐藏单元彻底背了下来。但测试准确率只有71%,训练和测试之间近30个百分点的鸿沟就是过拟合。加上的权值衰减后,训练准确率没受影响,测试准确率反而升到73%;更直观的是权重的L2范数:第一层从20.1被压到1.9。没有数据梯度支撑的大权重被"罚单"拉了回来,模型不再靠个别超大权重硬背样本。
# 小结
本节把Day17的数值梯度换成了反向传播:用计算图描述前向、用链式法则沿图反推,一次前向加一次反向就能拿到全部梯度,ReLU、Sigmoid、Affine、Softmax-with-Loss各层都落地成forward/backward两个方法。深度让网络可训深,但也让梯度在层层连乘中走向两个极端——消失或爆炸,这是深层网络难训练的根因。围绕"稳住训练"有三条线:优化器从SGD走到Adam(Momentum管方向惯性、AdaGrad/RMSProp管步长自适应、Adam合二为一,实践中Adam常作默认);初始化用Xavier配Sigmoid/Tanh、He配ReLU家族,让各层激活保持适度广度;正则化用权值衰减压大权重、Dropout做子网络集成、早停法在验证误差抬头前收手,BN则从分布层面稳住每层输入。但到目前为止,所有代码还是NumPy手搓的:每一层都要自己写forward/backward、自己保存中间变量。Day19正式进入PyTorch:用张量替代ndarray、用autograd替代手写反向,训练代码将从几百行压到几十行;Day20再用torch.optim把本节这些优化器一一复现。