
# NLP刻意练习Day1:词嵌入与RNN —— 让计算机听懂自然语言
所属专栏: 凯尔森的10000h刻意练习
Slogan: 一个36岁程序员, 研究生(学硕),前世界500强top20软件开发Java工程师,用10000小时深耕AI, 目标Top10 AI资深工程师, 全程日更记录。
输入法凭什么刚打出"床前明月光",就能猜出下一句是"疑是地上霜"?机器翻译凭什么把一串中文变成意思相同的英文?
这是NLP系列的第一篇。在此前的深度学习基础段里,我们学会了MLP与CNN:前者处理表格,后者守住图像的空间结构。但还有一类同样重要的数据——序列:一句话是词的序列,一首诗是字的序列,序列一旦被打乱,意义就变了("狗咬人"和"人咬狗"是两回事)。处理这类数据,需要一种带"记忆"的网络。
今天的路线图:先回顾自然语言处理的三条历史路线→把词变成向量的词嵌入(nn.Embedding)→带记忆的循环神经网络RNN(nn.RNN)→最后做一个完整实战:让RNN读古诗,然后自己写诗。后续篇章里,RNN的记忆短板会引出LSTM/GRU,注意力机制会引出Transformer,最终走到大模型——序列这条路,是通往大模型的主线。
本篇内容原属深度学习日更Day20,自Day20纯化CNN后迁入NLP系列独立连载。
# 1.1 自然语言处理概述:让计算机听懂"软语言"
我们平日使用的语言,如汉语或英语,称为自然语言。自然语言处理(Natural Language Processing, NLP)的目标就是让计算机理解人类语言,进而完成对我们有帮助的事情。
说到计算机可以理解的语言,我们可能会想到编程语言或者标记语言。这些语言的语法定义可以唯一性地解释代码含义,计算机也能根据确定的规则分析代码——编程语言是一种机械的、缺乏活力的语言,换句话说,它是一种**"硬语言"。而汉语、英语等自然语言是"软语言"**:含义和形式会灵活变化,并且会不断出现新的词语或新的含义,要让计算机去理解自然语言,使用常规方法是无法办到的。历史上人们走过三条路线。
# 1.1.1 基于同义词词典的方法
具有相同含义(同义词)或类似含义(近义词)的单词,可以归到同一个类别中;再根据单词"整体-部分"或者"上位-下位"关系,构建出层级的树状图。这样就可以构成一个庞大的"单词网络",用它教会计算机单词之间的关系,从而计算出单词的"相似度"。英文世界最著名的这类资源是WordNet,中文有知网(HowNet)、同义词词林等。
主要缺点:
- 需要人工逐个定义单词之间的相关性,非常费时费力
- 新词不断出现,语言不断变化,词典维护成本极高
- 在表现力上也有限制
# 1.1.2 基于计数的方法
大量的文本数据,构成了语料库(corpus)。我们的目的,就是从语料库中自动且高效地提取出语言的"本质",最简单的做法就是统计词频:
- 分词:对词进行统计,首先需要对文本内容进行切分,找出一个个基本单元
- 词关联ID:给单词标上一个ID,构建单词和ID的关联字典(称为词表)
- 词向量化:用一个固定长度的向量来表示单词,也称为词的分布式表示
对每一个词,统计它周围出现了什么单词、出现了多少次(称为上下文),把这些词频统计出来就构成了一个向量,这个向量就可以表示当前的词了,称为词向量(word vector)。所有词对应的向量汇总起来就是一个矩阵,被称为共现矩阵(co-occurrence matrix)。
主要缺点:对所有词进行向量化表示的计算复杂度极高,且得到的向量大多很稀疏。
# 1.1.3 基于推理的方法
除了基于计数的方法,还可以使用推理的方法把词用向量表示出来。我们希望在已知上下文的前提下,"推测"当前位置的词是什么。利用神经网络,接收上下文信息作为输入,通过模型计算,输出各个单词可能出现的概率,从而就可以根据上下文预测该出现的单词了。word2vec是这条路线的代表,而今天的RNN古诗生成,本质上也是"根据前面的字预测下一个字"——这条路线正是现代语言模型乃至大模型的理论源头。
# 1.2 词嵌入层:把词变成向量
# 1.2.1 什么是词嵌入
自然语言是由文字构成的,而语言的含义是由单词构成的,即单词是含义的最小单位。为了让计算机理解自然语言,首先要让它理解单词含义。
词向量是用于表示单词意义的向量,也可以看作词的特征向量。将词映射到向量的技术称为词嵌入(Word Embedding)。
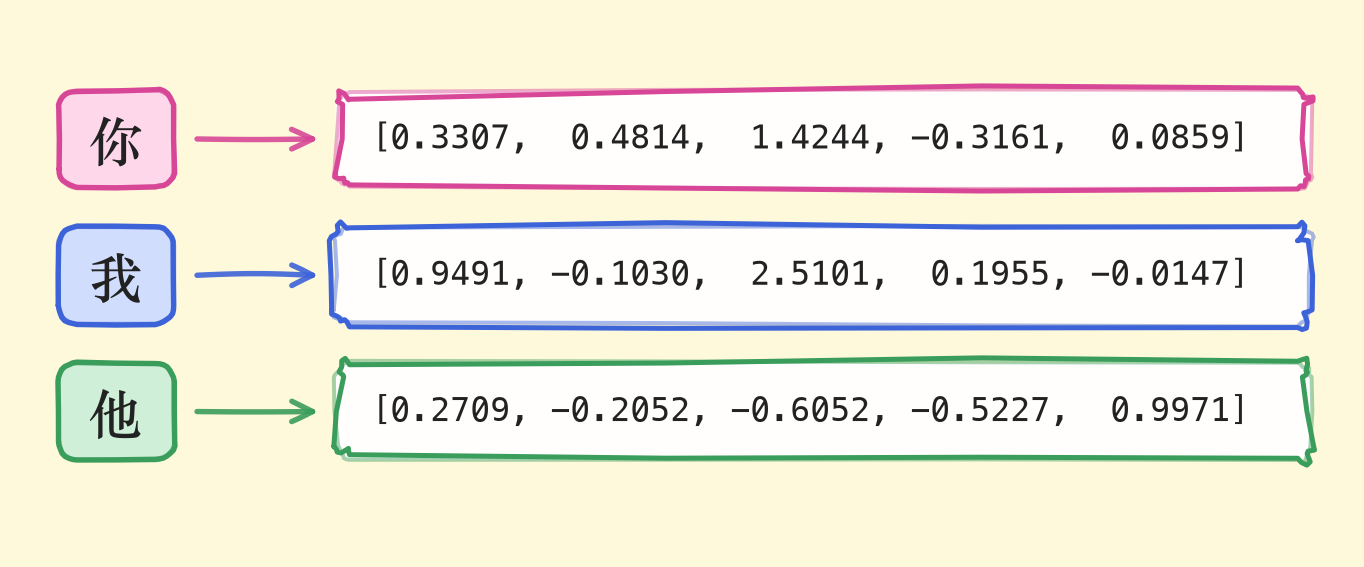
还有一种使用向量表示单词意义的方式是独热向量。独热向量很容易构建,但通常不是一个好的选择:一个主要原因是独热向量不能准确表达不同词之间的相似度,比如使用余弦相似度来表示两个词之间的相似程度,由于任意两个不同词的独热向量之间的余弦相似度为0,所以独热向量不能编码词之间的相似性;另一个原因是随着词汇量的增大,独热向量表示的向量大小也会增大,在词汇量较大的情况下会消耗大量的存储资源与计算资源。
词嵌入则相反:它用一个固定维度的稠密向量(比如128维)表示任意多的词,意思相近的词在向量空间里距离也近,词表再大也不影响向量维度。
将词转换为词向量时分三步:
- 首先需要对文本进行分词,再根据需要进行清洗和标准化
- 构建词表(Vocabulary),每个词对应一个索引
- 使用词嵌入矩阵将词索引转换为词向量
# 1.2.2 API使用:nn.Embedding
可使用torch.nn.Embedding来初始化词嵌入矩阵:
torch.nn.Embedding(num_embeddings, embedding_dim)
# num_embeddings:词的数量(词表大小)
# embedding_dim:词向量的维度
2
3
它的本质是一个形状为(词表大小, 词向量维度)的查找表:给它整数索引,它返回该索引对应的那一行向量。先安装jieba库用于中文分词:pip install jieba。然后跑一个完整例子:分词→过滤停用词→建词表→打印每个词的5维词向量。
import torch
import torch.nn as nn
import jieba

# 设置随机种子, 保证结果可复现
torch.manual_seed(42)
text = "自然语言是由文字构成的,而语言的含义是由单词构成的。即单词是含义的最小单位。因此为了让计算机理解自然语言,首先要让它理解单词含义。"
# 自定义停用词和标点符号
stopwords = {"的", "是", "而", "由", ",", "。", "、"}
# 分词, 过滤停用词和标点, 去重, 构建词表(sorted保证每次运行词表顺序一致)
words = [word for word in jieba.lcut(text) if word not in stopwords]
vocab = sorted(set(words))
# 构建词到索引的映射
word2idx = {word: idx for idx, word in enumerate(vocab)}
# 初始化嵌入层
embed = nn.Embedding(num_embeddings=len(word2idx), embedding_dim=5)
# 打印前6个词的词向量
for idx, word in enumerate(vocab[:6]):
    word_vec = embed(torch.tensor(idx))  # 通过索引获取词向量
    print(f"{idx:>2}:{word}\t{word_vec.detach().numpy().round(3)}")
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
 0:为了	[ 1.927  1.487  0.901 -2.106  0.678]
 1:单位	[-1.235 -0.043 -1.605 -0.752  1.649]
 2:单词	[-0.392 -1.404 -0.728 -0.559 -0.769]
 3:即  	[ 0.762  1.642 -0.16  -0.497  0.44 ]
 4:含义	[-0.758  1.078  0.801  1.681  1.279]
 5:因此	[ 1.296  0.61   1.335 -0.232  0.042]
2
3
4
5
6
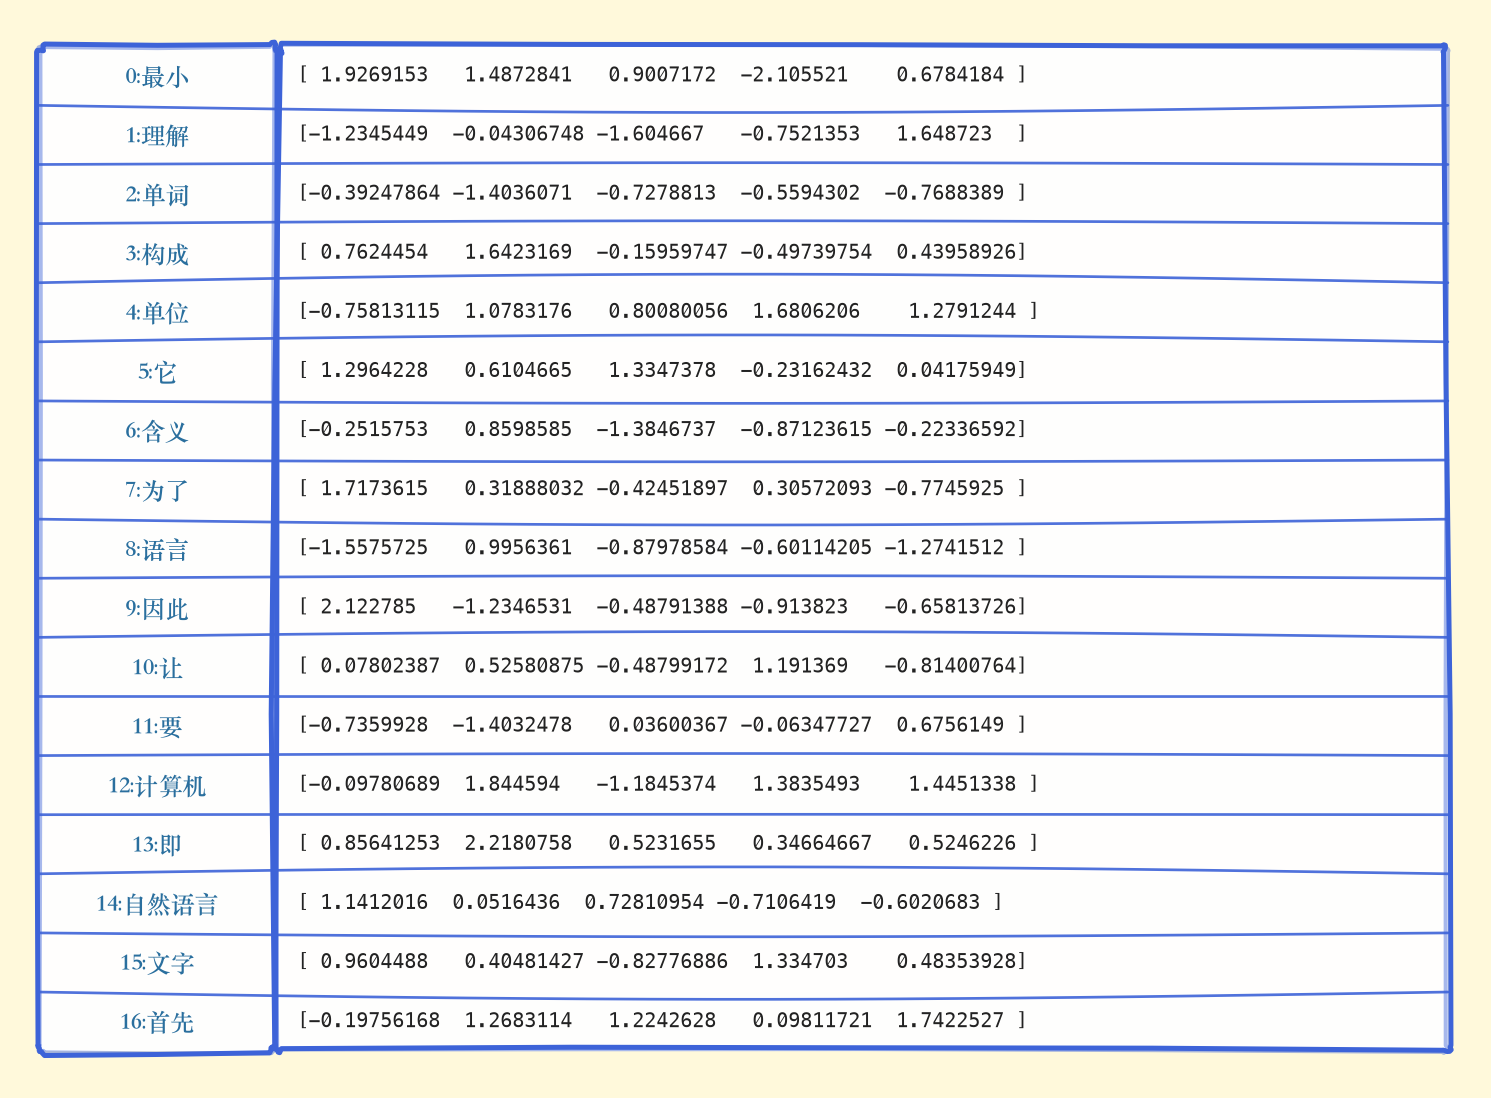
此刻这些向量还是随机数——词向量的真正含义要靠后续任务(预测、翻译、写诗)的梯度反传,一点点"训"出来。
# 1.3 循环网络层:给网络装上"记忆"
# 1.3.1 RNN层介绍
文本是连续的,具有序列特性——序列被重排可能就会失去原有的意义。比如"狗咬人"这段文本具有序列关系,如果文字的序列颠倒,可能就会表达不同的意思。
此前接触的神经网络都是前馈型神经网络。前馈(feedforward)是指网络的传播方向是单向的:将输入信号传给下一层,下一层接收到信号后传给下下一层,然后再传给下下下一层……信号仅在一个方向上传播。前馈网络结构简单、易于理解,不过它存在一个大问题:不能很好地处理时间序列数据,更确切地说,单纯的前馈网络无法充分学习时序数据的性质。于是,**循环神经网络(Recurrent Neural Network, RNN)**应运而生。
RNN层具有环路,通过环路数据可以在层内循环。向时序数据输入层中,相应地会输出。
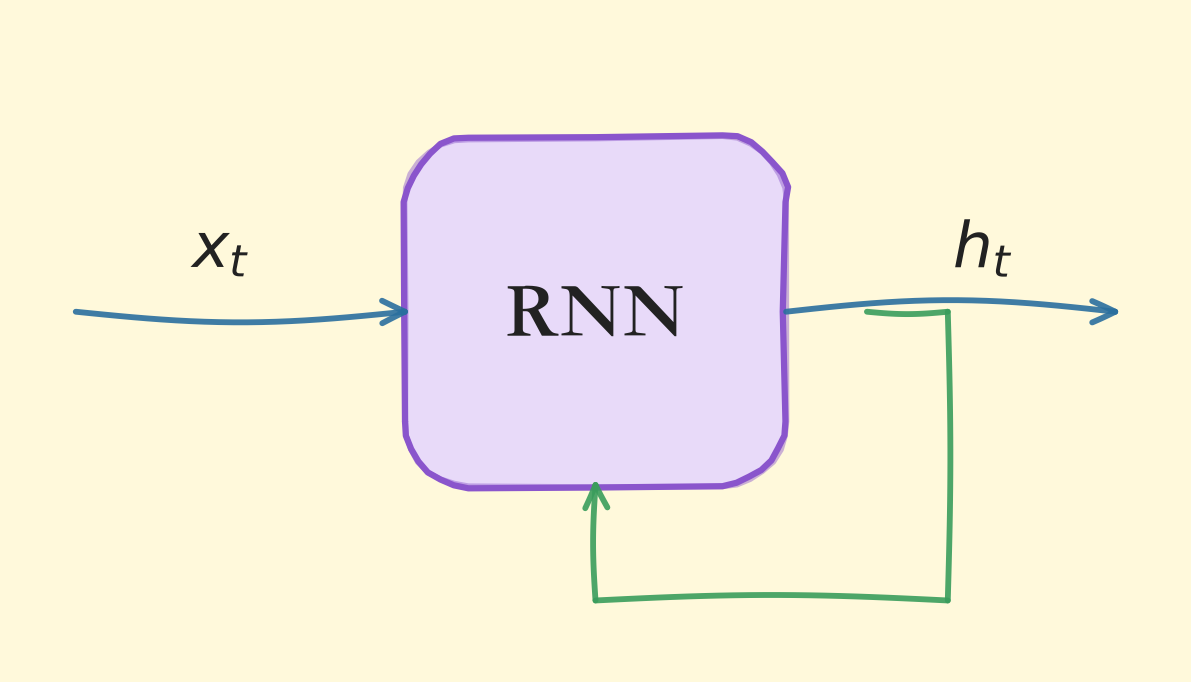
RNN层的循环按时序展开:
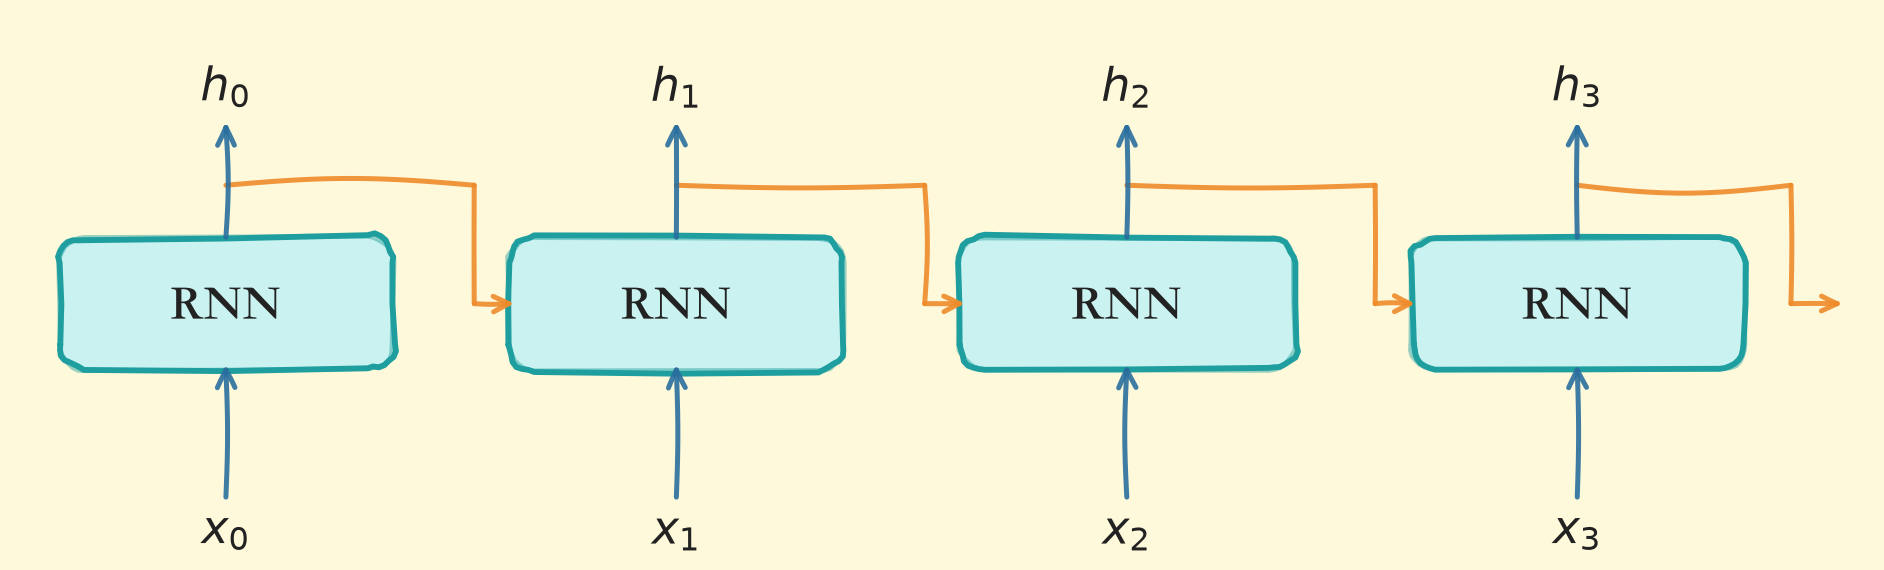
由图可知,各个时刻的RNN层接收传给该层的输入和前一个时刻RNN层的输出,据此计算当前时刻的输出:
RNN层有2个权重:与输入运算的权重,和与前一时刻隐状态运算的权重。注意整条序列共享同一套权重——这与CNN里一个卷积核扫遍全图的权值共享思想如出一辙。执行完乘积求和后用tanh转换,结果就是时刻的输出。隐状态就是RNN的记忆——前面看过的内容,全都压缩在这个向量里,随时间步一路传递。
# 1.3.2 API使用:nn.RNN
torch.nn.RNN(input_size, hidden_size, num_layers, batch_first=False)
# input_size:输入数据的特征数量(词向量维度)
# hidden_size:隐藏状态的特征数量
# num_layers:堆叠的RNN层数, 前一层的输出序列作为下一层的输入
# batch_first:为True时输入输出形状用(batch, seq_len, feature), 与DataLoader默认一致
2
3
4
5
调用时传入输入序列和初始隐状态,得到每一步的输出序列和最后一步的隐状态:
import torch

# batch_first=True: 所有张量第0维都是batch, 和DataLoader吐出的数据天然对齐
rnn = torch.nn.RNN(input_size=8, hidden_size=16, num_layers=2, batch_first=True)
input = torch.rand(3, 5, 8)     # (batch_size=3, seq_len=5, input_size=8)
h0 = torch.randn(2, 3, 16)      # (num_layers=2, batch_size=3, hidden_size=16)
output, hn = rnn(input, h0)
print(output.shape)  # 每个时刻都有一个输出
print(hn.shape)      # hn只保留最后一个时刻的隐状态
2
3
4
5
6
7
8
9
torch.Size([3, 5, 16])
torch.Size([2, 3, 16])
2
有一个高频坑必须说清楚:隐状态h0/hn的形状永远是(num_layers, batch_size, hidden_size),即使设了batch_first=True,batch维也不会挪到最前面——因为它没有序列维,不存在歧义。如果用默认的batch_first=False,输入输出则是(seq_len, batch, input_size),而DataLoader给出的数据是batch在最前的,两者直接相接会把batch维和序列维搞反(模型不报错,但训练完全学歪),所以实战中建议始终显式写上batch_first=True。
另外要诚实地指出朴素RNN的短板:梯度沿时间步反传时同样要经过导数的连乘,序列一长就会梯度消失,RNN会"失忆"——这正是后续LSTM、GRU要用门控机制解决的问题。
# 1.4 案例:古诗生成
压轴实战:让RNN读一堆古诗,然后自己写诗。整体思路是字级语言模型——给模型前n个字,让它猜第n+1个字,训练时用"右移一位"的序列做目标,生成时循环采样,就能续写出完整的诗。
# 1.4.1 数据预处理
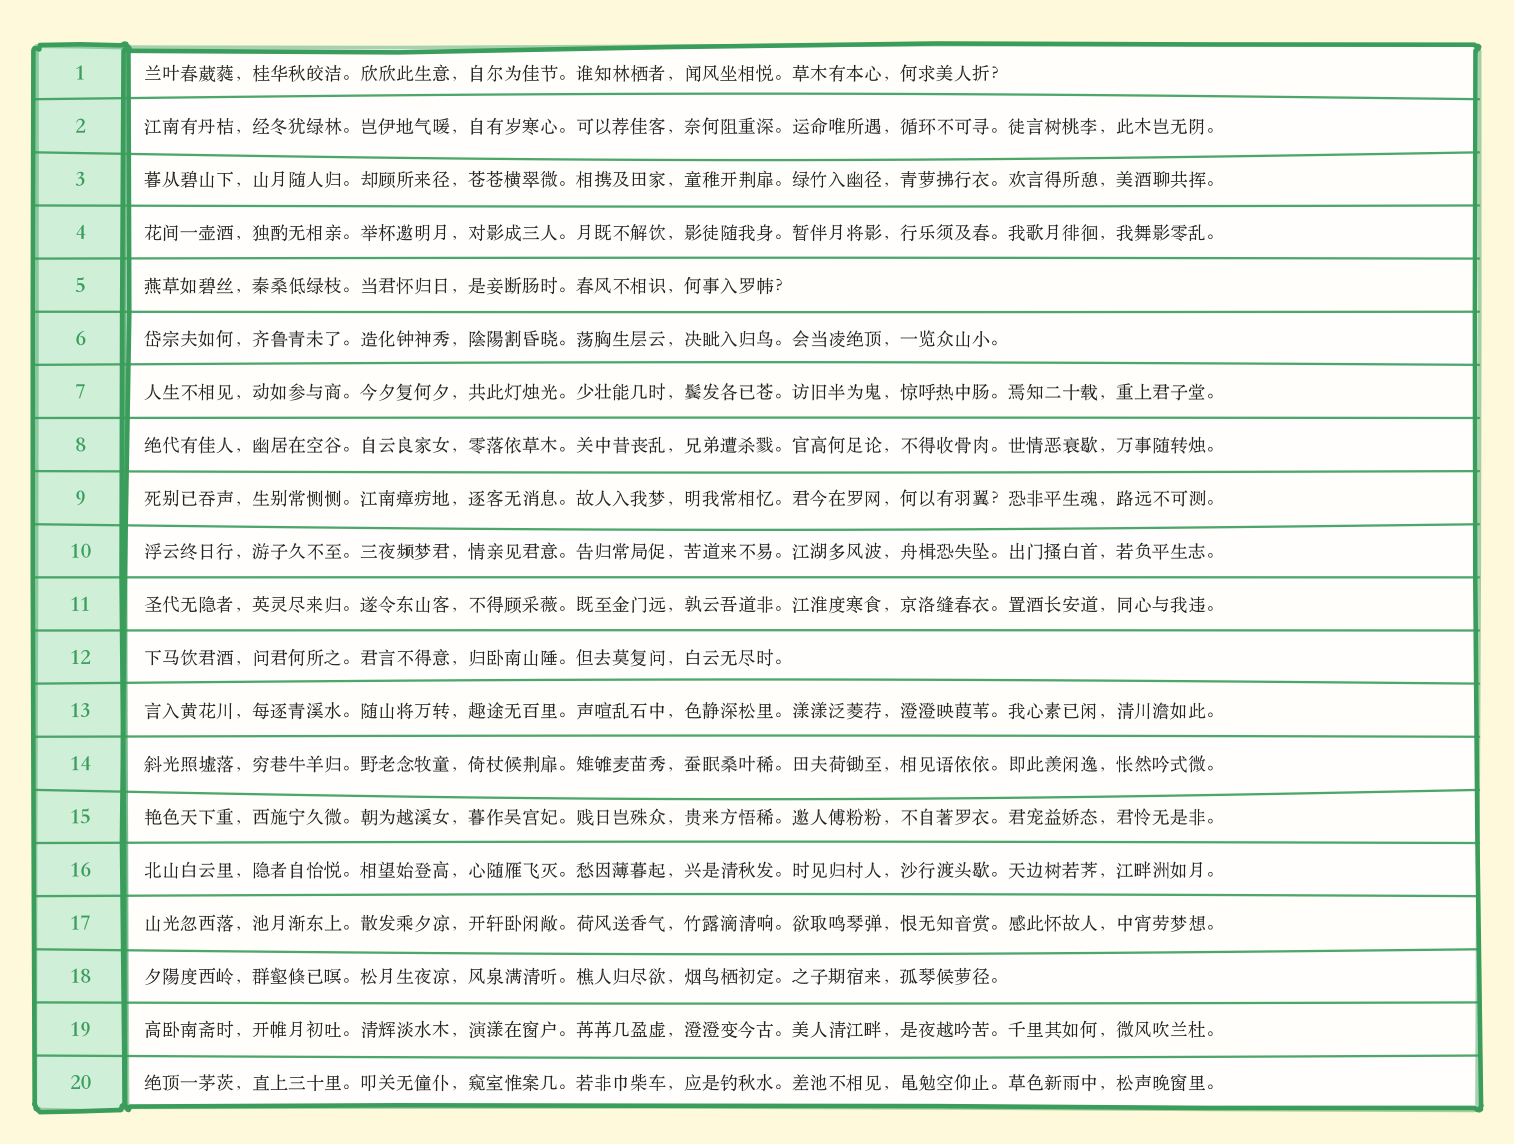
数据在txt文件中,每行为一首诗。首先将每个字作为一个词构建词表,并将原文转换为索引序列:
import re
import torch
from torch import nn, optim
from torch.utils.data import Dataset, DataLoader

# 数据预处理
def process_poems(file_path):
    poems = []       # 保存处理后的诗(字的列表)
    char_set = set() # 保存所有不重复的字
    with open(file_path, "r", encoding="utf-8") as f:
        for line in f:
            line = re.sub(r"[,。、?!:\n]", "", line).strip()  # 去掉标点与空白
            char_set.update(list(line))
            poems.append(list(line))

    # 构建词表, <UNK>兜底未登录字
    vocab = list(char_set) + ["<UNK>"]
    word2idx = {word: idx for idx, word in enumerate(vocab)}

    # 将诗转换为索引序列
    sequences = []
    for poem in poems:
        sequences.append([word2idx.get(word, word2idx["<UNK>"]) for word in poem])
    return sequences, word2idx, vocab

sequences, word2idx, vocab = process_poems("data/poems.txt")
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
# 1.4.2 自定义Dataset
构建训练样本:输入是一个定长序列,目标是它整体右移一位——模型学的就是"看到前n个字,猜后面n个字"。
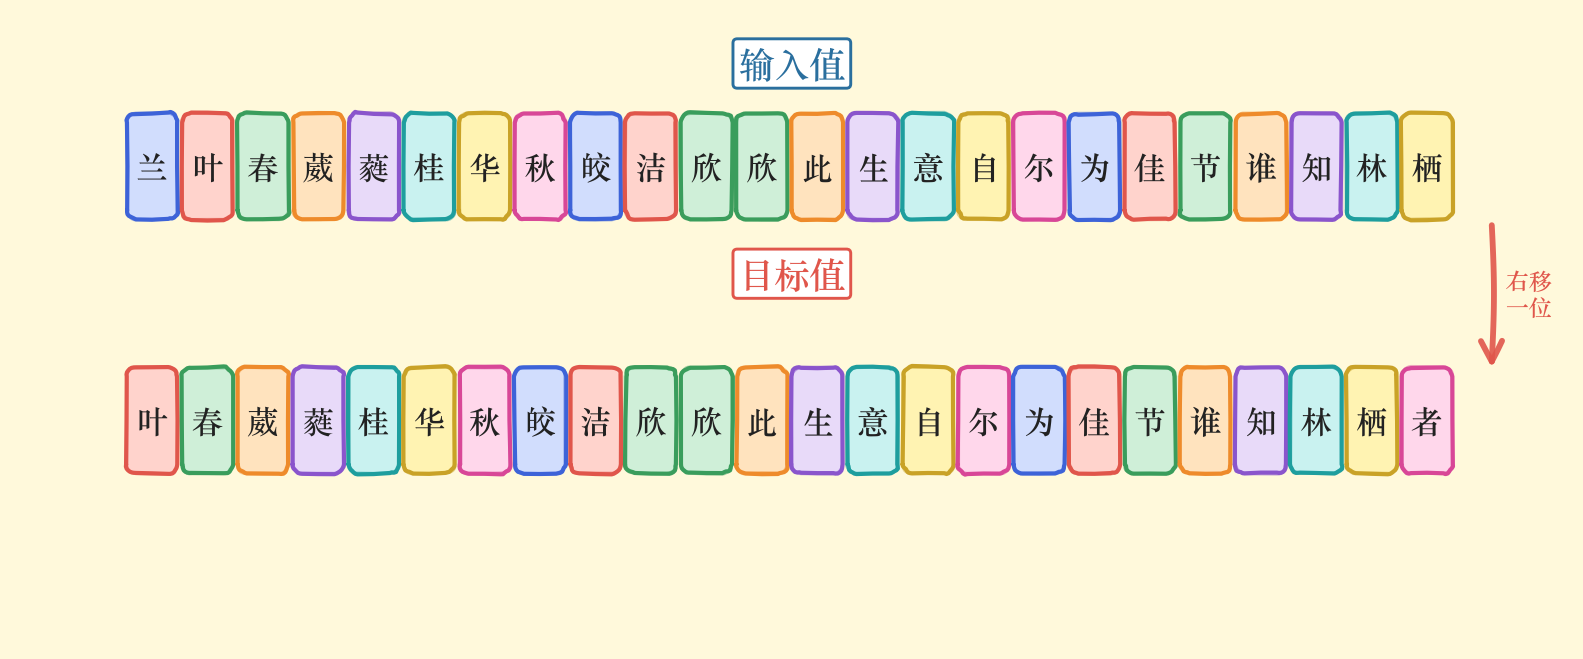
# 自定义Dataset
class PoetryDataset(Dataset):
    def __init__(self, sequences, seq_len):
        self.seq_len = seq_len
        self.data = []
        for seq in sequences:
            for i in range(0, len(seq) - self.seq_len):
                self.data.append((seq[i : i + self.seq_len],
                                  seq[i + 1 : i + 1 + self.seq_len]))

    def __len__(self):
        return len(self.data)

    def __getitem__(self, idx):
        # DataLoader会把多个样本堆叠成(batch, seq_len)
        x = torch.LongTensor(self.data[idx][0])
        y = torch.LongTensor(self.data[idx][1])
        return x, y

dataset = PoetryDataset(sequences, seq_len=24)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
# 1.4.3 搭建模型
结构三步走:词嵌入层→RNN→全连接层。两处关键点都在batch_first上:RNN显式设置batch_first=True与DataLoader对齐;全连接层作用在最后一维上,逐时刻、逐样本地把隐状态映射成词表大小的logits。
# 搭建模型
class PoetryRNN(nn.Module):
    def __init__(self, vocab_size, embedding_dim=128, hidden_size=256, num_layers=1):
        super().__init__()
        self.embed = nn.Embedding(num_embeddings=vocab_size, embedding_dim=embedding_dim)
        # 必须写batch_first=True, 输入才是(batch, seq_len, embedding_dim)
        self.rnn = nn.RNN(input_size=embedding_dim, hidden_size=hidden_size,
                          num_layers=num_layers, batch_first=True)
        self.linear = nn.Linear(in_features=hidden_size, out_features=vocab_size)

    def forward(self, x, hx=None):
        x = self.embed(x)              # (batch, seq_len) -> (batch, seq_len, emb)
        output, hidden = self.rnn(x, hx)
        output = self.linear(output)  # (batch, seq_len, vocab_size)
        return output, hidden

device = torch.device("cuda" if torch.cuda.is_available()
                      else "mps" if torch.backends.mps.is_available() else "cpu")
model = PoetryRNN(len(vocab), embedding_dim=128, hidden_size=256, num_layers=2).to(device)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
# 1.4.4 模型训练
交叉熵 + Adam。两个工程细节:①DataLoader在epoch外构建一次即可;②RNN训练容易梯度爆炸,反向传播后、step前用clip_grad_norm_做梯度裁剪——这是训练RNN的标准动作。
# 模型训练
def train(model, dataset, lr, epoch_num, batch_size, device):
    model.train()
    dataloader = DataLoader(dataset, batch_size=batch_size, shuffle=True)
    loss_fn = nn.CrossEntropyLoss()
    optimizer = optim.Adam(model.parameters(), lr=lr)
    for epoch in range(epoch_num):
        loss_accumulate = 0
        for batch_count, (x, y) in enumerate(dataloader):
            x, y = x.to(device), y.to(device)
            output, _ = model(x)
            # CrossEntropyLoss要求类别维在第1维: (batch, vocab, seq_len)
            loss_value = loss_fn(output.transpose(1, 2), y)
            optimizer.zero_grad()
            loss_value.backward()
            # 梯度裁剪: 所有梯度的总范数超过5就等比缩小, 防RNN梯度爆炸
            nn.utils.clip_grad_norm_(model.parameters(), max_norm=5.0)
            optimizer.step()
            loss_accumulate += loss_value.item()
            print(f"\repoch:{epoch:0>2}[{'='*(int((batch_count+1)/len(dataloader)*50)):<50}]", end="")
        print(f" loss:{loss_accumulate/len(dataloader):.6f}")

train(model=model, dataset=dataset, lr=1e-3, epoch_num=20, batch_size=32, device=device)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
# 1.4.5 生成:给一个起始字,还你一首诗
输入一个起始字让模型开始生成:每一步从输出的概率分布中随机采样下一个字(multinomial按概率抽样,而不是每次都取概率最大的字,否则一首诗会反复重复同一句),再把采样结果作为下一步的输入,隐状态则一路传递。按五言/七言的格式插入标点拼装成诗。
# 生成
def generate_poem(model, word2idx, vocab, start_token, line_num=4, line_length=7):
    model.eval()
    poem = []
    current_line_length = line_length
    start_idx = word2idx.get(start_token, word2idx["<UNK>"])
    if start_idx != word2idx["<UNK>"]:
        poem.append(start_token)
        current_line_length -= 1
    input = torch.LongTensor([[start_idx]]).to(device)  # (batch=1, seq_len=1)
    hidden = None
    with torch.no_grad():
        for _ in range(line_num):                  # 共4行
            for interpunction in [",", "。\n"]:   # 每行两句
                while current_line_length > 0:
                    output, hidden = model(input, hidden)
                    prob = torch.softmax(output[0, 0], dim=-1)  # 取唯一样本唯一时刻
                    next_token = torch.multinomial(prob, 1)     # 按概率随机采样
                    poem.append(vocab[next_token.item()])
                    input = next_token.unsqueeze(0)             # (1,1), 作为下一步输入
                    current_line_length -= 1
                current_line_length = line_length
                poem.append(interpunction)
    return "".join(poem)

print(generate_poem(model, word2idx, vocab, start_token="春", line_num=4, line_length=5))
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
手头还没有古诗语料文件也没关系,可以先用20首大家熟悉的五言绝句(如"床前明月光……""春眠不觉晓……")直接替换process_poems的输入做冒烟测试。注意五绝去掉标点后每首只有20个字,要把PoetryDataset的seq_len相应调小(如10),否则切不出训练窗口。以下是在这份20首小诗的语料上、torch.manual_seed(42)训练200个epoch、生成时manual_seed(7)的一次真实输出(语料小,模型以背诵为主,但足以验证整条链路;loss从5.26降到0.04):
春眠不觉晓,处处闻啼鸟。
夜来风雨声,花落知多少。
高单于夜遁,逃欲将轻骑。
逐大雪满弓,刀八阵图江。
2
3
4
可以看到:四句、每句五字、两句一个逗号/句号的格式完全正确;前两行是语料中的原句(小语料上模型最容易学到的就是"照抄"),后两行开始把《塞下曲》《八阵图》等篇目里的字重新拼接,虽然语义不通,但"记住常用字、按格式续写"的链路已经打通。换成数万首的完整古诗语料后,模型会学到更通用的用字与押韵规律,生成的诗句将更多是"原创组合"。
# 小结
| 概念 | 关键内容 | 一句话记忆 |
|---|---|---|
| NLP三条路线 | 同义词词典 / 计数共现 / 推理预测 | 从人工规则到神经网络预测 |
| 词嵌入 | nn.Embedding(词表大小, 维度),本质是查找表 | 词索引→稠密向量,近义词距离近 |
| RNN | 隐状态就是记忆,整条序列共享权重 | |
| nn.RNN | input_size/hidden_size/num_layers/batch_first | 建议永远显式写batch_first=True |
| 隐状态形状 | 恒为(num_layers, batch, hidden) | 即使batch_first=True也不变 |
| 语言模型 | 看前n个字预测第n+1个字,目标序列右移一位 | 写诗、翻译、对话的共同范式 |
| 梯度裁剪 | clip_grad_norm_在backward后、step前 | RNN防梯度爆炸的标准动作 |
| 采样生成 | multinomial按概率抽字 | 比每次取最大值更有多样性 |
今天我们把词变成了向量,又让网络带上了记忆,最后真的让机器"写"出了诗。但朴素RNN的记忆是短暂的:序列稍长,梯度连乘就会让早期信息被遗忘——"床前"两个字传不到第50个字那里。下一篇NLP连载,我们就用门控机制给记忆装上开关(LSTM与GRU),再往前走,注意力与Transformer将彻底改写序列建模的范式,那也是大模型故事真正的开端。