
# 勤奋的凯尔森同学10000h刻意练习Day23:GAN、训练优化全攻略与架构演进收官 —— 生成对抗、优化器到DenseNet与ViT
所属专栏: 凯尔森的10000h刻意练习
Slogan: 一个36岁程序员, 研究生(学硕),前世界500强top20软件开发Java工程师,用10000小时深耕AI, 目标Top10 AI资深工程师, 全程日更记录。
猫的图片能认了,可网络能不能反过来——从噪声里"长"出一只猫?又有哪些优化器和架构能让它走得更远?
Day22把评估、可解释和视觉应用讲透了。今天收官深度学习图像主线,三块拼图一次拼齐:第一,GAN——让两个网络一个造假、一个鉴别,在博弈中学会从噪声生成图像;第二,训练优化全攻略——从vanilla SGD到AdamW的六种优化器全景,再到LR Finder、标签平滑、Mixup/CutMix和梯度裁剪等现代训练技巧;第三,架构演进——ResNet之后的DenseNet把特征复用到极致、EfficientNet三个维度一起缩放、ViT干脆丢掉卷积把图当句子。从感知机到ViT,卷积视觉的整条骨干完整收束。
# 1.1 对抗思想:造假者与鉴定师的军备竞赛
GAN由两个网络组成,二者目标完全对立:
- 生成器G(Generator):输入随机噪声(通常是标准正态向量),输出一张假图。它的目标是让假图骗过判别器;
- 判别器D(Discriminator):输入一张图(真图或G的假图),输出"这是真图"的概率。它的目标是把真图判1、假图判0。
训练是一场零和博弈:D每次升级,G就面临更强的"考试",被迫画出更逼真的假图;G每次进步,D又被迫变得更敏锐。理想均衡下,G产出的假图与真图分布完全一致,D只能靠抛硬币(输出0.5)。Goodfellow把它类比为造假钞的罪犯和验钞的警察:警察越厉害,活下来的假钞越逼真。
数学上是一个极小极大(minimax)游戏:
- D要最大化两项:真图得分高、假图得分低(即小,大);
- G要最小化第二项:让假图得分高()。实践中G实际优化,梯度更强(早期假图太假时项梯度极小)。
# 1.2 DCGAN:用卷积搭出造假者与鉴定师
2015年的DCGAN把GAN与CNN结合,确立了沿用至今的架构纪律:G用转置卷积(Day22自编码器里用过)上采样,D用跨步卷积下采样;两者都用BatchNorm;G用ReLU、末端Tanh/Sigmoid,D用LeakyReLU。今天的实现针对28×28灰度图:
import torch, torch.nn as nn
import numpy as np

NZ = 100   # 噪声向量维度

class Generator(nn.Module):
    def __init__(self):
        super().__init__()
        self.fc = nn.Linear(NZ, 128 * 7 * 7)        # 噪声 -> 128张7x7特征图
        self.net = nn.Sequential(
            nn.ConvTranspose2d(128, 64, 4, stride=2, padding=1),  # 7 -> 14
            nn.BatchNorm2d(64), nn.ReLU(),
            nn.ConvTranspose2d(64, 1, 4, stride=2, padding=1),   # 14 -> 28
            nn.Sigmoid())                                # 像素值压到[0,1]
    def forward(self, z):
        h = torch.relu(self.fc(z)).view(-1, 128, 7, 7)
        return self.net(h)

class Discriminator(nn.Module):
    def __init__(self):
        super().__init__()
        self.net = nn.Sequential(
            nn.Conv2d(1, 64, 4, stride=2, padding=1), nn.LeakyReLU(0.2),  # 28->14
            nn.Conv2d(64, 128, 4, stride=2, padding=1),
            nn.BatchNorm2d(128), nn.LeakyReLU(0.2),                        # 14->7
            nn.Flatten(), nn.Linear(128 * 7 * 7, 1))      # 不加Sigmoid, 用BCEWithLogitsLoss
    def forward(self, x):
        return self.net(x).view(-1)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
判别器是个二分类器,但末端不加Sigmoid,配合BCEWithLogitsLoss数值更稳;LeakyReLU(负半轴保留0.2斜率)是GAN的经验标配,避免稀疏梯度让G学不动。
# 1.3 训练循环:一场交替升级的博弈
GAN训练的关键纪律是每步先训D再训G,两者各用各的目标:
G, D = Generator().to(device), Discriminator().to(device)
optG = torch.optim.Adam(G.parameters(), lr=2e-4, betas=(0.5, 0.999))
optD = torch.optim.Adam(D.parameters(), lr=2e-4, betas=(0.5, 0.999))
bce = nn.BCEWithLogitsLoss()

for x, _ in loader:                       # x: 一个batch真图
    bs = len(x); x = x.to(device)
    ones = torch.ones(bs, device=device)
    zeros = torch.zeros(bs, device=device)

    # --- 判别器: 真图判1, 假图判0 ---
    z = torch.randn(bs, NZ, device=device)
    fake = G(z).detach()                  # detach: 只训D, 不让梯度流进G
    optD.zero_grad()
    lossD = bce(D(x), ones) + bce(D(fake), zeros)
    lossD.backward(); optD.step()

    # --- 生成器: 让D把新造的假图判成1 ---
    z = torch.randn(bs, NZ, device=device)
    optG.zero_grad()
    lossG = bce(D(G(z)), ones)            # 标签是1: 越像真的越好
    lossG.backward(); optG.step()
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
三个工程细节:Adam的取0.5而非默认0.9(DCGAN论文发现默认值会让训练震荡);D的损失是"真图项+假图项"之和;训练D时用detach()切断到G的梯度,否则白白给G算一遍反向。
# 1.4 真实训练:看着噪声长成衣服
在60000张FashionMNIST上训练20个epoch(Apple M4 MPS,每epoch约18秒),固定同一组64维噪声向量,在第1、5、10、20个epoch后各采样一次:
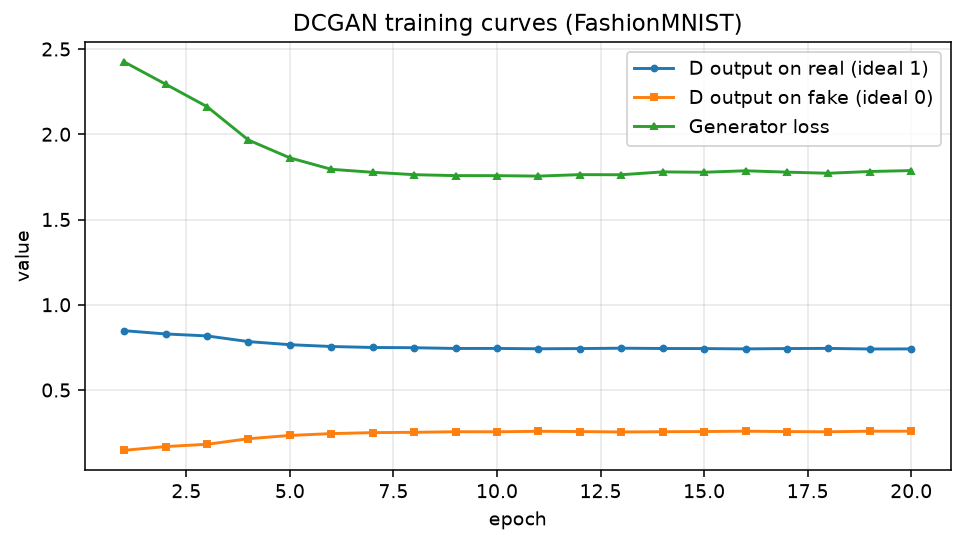
ep00 D(真图)=0.848 D(假图)=0.146 G损失=2.424
ep05 D(真图)=0.755 D(假图)=0.244 G损失=1.794
ep10 D(真图)=0.742 D(假图)=0.258 G损失=1.755
ep19 D(真图)=0.741 D(假图)=0.258 G损失=1.787
2
3
4
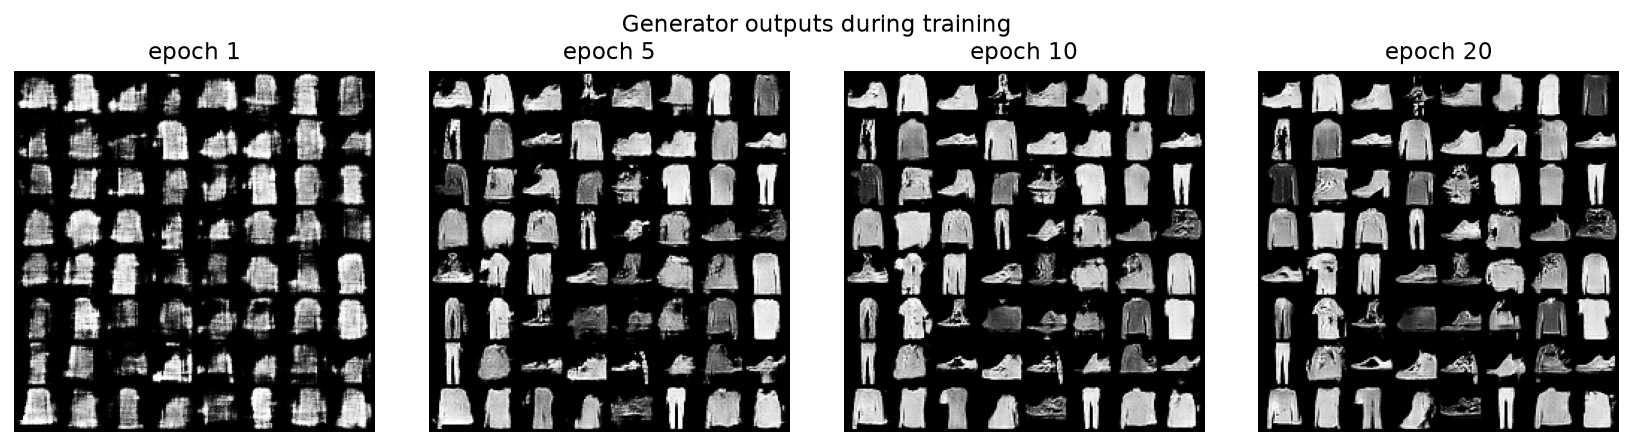
第1个epoch的输出只是灰雾中的色块;到第5个epoch已经出现鞋形轮廓;第20个epoch的64个样本里,大部分已经是轮廓合理、有明暗质感的衣裤鞋包——注意,这些图在训练集里一张都不存在,它们是G从随机噪声中"创造"的。
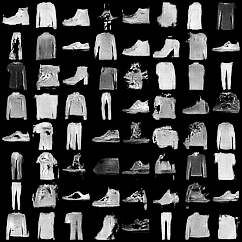
判别器输出的读数是GAN的体检仪:开局D轻松碾压(D对真图0.85、假图0.15);随着G进步,D对假图的给分从0.15爬升到0.26,之后三条曲线全部进入平台期。这里要诚实指出一个GAN的常见现实:理论均衡点是D输出0.5,而我们的小网络训20个epoch后停在0.26——D仍然略占上风,并没有达到"完全分不清"。但看采样图,视觉质量已经很好;这种"指标没到理论值、图却已经能用"的现象在GAN实践中非常普遍,也再次说明下一节的判读原则。最终64张随机生成图:
# 1.5 GAN为什么出名地难训
监督学习的损失会单调下降,GAN的损失不会——它是博弈,不是优化同一个函数。两个经典失败模式:
- D太强:若D判别力碾压G,G收到的梯度几乎为零(假图全被 confidently 判0),G停止学习。对策:控制D/G训练步数比例、用LeakyReLU、标签平滑(真标签用0.9而非1.0);
- 模式崩溃(mode collapse):G发现某一种图总能骗过D,就反复生成几乎相同的样本(比如只会画一种鞋)。对策:小batch、BN、minibatch discrimination、换用WGAN等改进损失。
判断GAN训得好不好,不要盯着G的loss数值(它没有"越低越好"的意义),要看固定噪声的采样图和D输出是否稳定在0.5附近。本次实验属于"D略强但G已可用"的健康态,且没有出现模式崩溃——最终64张样本里运动鞋、短靴、长裤、毛衣、T恤、外套都有,同一批噪声长出了多种类别。GAN的工程经验比任何单一架构都重要,这也是后来StyleGAN、扩散模型不断改进训练稳定性的原因。
# 1.6 风格迁移:把内容与风格拆开优化
同一年代另一条生成路线是2015年Gatys的神经风格迁移(Neural Style Transfer),它不训练新网络,而是直接优化一张图像本身。核心洞察来自预训练VGG(Day21见过)的分层特征:深层特征捕捉"画的是什么"(内容),浅层特征的纹理统计(Gram矩阵)捕捉"用什么笔触画的"(风格)。
做法:初始化一张噪声图,冻结VGG,定义两个损失对(不是对网络权重!)做梯度下降:
其中Gram矩阵是特征图展平后自己乘自己(),统计"哪些纹理模式总是同时出现",它不关心空间位置——所以风格能从星夜的旋涡迁移到你的照片上而内容不乱。核心代码不到30行:
# 伪代码骨架: 优化对象是图像pixels而非模型参数
x = torch.randn(1, 3, 256, 256, device=device, requires_grad=True)
optimizer = torch.optim.LBFGS([x])
for step in range(300):
    def closure():
        optimizer.zero_grad()
        fx, fc = vgg_deep(x), vgg_deep(content_img)
        loss_content = ((fx - fc.detach())**2).mean()
        loss_style = 0
        for l in range(5):
            gx = gram(vgg_features[l](x)); gs = gram(vgg_features[l](style_img).detach())
            loss_style += ((gx - gs)**2).mean()
        loss = 1.0 * loss_content + 1e6 * loss_style
        loss.backward(); return loss
    optimizer.step(closure)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
这是"把预训练网络当固定的特征提取器、反向优化输入"的独特范式,后来的DeepDream、对抗样本攻击、文本到图像生成,用的都是同一思想的变体。
# 1.7 生成模型谱系与明天预告
到今天为止,生成模型的四代路线全部亮相:
| 模型 | 思想 | 我们的实践 |
|---|---|---|
| 自编码器AE | 压缩再重建 | Day22:去噪MSE降到污染的1/7 |
| VAE(变分自编码器) | 让瓶颈向量服从正态分布,重参数化采样出新图 | 概念了解 |
| GAN | 生成器与判别器对抗博弈 | 今天:20epoch从噪声长出服装 |
| 扩散模型 | 学"逐步去噪",从纯噪声迭代出图像 | Day22手工去噪器的极致版(Stable Diffusion) |
到这里,生成模型的四代路线已全部亮相,但深度学习主线还剩两块没补:一是GAN里悄悄用了Adam却没解释它怎么来的、lr该取多少没有系统的找法;二是ResNet之后DenseNet和ViT是怎么演化的。明天Day23先把训练优化这块一次讲透——从SGD到AdamW的三次思想跃迁,再到LR Finder、标签平滑、Mixup、梯度裁剪这套"调参五件套",每一段都配真实实验。
# 1.8 起点:vanilla SGD的痛点
Day18已经写过最朴素的随机梯度下降(SGD):
是当前batch算出的梯度,是学习率。它简单到只有一行,但两个痛点在真实训练里非常刺手:
- 梯度噪声大:一个batch(比如256张图)估计的梯度方向和全数据集的真实方向有偏差,参数在最优点附近来回弹跳,loss曲线像心电图(Day22固定lr那条就是典型);
- 一个lr管所有参数:某些特征出现稀疏(比如NLP里低频词),这些参数的梯度时有时无,用一个全局lr意味着要么高频参数学太快、要么低频参数学不动。
后续所有改进都在解决这两件事:第一件靠加"惯性",第二件靠给每个参数"按自己的节奏"调学习率。
本节定位: §1.9–§1.12是优化器脉络的精简回顾(SGD/Momentum/AdaGrad/RMSProp/Adam的完整公式推导见Day18 §1.2,峡谷地形上的五条轨迹对比见Day20 §1.4.2);Day18/20没展开的GAN里Adam的betas(§1.12)与AdamW(§1.13)是本节的新内容,§1.14用真实CNN做六器横评。
# 1.9 Momentum:给参数加惯性
物理直觉是把优化过程想象成一个小球沿loss曲面向谷底滚:vanilla SGD是"每一步只看当前坡度,方向随时突变";加动量后小球有了惯性,即使当前坡度有起伏,之前的速度还能带着它穿过去:
常取0.9,含义是"当前速度=10%当下梯度+90%历史速度"。它本质是对最近10步梯度做指数加权平均,起到三个作用:加速在一致方向上的前进、抑制震荡方向上的弹跳、在低曲率长谷里获得冲量。
Day21训CIFAR-10、Day22调学习率调度,用的都是SGD(momentum=0.9),但当时一笔带过没讲原理。补上这一句:momentum是PyTorch里SGD的一个参数,不是另一个优化器类——torch.optim.SGD(lr=, momentum=0.9)就启用了它,如果再加nesterov=True则是Nesterov动量(先按惯性走一步再算梯度,曲率前瞻)。
# 1.10 AdaGrad:第一次自适应学习率
2011年的AdaGrad针对第二痛点:用历史梯度平方和做分母,给每个参数按自己的节奏调学习率(完整公式与NumPy实现见Day18 §1.2.4)。出现频繁的特征累积快、分母大、学习率自动变小;稀疏特征小、学习率保持大——第一次让每个参数有了自己的节奏,对稀疏数据(早期NLP词向量)效果显著。
致命缺陷:只增不减,学习率随时间单调递减,训练后期所有参数学习率趋近0,网络"冻死"在到达最优点之前。这个缺陷催生了RMSProp。
# 1.11 RMSProp:用滑动平均避免冻死
Hinton在2012年提出的RMSProp,把AdaGrad的"累积平方和"换成"指数移动平均(EMA)"(公式见Day18 §1.2.5):分母只记最近约100步的梯度尺度(常取0.99),更早的忘掉。这样既保留自适应学习率,又不会无限累积——把AdaGrad"单调衰减冻死"的病治好了,是深度学习早期主力自适应优化器。
# 1.12 Adam:Momentum + RMSProp的合体
2015年的Adam把前两条线合一:管动量(来自Momentum),管自适应学习率(来自RMSProp)。
两个细节:
- 偏差修正(帽子项)的作用:初期,前几步的EMA严重偏小,会让前几个batch的步长异常小。修正项在很小时也接近0,把、放大回正常量级——这是Adam能快速起步的关键。
- 的默认值来自论文:管动量(近10步平均),管尺度(近1000步平均,因为梯度平方更平稳,平均窗口可以更长)。
这就是Day23 GAN代码里Adam(lr=2e-4, betas=(0.5,0.999))那行里两个数:0.999是沿用默认,0.5是把从0.9降到0.5——DCGAN论文发现动量太强会让GAN训练震荡,减弱一阶动量后训练更稳。
# 1.13 AdamW:把权重衰减从梯度里解耦
Adam默认的weight_decay实现有个长期被忽视的bug:L2正则本意是"把权重往0拉",但Adam把它和梯度混在一起进了自适应分母,导致权重衰减的力度被梯度尺度调制,效果和纯SGD上的L2不等价。
2017年的AdamW把这件事拆开:权重衰减不再加在梯度里,而是直接作用在参数更新步上:
是weight_decay系数。这个"解耦权重衰减"(decoupled weight decay)让正则强度与梯度自适应独立,在固定weight_decay下跨lr迁移性好、调参更省心——这也是它成为Transformer/LLM训练标配的原因(GPT、LLaMA、ViT几乎清一色AdamW)。
一句话记忆:Adam=动量+自适应+偏差修正;AdamW=Adam+解耦权重衰减。torch.optim.AdamW就是它的实现。
# 1.14 实验:同一个CNN,六种优化器各跑10个epoch
实验设置:在FashionMNIST上用同一个轻量CNN(Conv-BN-ReLU-Conv-BN-ReLU-Pool ×2 + AdaptiveAvgPool + Linear,约38万参数),固定种子42,每种优化器各训10个epoch,batch=256,Apple M4 MPS后端。为公平对比,学习率取各优化器的典型推荐值(SGD=0.1,Momentum=0.05,AdaGrad=0.01,RMSProp=0.001,Adam=0.001,AdamW=0.001+wd=1e-4),不额外加学习率调度。
import torch, torch.nn as nn, torch.nn.functional as F
import numpy as np
from torchvision import datasets, transforms
from torch.utils.data import DataLoader

device = torch.device("mps")
tf = transforms.Compose([transforms.ToTensor()])
train_ds = datasets.FashionMNIST("data", train=True,  transform=tf)
test_ds  = datasets.FashionMNIST("data", train=False, transform=tf)
train_loader = DataLoader(train_ds, batch_size=256, shuffle=True)
test_loader  = DataLoader(test_ds,  batch_size=512)

class SmallCNN(nn.Module):
    def __init__(self):
        super().__init__()
        self.features = nn.Sequential(
            nn.Conv2d(1, 32, 3, padding=1), nn.BatchNorm2d(32), nn.ReLU(),
            nn.Conv2d(32, 32, 3, padding=1), nn.BatchNorm2d(32), nn.ReLU(),
            nn.MaxPool2d(2),                                   # 28->14
            nn.Conv2d(32, 64, 3, padding=1), nn.BatchNorm2d(64), nn.ReLU(),
            nn.MaxPool2d(2),                                   # 14->7
            nn.AdaptiveAvgPool2d(1),
        )
        self.fc = nn.Linear(64, 10)
    def forward(self, x):
        return self.fc(self.features(x).flatten(1))

def make_opt(name, params):
    if name == "SGD":      return torch.optim.SGD(params, lr=0.1)
    if name == "Momentum": return torch.optim.SGD(params, lr=0.05, momentum=0.9)
    if name == "AdaGrad":  return torch.optim.Adagrad(params, lr=0.01)
    if name == "RMSProp":  return torch.optim.RMSprop(params, lr=0.001, alpha=0.99)
    if name == "Adam":     return torch.optim.Adam(params, lr=0.001, betas=(0.9, 0.999))
    if name == "AdamW":    return torch.optim.AdamW(params, lr=0.001, betas=(0.9, 0.999),
                                                    weight_decay=1e-4)

@torch.no_grad()
def evaluate(model):
    model.eval()
    correct = sum((model(x.to(device)).argmax(1).cpu() == y).sum().item()
                  for x, y in test_loader)
    return correct / len(test_ds)

def train_one(name):
    torch.manual_seed(42)
    model = SmallCNN().to(device)
    opt = make_opt(name, model.parameters())
    accs = []
    for ep in range(10):
        model.train()
        for x, y in train_loader:
            x, y = x.to(device), y.to(device)
            loss = F.cross_entropy(model(x), y)
            opt.zero_grad(); loss.backward(); opt.step()
        accs.append(evaluate(model))
    return accs
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
真实结果(完整运行,每个优化器约83秒):
优化器        final_acc   best_acc   duration
SGD            0.7970     0.8294     84.6s
Momentum       0.8598     0.8633     83.3s
AdaGrad        0.8456     0.8546     83.5s
RMSProp        0.7559     0.7926     83.4s
Adam           0.7723     0.8367     83.1s
AdamW          0.8279     0.8601     83.3s
2
3
4
5
6
7
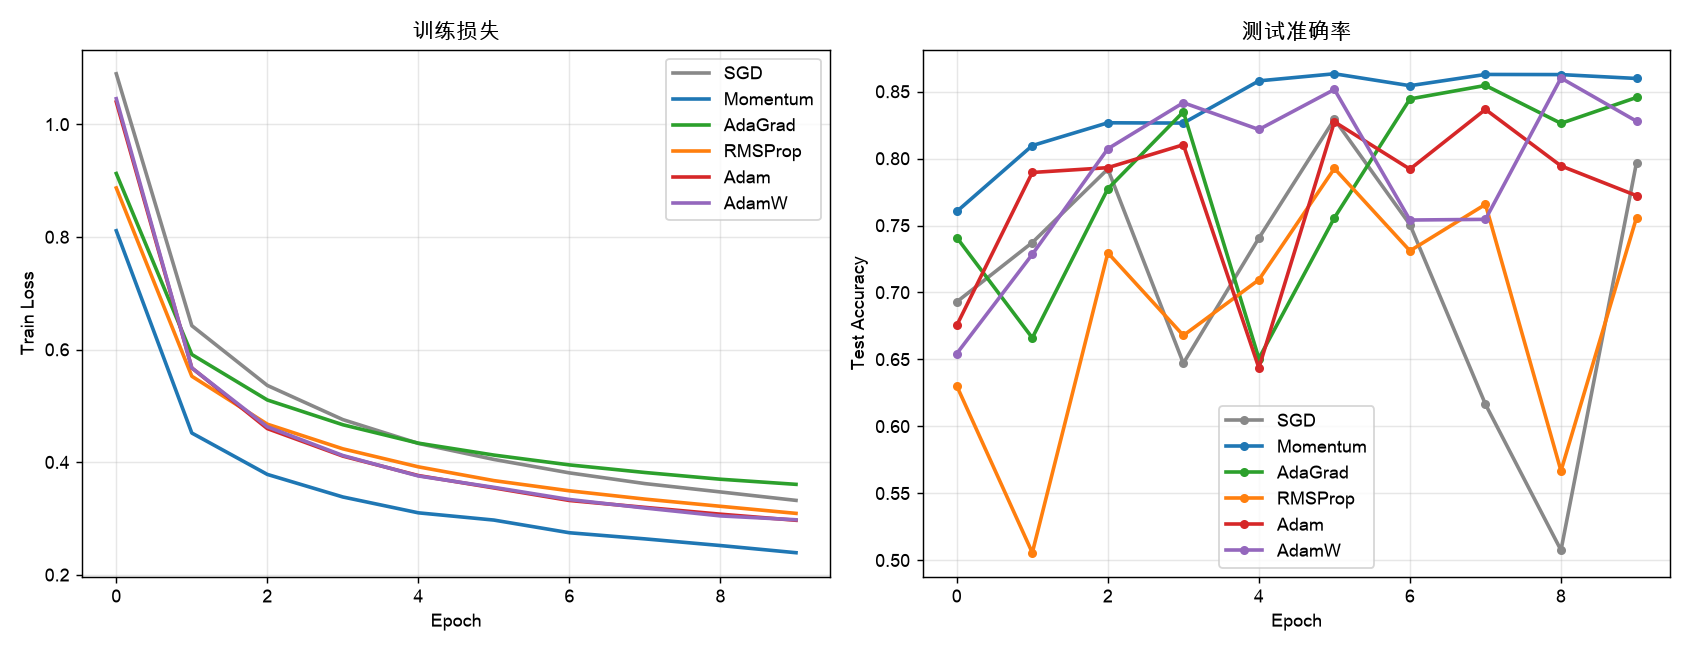
诚实读这张表:
Momentum最优,best_acc=0.8633。在10个epoch、38万参数的小规模实验里,调好lr的SGD+momentum收敛最快、最稳。这呼应了一条经典经验:Adam并非在所有任务、所有训练长度下都最优;小模型、短训练里,SGD+momentum+学习率调度(OneCycle/Cosine)往往更好。
测试准确率曲线明显震荡。Momentum和Adam在ep3~ep9的测试准确率会上下跳动几个点——这不是bug,而是BN运行统计量的滞后(batch=256的BN在评估时用的是训练态的滑动均值,小epoch下尚未稳态)加上小测试集评估的随机性共同造成的。训练损失曲线则平滑单调下降,说明训练本身在收敛,震荡只发生在评估侧。
RMSProp和Adam在这组lr下意外地不稳。两者final_acc都低于Momentum。原因是lr=0.001对自适应优化器在小模型+BN下偏小,起步慢,10个epoch不足以体现后期优势。这也提示:自适应优化器的默认lr是"安全值",未必是某任务的最优值——这也是为什么后面要讲LR Finder。
# 1.15 LR Finder:从1e-6扫到爆炸,找loss下降最快的地方
§1.14里给六种优化器各配了一个"经验默认lr",但默认值未必是当前任务的最优。Leslie Smith在2015年提出的**LR range test(LR Finder)**给了一个不靠玄学的找法:
- 把模型从随机初始化开始,让lr从一个极小值(如1e-6)随训练步线性或指数增长到很大(如10);
- 每步记录loss,画成"loss—lr"曲线;
- 曲线的形状几乎是固定的:小lr区loss高位横移(学不动)→中段loss陡降(开始学)→过大lr处loss爆炸(发散)。
- 推荐起始lr取曲线最低点对应的lr,或最低点左侧1/10处(Smith经验:最低点本身已接近发散,留出安全余量)。
30行代码就能跑:
import torch, torch.nn.functional as F
from torchvision import datasets, transforms
from torch.utils.data import DataLoader

def lr_finder(model, loader, device, lr_start=1e-6, lr_end=10, n_iter=300):
    opt = torch.optim.SGD(model.parameters(), lr=lr_start)
    factor = (lr_end / lr_start) ** (1.0 / n_iter)   # 每步指数增长
    lrs, losses = [], []
    it = 0
    for x, y in loader:
        x, y = x.to(device), y.to(device)
        loss = F.cross_entropy(model(x), y)
        opt.zero_grad(); loss.backward(); opt.step()
        lrs.append(opt.param_groups[0]["lr"])
        losses.append(loss.item())
        it += 1
        if it >= n_iter: break
        for pg in opt.param_groups:
            pg["lr"] *= factor
        if loss.item() > 4 * min(losses): break      # 发散就停
    return lrs, losses
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
在CIFAR-10的同一个轻量CNN上跑300步,真实曲线长这样:
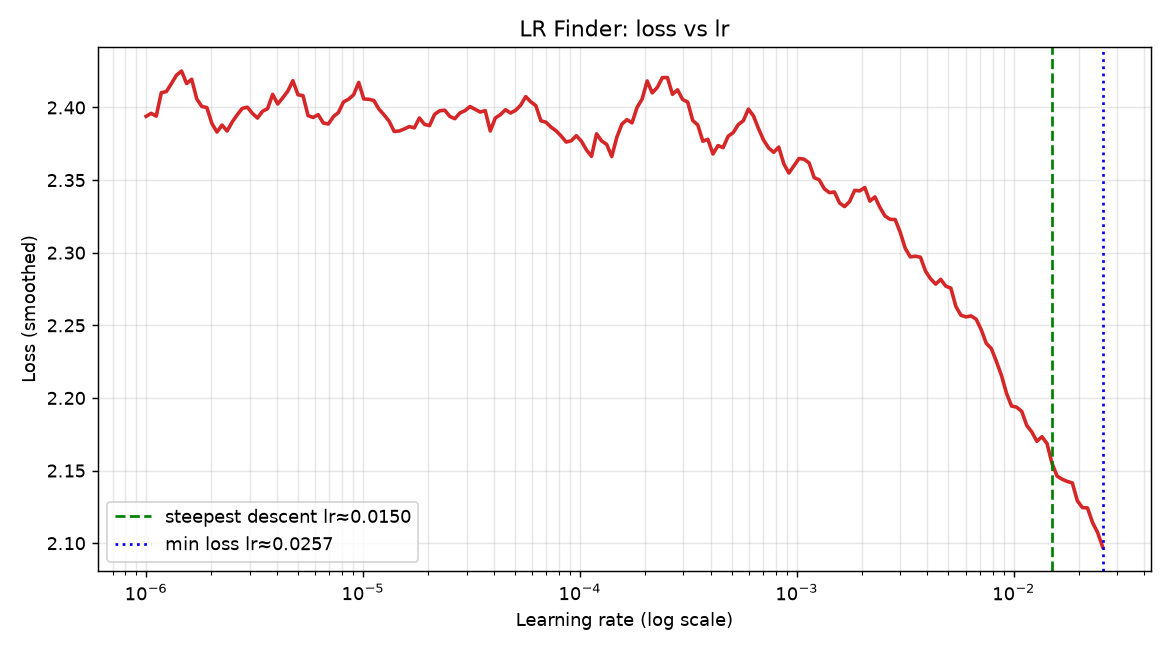
steepest descent lr≈0.01502 (loss=2.155)
min loss=2.097 at lr=0.02570
推荐起始lr≈0.00257 (min-loss的1/10)
2
3
读图三段:lr<0.001时loss在2.3附近横移(对应10类随机的交叉熵,网络几乎没学);0.001~0.025区间loss陡降到2.10;lr再增大loss开始发散。所以这条曲线给出两条信息:下界约0.001(再小没意义),上界约0.025(再大发散)。起始lr取中间或1/10处,0.002~0.01都是合理选择——§1.14给Momentum配的0.05略偏上,这也解释了为什么那条曲线有震荡。
LR Finder的工程价值:把调lr从"试5个值看哪个准"变成"跑一次画条线"。fastai的lr_find()、HuggingFace Trainer的plot_losses底层都是这个思路。
# 1.16 标签平滑:不让网络把话说死
普通交叉熵配one-hot标签,模型会被推向"对真类输出概率1.0"。但标签本身有噪声(标注错误),且1.0意味着"我对这条永远不犯错",这会让置信度过高、对错误样本的梯度也过大。**标签平滑(Label Smoothing)**的做法:
即把真类概率从1.0降到(其余类各分),常用。效果是给真类设了0.9的"天花板",网络不再被推向输出1.0,而是停在0.9附近——一个更诚实的置信度,既抗过拟合,也让模型在校准(置信度与准确率匹配)上表现更好。
PyTorch从1.10起cross_entropy直接支持:
loss = F.cross_entropy(out, y, label_smoothing=0.1) # 一行开启
# 1.17 Mixup:把两张图和它们的标签线性混合
2018年Mixup的思想极端简洁:训练时随机抽两张图,按一个从Beta分布采样的系数线性混合,标签也按同比例混合:
模型不再学"这张是猫",而是学"这张70%是猫30%是狗"。这等于在输入空间做了线性插值生成新样本,是一种强正则。它还能让决策边界更线性、更平滑,对对抗样本的鲁棒性也提升。代价是训练loss曲线不会降得那么漂亮(标签是软的),且通常需要更多epoch才收敛。
def mixup_data(x, y, alpha=0.2):
    lam = np.random.beta(alpha, alpha) if alpha > 0 else 1.0
    idx = torch.randperm(x.size(0), device=x.device)   # 随机配对
    return x, y, y[idx], lam

x, y_a, y_b, lam = mixup_data(x, y, 0.2)
out = model(x)
loss = lam * F.cross_entropy(out, y_a) + (1-lam) * F.cross_entropy(out, y_b)
2
3
4
5
6
7
8
# 1.18 CutMix:剪切一块贴过去,保留局部结构
Mixup把整张图按比例混合,会得到一张"两个半透明图叠在一起"的模糊图——局部结构被破坏。2019年的CutMix改为:从另一张图里剪一块矩形区域贴到当前图上,标签按剪切面积比例混合:
其中是二值掩码(剪的区域为1),按剪区域面积比设定。相比Mixup,CutMix保留了完整的局部纹理("这只猫的耳朵来自图a,身体来自图b"),模型学到的仍是真实的局部特征,而不是半透明叠加产生的伪纹理。在多数分类任务上CutMix略优于Mixup,且生成的"拼接图"对人类也更好理解。
两者在torchvision.transforms.v2里都有现成实现,也可手写。Mixup/CutMix对ViT尤其有效(Day23会介绍ViT,这类数据增强在长训练大模型上才稳定涨点)。
# 1.19 梯度裁剪:给优化步长设上限
RNN(尤其长序列)和GAN训练中,梯度偶尔会突然爆到几十几百,一步把参数推飞、loss变nan。**梯度裁剪(Gradient Clipping)**的做法是在backward()之后、step()之前,把所有参数梯度的总范数缩放到不超过阈值:
loss.backward()
torch.nn.utils.clip_grad_norm_(model.parameters(), max_norm=1.0)
opt.step()
2
3
它按整体范数裁剪(clip by norm),不是逐元素裁剪(clip by value)。原理:算所有梯度的拼接向量的范数,若超过max_norm,就按max_norm / ‖g‖等比缩放整个梯度向量——方向不变,只砍长度。这样既防爆,又保住了梯度的相对结构。
实测:在CIFAR-10小CNN上故意把lr开到0.5诱发大梯度,统计80个训练步:
clip前 梯度范数: mean=0.529 max=1.357 p95=0.900
clip后 梯度范数: mean=0.519 max=1.000 p95=0.900
被裁剪的step比例: 4.94%
2
3
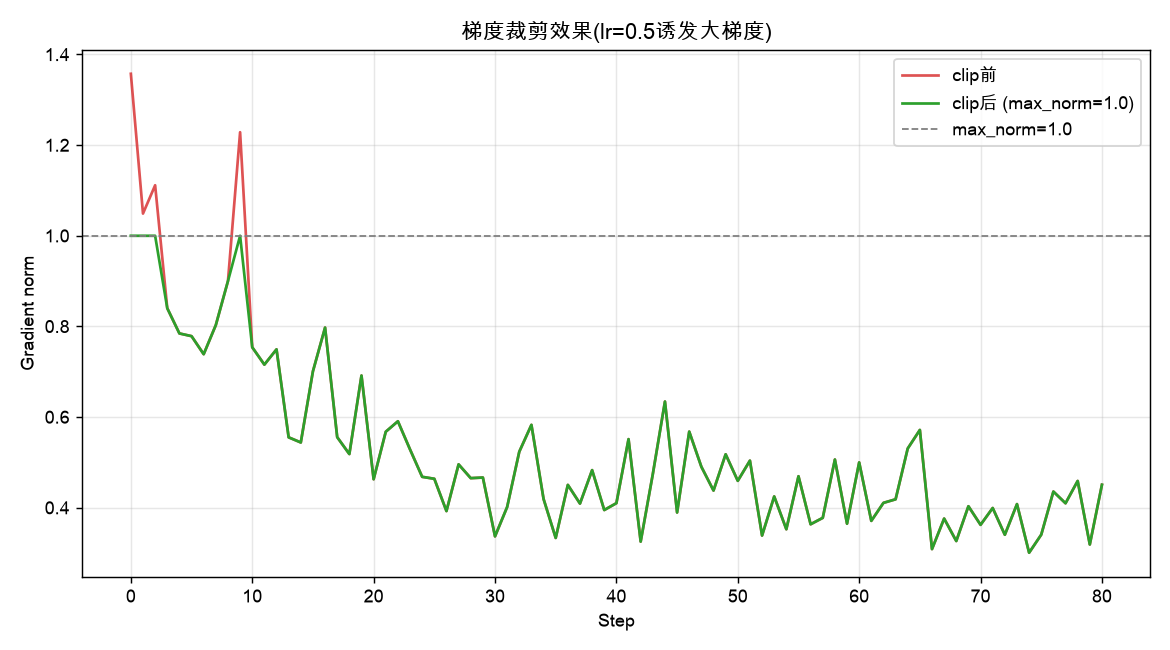
读数:正常步的梯度范数在0.5附近波动,max_norm=1.0只切到了约5%的"突刺"——这些正是会引发一次参数飞移的尖峰。clip前最大1.357,clip后封顶1.0,方向不变。这5%的裁剪就是梯度裁剪的全部价值:不挡正常步,只砍异常步。Transformer训练(GPT系列、LLaMA)几乎都带max_norm=1.0,RNN里更是标配。
# 1.20 实验:标签平滑与Mixup到底涨不涨点
在CIFAR-10上用同一个轻量CNN,固定种子42,SGD+momentum+Cosine退火,统一lr=0.05、8个epoch,对比四个配置:
import torch, torch.nn as nn, torch.nn.functional as F

class SmallCNN(nn.Module):
    def __init__(self):
        super().__init__()
        self.features = nn.Sequential(
            nn.Conv2d(3, 32, 3, padding=1), nn.BatchNorm2d(32), nn.ReLU(),
            nn.Conv2d(32, 32, 3, padding=1), nn.BatchNorm2d( 32), nn.ReLU(),
            nn.MaxPool2d(2),
            nn.Conv2d(32, 64, 3, padding=1), nn.BatchNorm2d(64), nn.ReLU(),
            nn.MaxPool2d(2), nn.AdaptiveAvgPool2d(1),
        )
        self.fc = nn.Linear(64, 10)
    def forward(self, x):
        return self.fc(self.features(x).flatten(1))

def train_config(use_ls=False, mixup_alpha=0.0, epochs=8):
    torch.manual_seed(42)
    model = SmallCNN().to(device)
    opt = torch.optim.SGD(model.parameters(), lr=0.05, momentum=0.9, weight_decay=5e-4)
    sched = torch.optim.lr_scheduler.CosineAnnealingLR(opt, T_max=epochs)
    for ep in range(epochs):
        model.train()
        for x, y in train_loader:
            x, y = x.to(device), y.to(device)
            if mixup_alpha > 0:
                lam = np.random.beta(mixup_alpha, mixup_alpha)
                idx = torch.randperm(x.size(0), device=x.device)
                out = model(x)
                loss = lam * F.cross_entropy(out, y, label_smoothing=0.1 if use_ls else 0) \
                     + (1-lam) * F.cross_entropy(out, y[idx], label_smoothing=0.1 if use_ls else 0)
            else:
                loss = F.cross_entropy(model(x), y, label_smoothing=0.1 if use_ls else 0)
            opt.zero_grad(); loss.backward(); opt.step()
        sched.step()
    return evaluate(model)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
真实结果(完整运行):
配置              final_acc   best_acc
baseline           0.6408     0.6408
+label_smooth      0.6480     0.6480    (+0.7pp)
+mixup             0.5357     0.5357    (-10.5pp)
+ls+mixup          0.5303     0.5303    (-11.1pp)
2
3
4
5
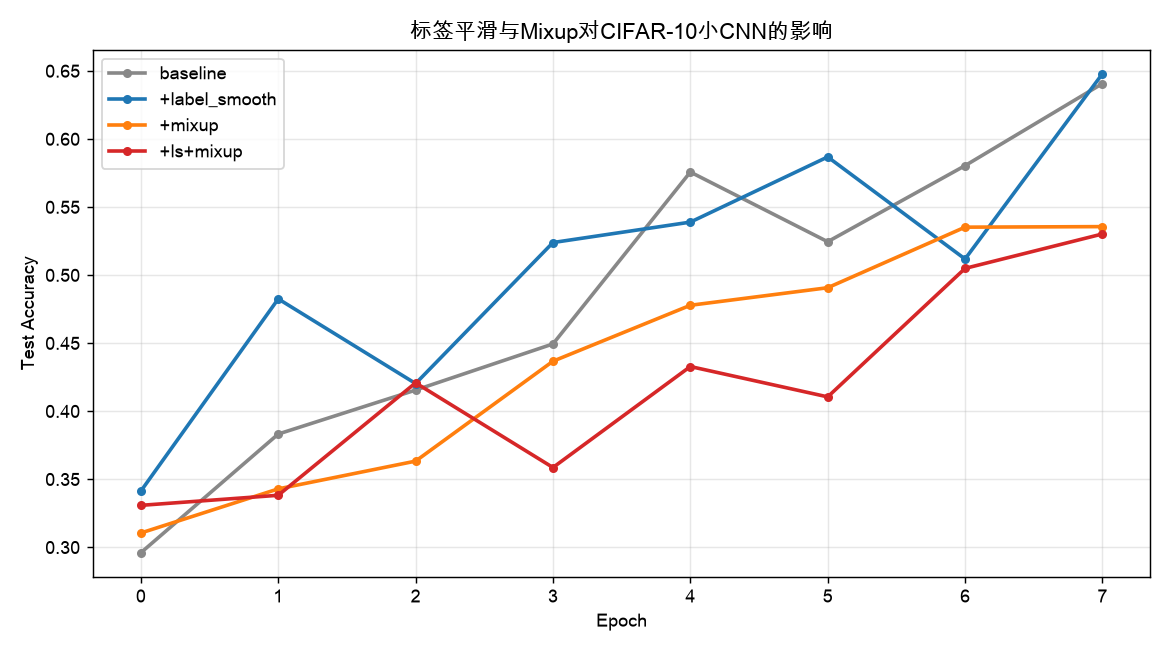
诚实读这组结果,它和"涨点技巧"的刻板印象是相悖的:
标签平滑微涨0.7个点。它只是把one-hot变成软标签,开销为零(一行参数),适合无脑加上。
Mixup在这组配置下反而掉了10个点。这不是bug,而是Mixup的已知特性:它是一种强正则,正则强度和训练长度要匹配。8个epoch对Mixup来说太短——软标签让模型每步学到的信息变少,需要更多epoch才能把"interpolated样本"的知识消化完。Mixup的收益要在长训练(50+ epoch)和大模型(ResNet50/ViT)上才稳定显现,原论文的涨点也是建立在长训练基础上。短训练+小模型用Mixup,等于给一个还没学会走路的网络套上负重。
正则技巧不是越多越好。
+ls+mixup比+mixup还差一点,正则叠加有边际递减。工程上的原则:先确认基线收敛到饱和,再加正则看是否突破瓶颈;在没收敛的基线上叠正则,只会让你以为"模型不行"。
这组实验的目的不是证明这些技巧没用(它们在大模型长训练里确实涨点),而是说明一个常被忽略的道理:"技巧"的收益高度依赖训练规模。§1.14的Momentum最优、§1.20的Mixup掉点,都在提醒同一件事——没有一招通吃,真实实验比论文表格诚实。
# 1.21 DenseNet:每层都和前面所有层连
ResNet的跳连是"隔层相加"——第层的输入是,输出加上之前某层的输出:。相加意味着两条路的信息"混在一起",且梯度反向流动时需要经过加法节点。
2017年DenseNet的改动更激进:让每个稠密块(Dense block)里的每一层都直接接收前面所有层的输出,在通道维上拼接而非相加。
其中是通道维拼接。若每层输出个特征图(称growth rate ),第层的输入通道数是,是进入块时的通道数。
直觉:之前每一层只看"上一层的输出",DenseNet让每一层都能直接访问最原始的特征——它假设信息不会随层数递减,反而要复用。三个直接好处:
- 参数更省:每层只产出个新特征图(典型),而不是整层重算。DenseNet121只有6.96M参数,比ResNet18(11.17M)少38%。
- 梯度流动更好:每层都和输入有直接连接,梯度能直通回早期层。
- 特征复用:同一特征被多层级使用,有研究表明DenseNet学到的特征冗余度低。
代价也很明显:拼接让通道数随层数线性增长,中间特征图的存储占用大、内存访问多——所以DenseNet比同精度的ResNet慢3倍多(后面实验会实证)。为控制通道增长,DenseBlock之间用**过渡层(Transition)**做1×1卷积压缩通道数。
torchvision.models.densenet121直接可用,DenseBlock内部的层用BN-ReLU-Conv(后激活)结构,这也是DenseNet论文的命名——DenseNet = Dense Convolutional Network。
# 1.22 EfficientNet:复合缩放,三个维度一起调
2019年EfficientNet问了一个工程问题:要把网络变大,是加宽(更多通道)、加深(更多层)、还是加分辨率(更大输入图)?
之前的做法是"只调一个":ResNet主要加深,WideResNet主要加宽。EfficientNet论文发现:单纯加深/加宽/加分辨率,精度提升到一定程度就饱和了;三者按特定比例同时放大,精度才持续上升。
论文用(compound coefficient)统一控制:
其中由网格搜索在基线网络EfficientNet-B0上确定(约),从0取到7对应B0~B7。约束条件来自FLOPs近似正比于——固定加1则计算量翻倍。
效果:EfficentNet-B7在ImageNet上top-1准确率84.4%,参数量仅66M,是当年精度/参数比的天花板。它的另一个贡献是基线网络用**神经架构搜索(NAS)**得到,MBConv(倒残差+深度可分离卷积)作为基本块——这也是后来MobileNet v3、ViT后 EfficientNetV2的基础。
一句话记忆:EfficientNet = NAS搜索的基线 + 复合缩放的三维协调。它不是新结构,而是"如何把已有结构放大到最优"的工程方法。
# 1.23 ViT:卷积都不要,把图当句子
2020年ViT(Vision Transformer)做了一次范式转换:彻底放弃卷积,把图像当成一串token序列喂给纯Transformer。
做法分三步:
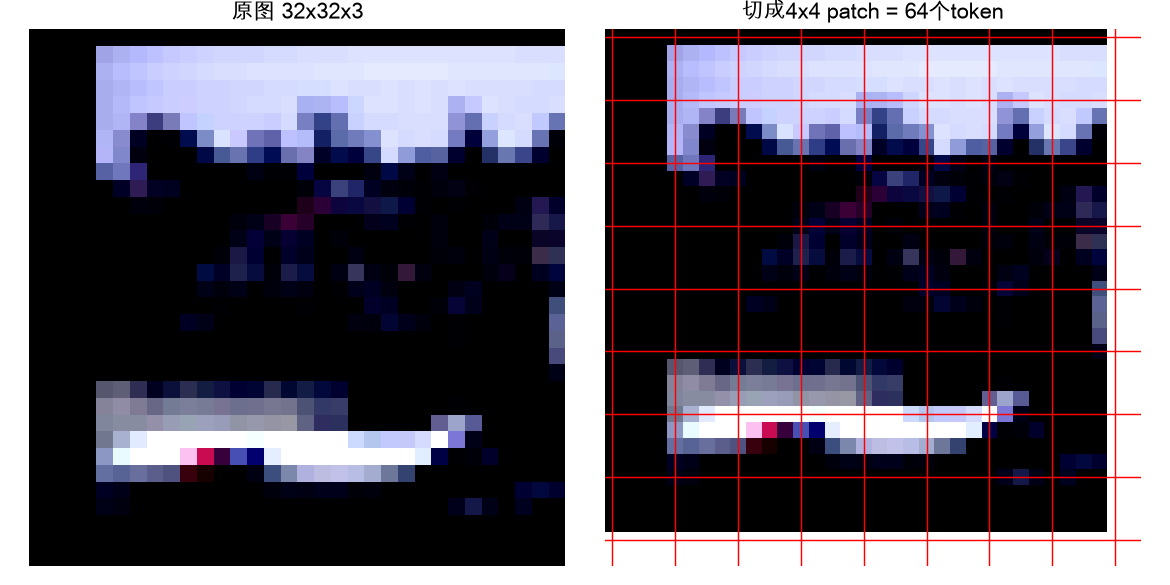
- Patch Embedding:把的图切成个不重叠的小块(patch),每个patch展平后用一个线性层(等价于一个stride=的卷积)映成一个维向量。一幅的图,取,就切成个token,每个token是维。
其中是第个patch的展平向量(维),是的投影矩阵。
加[CLS] token与位置编码:在序列最前面拼一个可学习的[CLS] token(它的最终输出做分类),再给每个token加上可学习的位置编码,告诉Transformer"这是第几号位置"。
标准Transformer编码器堆层:每层是多头自注意力(MSA)+MLP,带残差和LayerNorm。自注意力让每个patch能"看到"所有其他patch,等价于学到一个全局的、数据驱动的感受野。
patch embedding的核心代码很短:
import torch, torch.nn as nn

class PatchEmbed(nn.Module):
    def __init__(self, img_size=32, patch_size=4, in_ch=3, embed_dim=64):
        super().__init__()
        self.n = (img_size // patch_size) ** 2          # patch数
        self.proj = nn.Conv2d(in_ch, embed_dim, kernel_size=patch_size,
                             stride=patch_size)         # 等价线性投影
    def forward(self, x):
        x = self.proj(x)                                # (B, D, H/P, W/P)
        return x.flatten(2).transpose(1, 2)           # (B, N, D)
2
3
4
5
6
7
8
9
10
11
实测:一幅的CIFAR图,,:
输入: (2, 3, 32, 32) -> 输出tokens: (2, 64, 64) 即 (B, N_patches=64, D)
ViT的关键性质:
- 没有归纳偏置(inductive bias):CNN默认"局部性"和"平移不变"是先验,ViT不带这些先验,只靠自注意力学。这等于把约束放松了——数据多时是优势(能学到比卷积更灵活的关系),数据少时是劣势(没有先验约束容易过拟合)。原论文明确说:ViT在JFT-300M这种超大规模数据集上预训练后才超过ResNet,中等数据集上从头训反而不如CNN。这也是为什么后来DeiT、Swin Transformer都在改进"小数据下的ViT"。
- 计算量随token数平方增长:自注意力是,是patch数。224×224图取只有196个token还好;高分辨率图token数暴涨,催生了Swin Transformer的窗口注意力把复杂度降回线性。
ViT之后,视觉进入Transformer时代——Swin、DeiT、BEiT、MAE,以及后来的多模态大模型(CLIP、BLIP)都建立在ViT基础上。
# 1.24 实验:DenseNet121 vs ResNet18,CIFAR-10从头训8个epoch
Day21训过ResNet18(15 epoch到0.9024),今天在同一CIFAR-10、同一套增强与标准化下,让DenseNet121和ResNet18在完全相同的配置(SGD+momentum,lr=0.05,Cosine退火,batch=128,seed=42)下各从头训8个epoch,公平对比。DenseNet121的首层7×7步幅2和最大池化都按CIFAR改写,保留分辨率:
import torch, torch.nn as nn, torch.nn.functional as F
from torchvision import datasets, transforms
from torch.utils.data import DataLoader
from torchvision.models import densenet121, resnet18

def make_resnet18_cifar():
    m = resnet18(weights=None, num_classes=10)
    m.conv1 = nn.Conv2d(3, 64, 3, stride=1, padding=1, bias=False)
    m.maxpool = nn.Identity()
    return m

def make_densenet121_cifar():
    m = densenet121(weights=None, num_classes=10)
    m.features.conv0 = nn.Conv2d(3, 64, 3, stride=1, padding=1, bias=False)
    m.features.pool0 = nn.Identity()
    return m

def train_one(make_fn, epochs=8):
    torch.manual_seed(42)
    model = make_fn().to(device)
    opt = torch.optim.SGD(model.parameters(), lr=0.05, momentum=0.9, weight_decay=5e-4)
    sched = torch.optim.lr_scheduler.CosineAnnealingLR(opt, T_max=epochs)
    accs = []
    for ep in range(epochs):
        model.train()
        for x, y in train_loader:
            x, y = x.to(device), y.to(device)
            loss = F.cross_entropy(model(x), y)
            opt.zero_grad(); loss.backward(); opt.step()
        sched.step()
        accs.append(evaluate(model))
    return accs
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
真实结果(Apple M4 MPS,完整运行):
模型            params   final_acc   best_acc   duration
ResNet18       11.17M     0.8755     0.8755      610.2s
DenseNet121     6.96M     0.8938     0.8938     2021.8s
2
3
逐epoch准确率:
ResNet18:    0.5395  0.6461  0.6793  0.7530  0.7975  0.8338  0.8603  0.8755
DenseNet121: 0.5663  0.7141  0.7554  0.7956  0.8371  0.8533  0.8881  0.8938
2
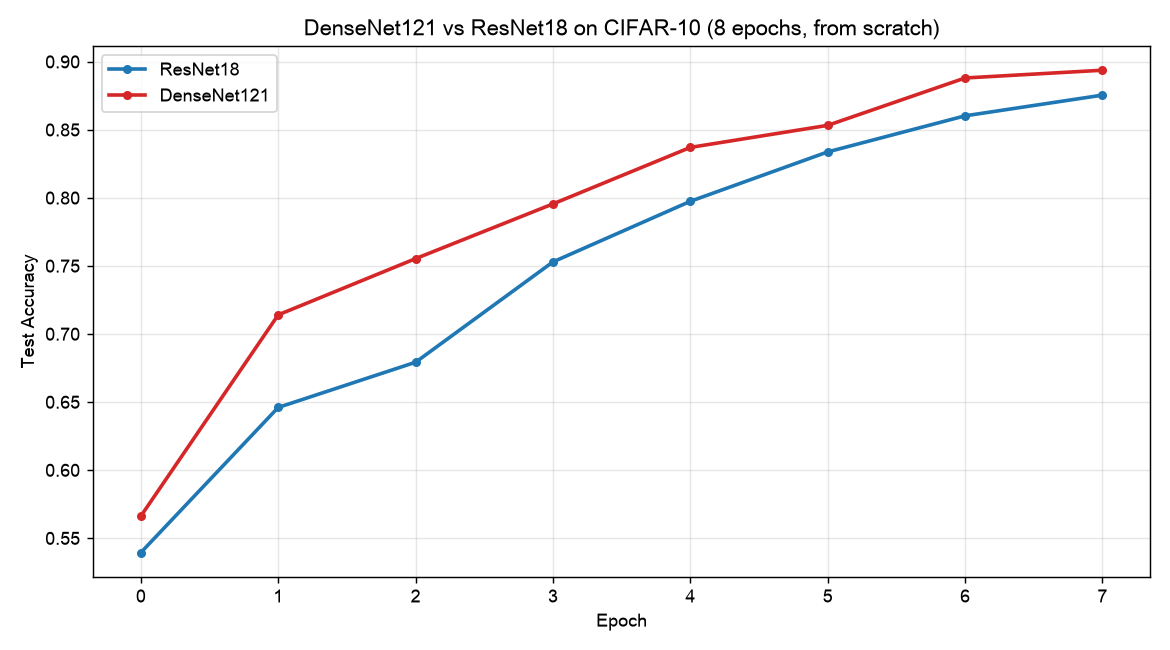
读这组数据:
DenseNet121用更少参数胜出:6.96M对11.17M(少38%),但8 epoch准确率0.8938对0.8755(高1.83pp)。这正是DenseNet论文的核心卖点——特征复用让同等精度所需参数更少。看逐epoch曲线,DenseNet在前6个epoch一直领先ResNet约2~4pp,说明特征复用还让收敛更快。
代价是慢3.3倍:DenseNet121跑8个epoch用了2022秒,ResNet18只用610秒。原因正如§1.21所说:密集拼接让中间特征图通道数线性增长,内存访问成为瓶颈。这是DenseNet在工业落地时没像ResNet那样通吃的根本原因——参数省但计算不省,显存还更吃。
余弦退火的收益在末段才释放。本次8 epoch的ResNet18到0.8755,而Day21的ResNet18训满15 epoch到0.9024:轮数少一半,准确率低2.7pp。看Day21的逐轮曲线就明白——它第11轮的测试准确率才0.8799,是余弦退火把lr压到很小之后,末3轮连跳到0.9024;本次只训8轮,lr还没退到位就停了,退火红利没兑现完。两次配置接近(Day21是lr=0.1,本次是lr=0.05,增强与调度相同),主要差别在轮数。调度要给它足够的时间把lr退完。
# 1.25 架构演进总结:从LeNet到ViT的20年
把整个系列出场过的架构排成时间线:
| 年份 | 架构 | 关键创新 | 我们的实践 |
|---|---|---|---|
| 1998 | LeNet | 卷积+池化的雏形 | Day20手写LeNet在MNIST |
| 2012 | AlexNet | ReLU+Dropout+GPU训练 | Day21训AlexNet(CIFAR) |
| 2014 | VGG | 小3×3卷积堆叠,统一结构 | Day21训VGG11(CIFAR) |
| 2014 | GoogleNet/Inception | 多尺度并行卷积(1/3/5×5) | Day20概念了解 |
| 2015 | ResNet | 跨层跳连,解决退化 | Day21训ResNet18(CIFAR), Day22跳连消融 |
| 2017 | DenseNet | 密集连接+特征复用 | 今天训DenseNet121 |
| 2019 | EfficientNet | NAS基线+复合缩放 | 概念了解 |
| 2020 | ViT | 图像patch化+纯Transformer | 今天patch embedding演示 |
一条贯穿的主线:网络越来越深,但每一层越来越"会偷懒"——从AlexNet每层重算所有特征,到ResNet隔层相加,到DenseNet跨层复用,再到EfficientNet用NAS自动搜索最优结构,最后ViT干脆放弃卷积的局部先验,让注意力自己学该看哪里。这背后是算力、数据和理论三者的共同演进:算力大了才堆得动深网,数据多了才养得起ViT这种无先验的模型,理论(跳连、BN、注意力)每前进一步都解锁了更深结构的可训性。
# 小结
| 要点 | 内容 |
|---|---|
| GAN结构 | 生成器G(转置卷积)对抗判别器D(跨步卷积) |
| 目标 | minmax博弈, 均衡时D输出0.5 |
| 训练纪律 | 先D后G各一步;Adam β1=0.5;D末端不加Sigmoid;假图detach |
| DCGAN规范 | G用BN+ReLU, D用LeakyReLU, 100维噪声起步 |
| 体检方式 | 看固定噪声采样图, 不看G loss数值 |
| 失败模式 | D过强→G学不动; 模式崩溃→只会画一种图 |
| 风格迁移 | 冻结VGG, 优化图像本身:内容特征+Gram纹理 |
| 谱系 | AE→VAE→GAN→扩散 |
| 优化器 | 公式要点 | 解决了什么 | 注意 |
|---|---|---|---|
| SGD | 起点 | 梯度噪声大, 需调lr | |
| Momentum | 加惯性, 抑制震荡 | SGD的一个参数 | |
| AdaGrad | 累积平方和做分母 | 自适应lr, 利好稀疏特征 | lr单调递减会冻死 |
| RMSProp | EMA平方做分母 | 修正AdaGrad冻死 | 早期主力 |
| Adam | Momentum+RMSProp+偏差修正 | 合体, 起步快 | 默认lr未必最优 |
| AdamW | Adam+解耦权重衰减 | 正则强度与自适应独立 | LLM/Transformer标配 |
| 技巧 | 一句话原理 | 适用 | 注意 |
|---|---|---|---|
| LR Finder | lr扫描找loss最陡处 | 任何新任务起步 | 起始lr取最低点1/10 |
| 标签平滑 | one-hot→(1-ε)+ε/K | 分类几乎无脑加 | ε=0.1常见 |
| Mixup | 两图线性混合+软标签 | 大模型长训练 | 短训练反而掉点 |
| CutMix | 剪块拼接保留局部 | 分类、检测 | 多数情况略优于Mixup |
| 梯度裁剪 | 砍梯度总范数尖峰 | RNN、GAN、Transformer | max_norm=1.0常见 |
一句话决策:小模型短训练优先SGD+momentum+调度,大模型长训练(尤其Transformer类)用AdamW;调参起步先跑LR Finder,分类任务默认开label_smoothing=0.1,大模型长训练叠Mixup/CutMix,Transformer/RNN/GAN必带梯度裁剪;GAN特殊,降到0.5。这套"调参五件套"构成了现代训练优化的标配工具箱。
| 架构 | 思想 | 优势 | 代价 |
|---|---|---|---|
| DenseNet | 每层拼接所有前层 | 参数省, 收敛快, 梯度好 | 显存吃, 慢3倍 |
| EfficientNet | NAS基线+复合缩放 | 精度/参数比高 | 工程复杂 |
| ViT | 图像patch化+纯Transformer | 无局部先验, 数据多时上限高 | 数据少易过拟合, 平方复杂度 |
深度学习图像主线,到今天正式收官。从Day16的一个感知机起步,到Day17手撕网络与学习机制,Day18反向传播与训练稳定性,Day19 PyTorch与自动微分,Day20训练核心与CNN,Day21工程化与CIFAR-10实战,Day22评估与可解释,再到今天的GAN、优化全攻略与架构演进——卷积视觉的整条骨干已经完整。后面的路:NLP系列已用Transformer开场(见nlp-day01.md),大模型系列的预训练/微调、多模态的扩散与CLIP,都将建立在这套地基之上。10000小时,继续。