
# 勤奋的凯尔森同学10000h刻意练习Day20:PyTorch训练核心与卷积神经网络 —— 损失、优化器、房价预测到CNN五大件
所属专栏: 凯尔森的10000h刻意练习
Slogan: 一个36岁程序员, 研究生(学硕),前世界500强top20软件开发Java工程师,用10000小时深耕AI, 目标Top10 AI资深工程师, 全程日更记录。
有了autograd,可一个完整的训练循环还缺什么?面对图像,全连接层为什么守不住空间结构?
Day19练熟了PyTorch的张量操作和自动微分。今天先把训练链路补全:用nn.Module搭模型、nn.Loss算损失、torch.optim更新参数,在房价预测上跑通第一个PyTorch训练闭环。然后从表格数据跨入图像——全连接层会把图片拉成一维向量,丢掉空间结构;卷积神经网络(CNN)用卷积核、池化和通道守住它。从LeNet到ResNet的四大经典架构,最后在Fashion MNIST上实战。
# 1.1 前置回顾:参数初始化与Dropout
今天的目标是用PyTorch走完一个端到端回归项目。需要的积木前几天都已备齐,这里只做索引,不再重复推导:
| 积木 | 原理出处 | PyTorch API出处 |
|---|---|---|
| 为什么不能全零初始化、激活值方差为什么要稳 | Day18 §1.3 | Day19 §1.4.2(nn.init速查表) |
| Xavier(配Tanh)/He(配ReLU) | Day18 §1.3 | xavier_normal_ / kaiming_normal_ |
| 给整个模型批量初始化 | — | Day19 §1.4.3 model.apply(fn) |
| Dropout抗过拟合 | Day18 §1.4 | Day19 §1.4.4 nn.Dropout(p) |
| train/eval模式开关 | — | Day19 §1.4.4(今天1.5节的训练循环会实战) |
房价案例是一个浅层全连接网络(隐藏层用ReLU),因此初始化采用He正态初始化,写法就是1.5节里的model.apply(init_weight)。
# 1.2 前置回顾:nn.Module与Sequential
搭模型的两种方式Day19 §1.5已经完整练过,这里只回顾选型原则,不再重复同一个3-4-4-2示例:
- 直线型网络(一层的输出就是下一层的输入,无分支)用
nn.Sequential,按顺序把层塞进去即可; - 带分支/跳连/多输入输出的网络(Day21的ResNet残差连接就是典型)必须继承
nn.Module,在forward里自由描述数据流。
两个与"工程交付"有关的API记个脸熟:
named_parameters()返回(名字, 参数)迭代器,适合逐层检查梯度;state_dict()返回参数字典,是保存/加载模型权重的标准格式——Day21做checkpoint与断点续训时正式使用。
今天的房价模型两种写法都会出现:1.5.3节用nn.Sequential快速搭一个可训练的回归网络。
# 1.3 损失函数:给模型指路的"成绩单"
损失函数是训练的方向盘:它把"模型预测得有多好"量化成一个标量,反向传播顺着它的梯度往下走。分类任务和回归任务,各有各的损失函数。
# 1.3.1 分类任务损失函数
二分类任务损失函数
二分类用二元交叉熵(BCE)损失,公式推导见Day17 §1.2。PyTorch里有两个选择:nn.BCELoss(要求输入已经过sigmoid)和nn.BCEWithLogitsLoss(内部融合sigmoid,数值更稳定,默认推荐)。下面演示BCELoss的用法:
import torch
import torch.nn as nn

# 真实值
target = torch.tensor([[1], [0], [0]], dtype=torch.float32)
# 预测值
input = torch.randn((3, 1))
prediction = torch.sigmoid(input)
# 实例化损失函数
loss = nn.BCELoss()
print(loss(prediction, target))
2
3
4
5
6
7
8
9
10
11
多分类任务损失函数
多分类用多类交叉熵(CCE)损失,公式同样见Day17 §1.2。PyTorch中使用nn.CrossEntropyLoss:
注意:调用nn.CrossEntropyLoss相当于先LogSoftmax再NLLLoss。即使用CrossEntropyLoss时,网络最后一层的输出不需要Softmax激活函数,损失内部会自动处理。
import torch
import torch.nn as nn

# 真实值为标签
target = torch.tensor([1, 0, 3, 2, 5, 4])  # 真实值
input = torch.randn((6, 8))  # 预测值
loss = nn.CrossEntropyLoss()  # 实例化损失函数
print(loss(input, target))

# 真实值为概率
target = torch.randn(6, 8).softmax(dim=1)  # 真实值
input = torch.randn((6, 8))  # 预测值
loss = nn.CrossEntropyLoss()  # 实例化损失函数
print(loss(input, target))
2
3
4
5
6
7
8
9
10
11
12
13
14
这条注意非常重要:用了CrossEntropyLoss,网络最后一层就不要再加Softmax,否则相当于做了两次Softmax,损失值会莫名其妙地偏大——这是面试和实战里的高频坑。
# 1.3.2 回归任务损失函数
MAE
平均绝对误差(Mean Absolute Error,MAE),也称L1 Loss:
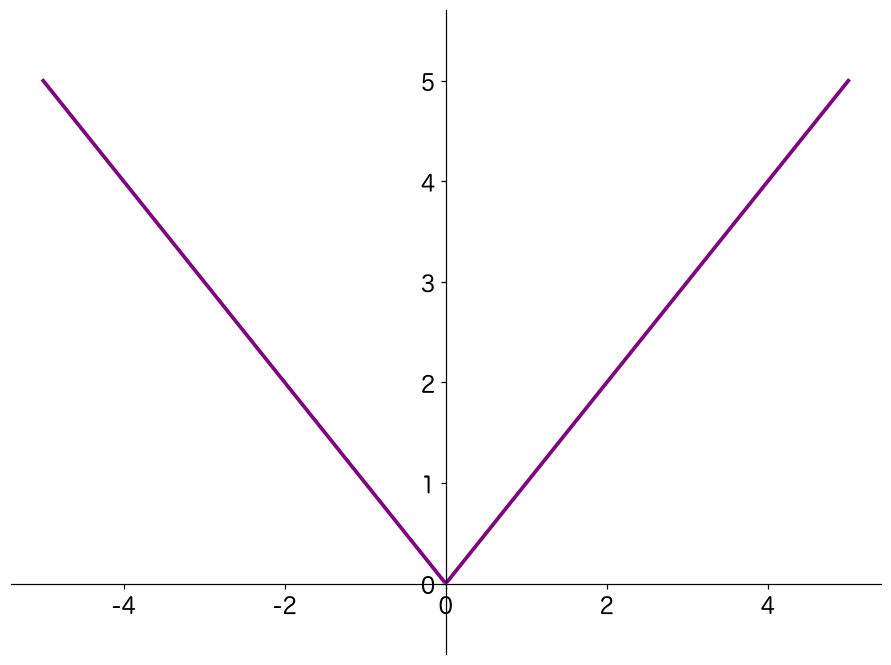
L1 Loss对异常值鲁棒,但在0点处不可导。
MSE
均方误差(Mean Squared Error,MSE),也称L2 Loss:
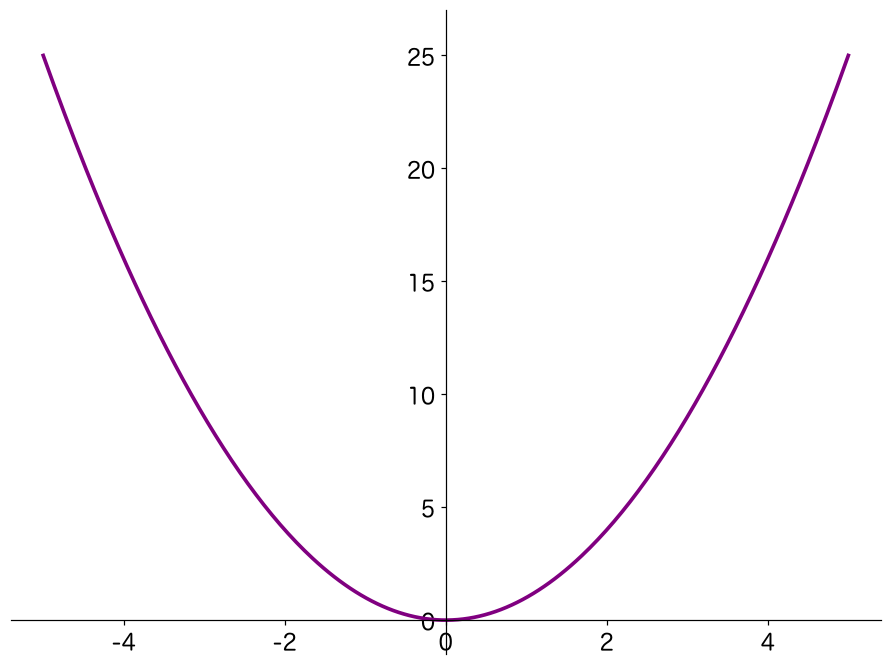
L2 Loss对异常值敏感,遇到异常值时易发生梯度爆炸。
Smooth L1
平滑L1:
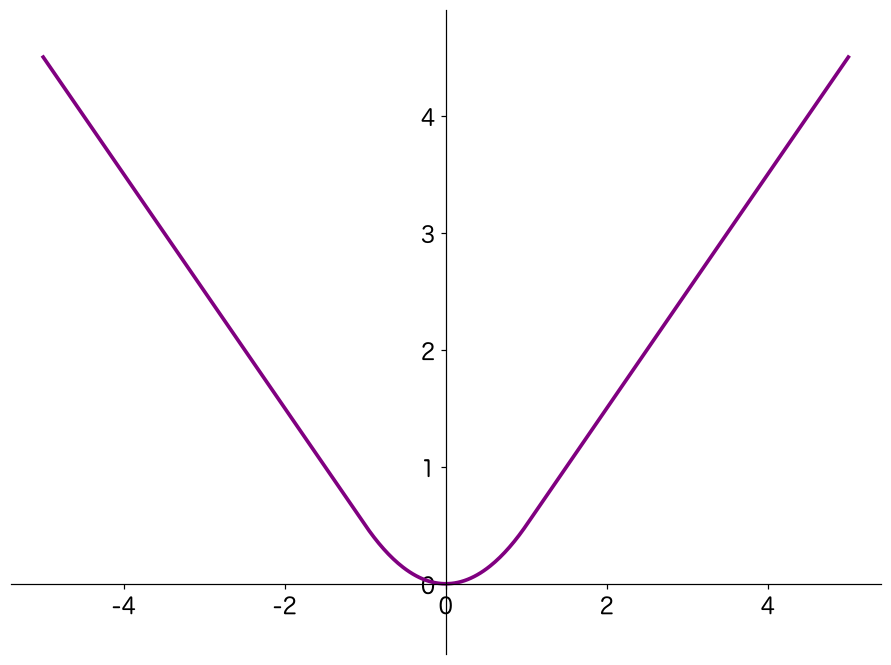
当误差较小时()使用L2 Loss,使得损失函数平滑可导。当误差较大时()使用L1 Loss降低异常值的影响。
Smooth L1就是"两头占便宜":小误差享受L2的平滑可导,大误差享受L1的抗异常值——目标检测里边框回归的标配。
示例代码:
import torch
from torch import nn, optim

class Model(nn.Module):
    # 初始化
    def __init__(self):
        # 调用父类初始化
        super(Model, self).__init__()
        # 全连接层
        self.linear1 = nn.Linear(5, 3)
        # 初始化权重
        self.linear1.weight.data = torch.tensor(
            [
                [0.1, 0.2, 0.3],
                [0.4, 0.5, 0.6],
                [0.7, 0.8, 0.9],
                [0.10, 1.1, 1.2],
                [1.3, 1.4, 1.5],
            ]
        ).T
        # 初始化偏置
        self.linear1.bias.data = torch.tensor([1.0, 2.0, 3.0])

    # 前向传播
    def forward(self, x):
        x = self.linear1(x)
        return x

# 实例化模型
model = Model()
# 输入值
X = torch.tensor([[1, 2, 3, 4, 5], [6, 7, 8, 9, 10]], dtype=torch.float)
# 目标值
target = torch.tensor([[0, 0, 0], [0, 0, 0]], dtype=torch.float)
# 计算出输出值
output = model(X)
# 损失函数
loss = nn.MSELoss()
# 优化器(在反向前创建好即可)
optimizer = optim.SGD(model.parameters(), lr=1)
# 标准三连, 顺序不要乱: 清空梯度 -> 反向传播 -> 更新参数
optimizer.zero_grad()
loss(output, target).backward()
optimizer.step()
# 打印参数
for i in model.state_dict():
    print(i)
    print(model.state_dict()[i])
print()
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
这段代码把前面几节的内容串成了一条完整的训练链路:搭模型(nn.Module)→ 算损失(nn.MSELoss)→ 清空梯度(zero_grad)→ 反向传播(backward)→ 更新参数(step)。注意zero_grad不能省且放在反传之前:PyTorch的梯度默认是累积的,不清零就会把上一轮的梯度加进这一轮(但在梯度累积等特定场景下,这个"特性"会被主动利用,后续碰到再细讲)。
# 1.4 torch.optim:五种优化器与学习率调度
SGD、Momentum、AdaGrad、RMSProp、Adam的更新公式与演进逻辑Day18 §1.2已经推导过(一句话脉络:SGD只看当前梯度→Momentum加惯性→AdaGrad逐参数自适应但会"熄火"→RMSprop用指数移动平均治熄火→Adam合体),本节只讲工程实现:统一的torch.optim接口长什么样、五种优化器在同一地形上的轨迹差异、以及学习率调度器怎么挂进训练循环。
# 1.4.1 torch.optim API速查
| 优化器 | 构造方式 | 关键超参数 |
|---|---|---|
| SGD | optim.SGD(model.parameters(), lr) | lr |
| Momentum | optim.SGD(..., momentum=0.9) | lr、momentum |
| AdaGrad | optim.Adagrad(..., lr) | lr |
| RMSProp | optim.RMSprop(..., lr, alpha=0.99) | lr、alpha |
| Adam | optim.Adam(..., lr, betas=(0.9, 0.999)) | lr、betas |
所有优化器还有一个共同的常用参数weight_decay(L2正则系数,原理见Day18 §1.4),例如optim.Adam(model.parameters(), lr=1e-3, weight_decay=1e-4)。更新动作永远是标准三连:zero_grad() → backward() → step()。
# 1.4.2 五种优化器轨迹对比实验
鱼书里最经典的实验:在"峡谷"函数上(方向平缓、方向陡峭),让五种优化器从同一点出发,画轨迹。用torch.optim统一接口后,换优化器只改构造函数一行;各优化器的学习率和迭代次数与Day18手动实现保持一致:
import torch
import numpy as np
import matplotlib.pyplot as plt

torch.manual_seed(42)
start = torch.tensor([-7.0, 2.0])
coef = torch.tensor([0.05, 1.0])

def run(optimizer_factory, n_iters):
    x = start.clone().requires_grad_(True)
    opt = optimizer_factory([x])
    traj = [x.detach().numpy().copy()]
    for _ in range(n_iters):
        opt.zero_grad()
        (x**2 * coef).sum().backward()   # 峡谷函数作为损失
        opt.step()
        traj.append(x.detach().numpy().copy())
    return np.array(traj)

# 各优化器参数与Day18手动实现保持一致
optimizers = [
    ("SGD",      lambda p: torch.optim.SGD(p, lr=0.9), 30),
    ("Momentum", lambda p: torch.optim.SGD(p, lr=0.9, momentum=0.12), 30),
    ("AdaGrad",  lambda p: torch.optim.Adagrad(p, lr=0.95, eps=1e-8), 30),
    ("RMSprop",  lambda p: torch.optim.RMSprop(p, lr=0.1, alpha=0.99, eps=1e-8), 100),
    ("Adam",     lambda p: torch.optim.Adam(p, lr=0.1, betas=(0.9, 0.999), eps=1e-8), 200),
]
trajectories = {name: run(f, n) for name, f, n in optimizers}

# 绘制等高线与五条轨迹
fig, ax = plt.subplots(figsize=(6.5, 4.8), dpi=120)
x1_grid, x2_grid = np.meshgrid(np.linspace(-7.2, 7.2, 300), np.linspace(-2.1, 2.1, 300))
levels = np.arange(0.05, 4.6, 0.15)
ax.contour(x1_grid, x2_grid, 0.05*x1_grid**2 + x2_grid**2,
           levels=levels, colors='#666666', linewidths=0.8)
colors = {'SGD': 'red', 'Momentum': 'blue', 'AdaGrad': 'green',
          'RMSprop': 'purple', 'Adam': 'orange'}
for name, traj in trajectories.items():
    ax.plot(traj[:, 0], traj[:, 1], color=colors[name], linewidth=1.5, label=name)
ax.set_xlim(-7.0, 7.0)
ax.set_ylim(-2.0, 2.0)
ax.set_xticks([-6, -4, -2, 0, 2, 4, 6])
ax.set_yticks([-2.0, -1.5, -1.0, -0.5, 0.0, 0.5, 1.0, 1.5, 2.0])
ax.legend(loc='upper right', frameon=True, facecolor='white',
          edgecolor='black', framealpha=1.0, fontsize=10)
plt.tight_layout()
plt.show()

for name, traj in trajectories.items():
    print(f"{name:9s} 终点: ({traj[-1, 0]:+.4f}, {traj[-1, 1]:+.4f})")
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
SGD       终点: (-0.4134, +0.0025)
Momentum  终点: (-0.2651, -0.0000)
AdaGrad   终点: (-0.9212, +0.0000)
RMSprop   终点: (-0.0019, +0.0000)
Adam      终点: (+0.0022, +0.0001)
2
3
4
5
四条结论和Day18的公式完全对应:①SGD在峡谷里沿陡坡方向震荡(y方向衰减因子,30步后y仍有残余)、沿缓坡方向慢爬(x方向衰减因子,30步到-0.41);②Momentum的惯性(gamma=0.12)抵消了震荡分量,比SGD更快收敛到谷底;③AdaGrad在缓坡方向越走越慢,30步后还在-0.92——这就是只增不减导致的"提前熄火";④RMSProp/Adam用指数移动平均替代无限累加,既快又不熄火,这也是Adam成为默认首选的原因。
# 1.4.3 学习率调度:先大步快跑,再小步微调
学习率是训练里最关键的超参数:太大在最优附近反复横跳,太小收敛慢。朴素策略是前期大、后期小,PyTorch用lr_scheduler在每个epoch结束后调整学习率,注意调用顺序:optimizer.step()更新参数,然后scheduler.step()衰减学习率。
| 调度器 | 行为 | 典型参数 |
|---|---|---|
StepLR | 每step_size轮乘一次gamma | step_size=20, gamma=0.7 |
MultiStepLR | 在milestones指定的轮次衰减 | milestones=[10,50,200], gamma=0.7 |
ExponentialLR | 每轮平滑乘gamma | gamma=0.99 |
CosineAnnealingLR | 余弦曲线平滑降到接近0(Day22会实测对比) | T_max=总epoch数 |
import torch

x = torch.tensor([-7.0, 2.0], requires_grad=True)
optimizer = torch.optim.SGD([x], lr=0.9)
scheduler = torch.optim.lr_scheduler.StepLR(optimizer, step_size=100, gamma=0.5)

lr_history = []
for epoch in range(400):
    lr_history.append(optimizer.param_groups[0]["lr"])  # 先记录当前lr
    optimizer.zero_grad()
    (0.05*x[0]**2 + x[1]**2).backward()
    optimizer.step()    # 更新参数
    scheduler.step()    # 再衰减学习率(顺序不要反)

print("起始lr:", lr_history[0], " 第150轮lr:", lr_history[150], " 末尾lr:", round(lr_history[-1], 4))
2
3
4
5
6
7
8
9
10
11
12
13
14
15
起始lr: 0.9 第150轮lr: 0.45 末尾lr: 0.1125
等间隔一刀切用StepLR,想配合验证集表现手动控制节奏用MultiStepLR,追求平滑用ExponentialLR或余弦退火——1.5节的房价案例为了突出主线没有挂scheduler,真实项目里Adam默认即可,SGD训练深网时调度器几乎是必选项。
# 1.5 应用案例:房价预测
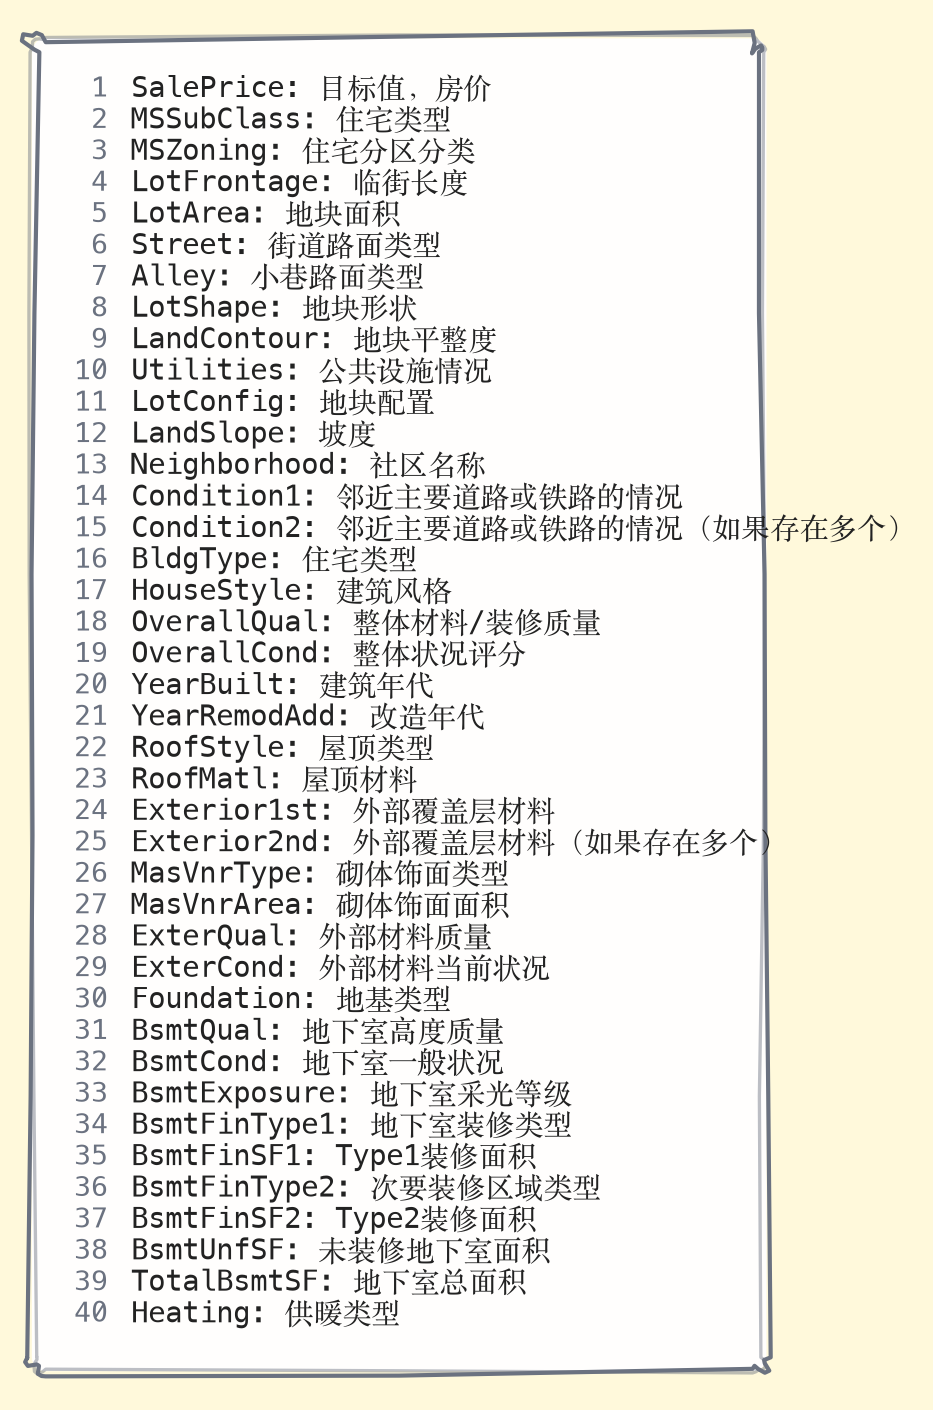
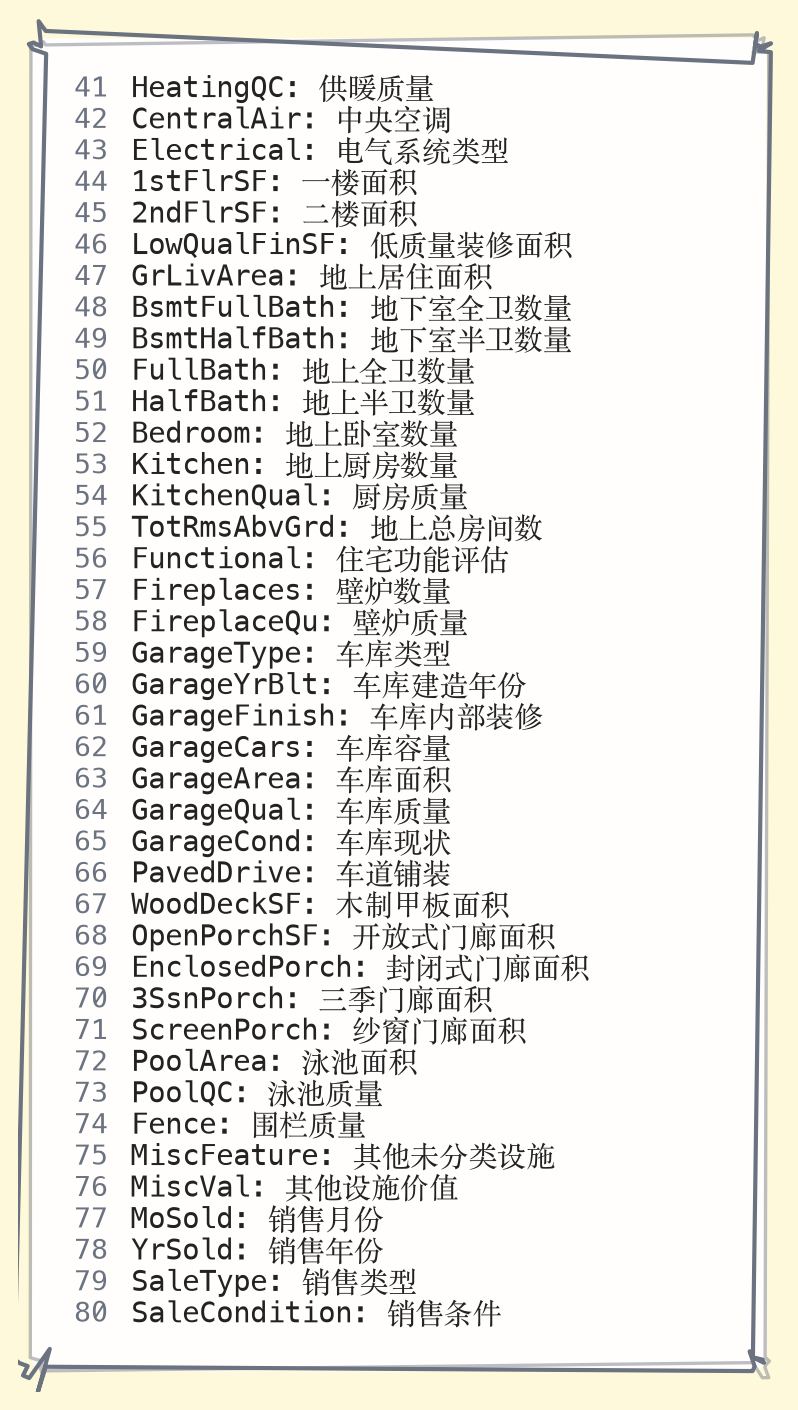
理论讲完,上一个端到端的完整案例把今天所有组件串起来。先安装pandas和scikit-learn库:pip install pandas scikit-learn。
使用House Prices数据集:https://www.kaggle.com/c/house-prices-advanced-regression-techniques (opens new window)。
# 1.5.1 导入所需的模块
import torch
import pandas as pd
import torch.nn as nn
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split
from sklearn.pipeline import Pipeline
from sklearn.impute import SimpleImputer
from sklearn.compose import ColumnTransformer
from sklearn.preprocessing import StandardScaler, OneHotEncoder
from torch.utils.data import TensorDataset, DataLoader
2
3
4
5
6
7
8
9
10
# 1.5.2 特征工程
对特征进行处理,数值型特征使用均值填充缺失值,再标准化;类别型特征使用字符串"NaN"填充缺失值,再独热编码。优先用Kaggle房价数据(data/house_prices.csv,含数值+类别特征),离线环境自动兜底为sklearn加州房价(8个数值特征,无类别特征,独热编码分支不会触发):
import os
import numpy as np

def load_data():
    """优先用Kaggle房价数据(house_prices.csv); 离线环境兜底用sklearn内置加州房价(8个数值特征)"""
    if os.path.exists("data/house_prices.csv"):
        data = pd.read_csv("data/house_prices.csv")
        data.drop(["Id"], axis=1, inplace=True)
        return data, "SalePrice"
    from sklearn.datasets import fetch_california_housing
    housing = fetch_california_housing(as_frame=True)
    return housing.frame, "MedHouseVal"

def create_dataset():
    """构造数据集"""
    # 读取数据
    data, target_col = load_data()
    # 划分特征和目标
    X = data.drop(target_col, axis=1)
    y = data[target_col]
    # 筛选出数值型特征
    numerical_features = X.select_dtypes(exclude="object").columns
    # 筛选出类别型特征
    categorical_features = X.select_dtypes(include="object").columns
    # 划分训练集和测试集
    x_train, x_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
    # 特征预处理
    #   数值型特征先用平均值填充缺失值,再进行标准化
    numerical_transformer = Pipeline(
        steps=[
            ("fillna", SimpleImputer(strategy="mean")),
            ("std", StandardScaler()),
        ]
    )
    #   类别型特征先将缺失值替换为字符串"NaN",再进行独热编码
    categorical_transformer = Pipeline(
        steps=[
            ("fillna", SimpleImputer(strategy="constant", fill_value="NaN")),
            ("onehot", OneHotEncoder(handle_unknown="ignore")),
        ]
    )
    #   组合特征预处理器
    preprocessor = ColumnTransformer(
        transformers=[
            ("num", numerical_transformer, numerical_features),
            ("cat", categorical_transformer, categorical_features),
        ]
    )
    #   进行特征预处理(有类别特征时返回稀疏矩阵需toarray, 纯数值特征直接是ndarray)
    x_train = preprocessor.fit_transform(x_train)
    x_test = preprocessor.transform(x_test)
    if hasattr(x_train, "toarray"):
        x_train = x_train.toarray()
        x_test = x_test.toarray()
    x_train = pd.DataFrame(x_train, columns=preprocessor.get_feature_names_out())
    x_test = pd.DataFrame(x_test, columns=preprocessor.get_feature_names_out())
    # 构建数据集
    train_dataset = TensorDataset(torch.tensor(x_train.values).float(), torch.tensor(y_train.values).float())
    test_dataset = TensorDataset(torch.tensor(x_test.values).float(), torch.tensor(y_test.values).float())
    # 返回训练集,测试集,特征数量
    return train_dataset, test_dataset, x_train.shape[1]

train_dataset, test_dataset, feature_num = create_dataset()
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
# 1.5.3 搭建模型
# 搭建模型
model = nn.Sequential(
    nn.Linear(feature_num, 128),
    nn.BatchNorm1d(128),
    nn.ReLU(),
    nn.Dropout(0.2),
    nn.Linear(128, 1),
)
2
3
4
5
6
7
8
这个Sequential把今天的知识点都用上了:Linear全连接层、ReLU激活、Dropout(0.2)随机失活防过拟合,再加一个BatchNorm1d稳定每层的输入分布。
# 1.5.4 损失函数:对数相对误差
关于房价的预测我们更加关心相对误差而非绝对误差,比如房价原本20万元而误差10万元,那么误差可能难以接受;但若房价原本1000万元而误差为10万元,那误差可能并不算大。因此这里我们使用对数来衡量误差:
# 损失函数
def log_rmse(pred, target):
    mse = nn.MSELoss()
    # squeeze()把长度为1的维度挤掉,让两边形状严格对齐。带下划线的squeeze_()是原地版本
    pred.squeeze_()
    pred = torch.clamp(pred, 1, float("inf"))  # 限制输出在1到正无穷之间
    return torch.sqrt(mse(torch.log(pred), torch.log(target)))
2
3
4
5
6
7
对数变换的妙处:,绝对误差自动变成相对误差。torch.clamp(pred, 1, inf)把预测值限制在1以上,防止对负数取log报错。
# 1.5.5 模型训练
# 模型训练
def train(model, train_dataset, test_dataset, lr, epoch_num, batch_size, device):
    def init_weight(layer):
        # 对线性层的权重进行初始化
        if type(layer) == nn.Linear:
            nn.init.xavier_normal_(layer.weight)

    model.apply(init_weight)  # 初始化参数
    model = model.to(device)  # 将模型加载到设备中
    optimizer = torch.optim.Adam(model.parameters(), lr=lr)  # 优化器

    train_loss_list = []  # 记录训练损失
    test_loss_list = []  # 记录验证损失
    for epoch in range(epoch_num):

        # 训练过程
        model.train()  # 将模型设置为训练模式
        train_loader = DataLoader(train_dataset, batch_size=batch_size, shuffle=True)
        train_loss_accumulate = 0
        # 训练模型
        for batch_count, (X, y) in enumerate(train_loader):
            # 前向传播
            X, y = X.to(device), y.to(device)
            output = model(X)
            # 反向传播
            loss_value = log_rmse(output, y)
            optimizer.zero_grad()
            loss_value.backward()
            optimizer.step()
            # 累加损失
            train_loss_accumulate += loss_value.item()
            # 打印进度条
            print(f"\repoch:{epoch:0>3}[{'='*(int((batch_count+1) / len(train_loader)* 50 )):<50}]", end="")
        this_train_loss = train_loss_accumulate / len(train_loader)  # 计算平均损失
        train_loss_list.append(this_train_loss)  # 记录训练损失

        # 验证过程(注意: 这里的test_dataset实际承担"验证集"角色,
        # Day21会把数据规范地切成train/val/test三份)
        model.eval()  # 将模型设置为评估模式
        test_loader = DataLoader(dataset=test_dataset, batch_size=batch_size, shuffle=False)
        test_loss_accumulate = 0
        with torch.no_grad():  # 关闭梯度计算
            for X, y in test_loader:
                # 前向传播
                X, y = X.to(device), y.to(device)
                output = model(X)
                # 必须在验证集上重新计算损失; 早期版本误写成累加训练阶段的
                # loss_value, 会导致"验证损失"与验证数据无关, 完全失去诊断意义
                test_loss_accumulate += log_rmse(output, y).item()
        this_test_loss = test_loss_accumulate / len(test_loader)  # 计算平均损失
        test_loss_list.append(this_test_loss)  # 记录验证损失

        # 打印训练损失,验证损失
        print(f" train_loss:{this_train_loss:.6f}, test_loss:{this_test_loss:.6f}")
    return train_loss_list, test_loss_list

# 设备选择: NVIDIA显卡用cuda, Apple Silicon(M系列芯片)用mps, 都没有则回退cpu
device = torch.device(
    "cuda" if torch.cuda.is_available()
    else "mps" if torch.backends.mps.is_available()
    else "cpu")
train_loss_list, test_loss_list = train(model, train_dataset, test_dataset, 0.1, 200, 64, device)
plt.plot(train_loss_list, "r-", label="train_loss", linewidth=3)  # 绘制训练损失
plt.plot(test_loss_list, "k--", label="test_loss", linewidth=2)  # 绘制验证损失
plt.legend()
plt.show()
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
这个训练循环是PyTorch的"标准动作",每一行都对应今天的一个组件:model.apply(init_weight)做Xavier初始化,torch.optim.Adam负责参数更新,log_rmse是自定义损失函数,zero_grad → backward → step是反向传播三连,model.train()和model.eval()切换训练/评估模式(Dropout和BatchNorm在两种模式下行为不同),torch.no_grad()让验证阶段不建计算图、省显存提速。
# 1.6 CNN概述:从视觉皮层到三大件
卷积神经网络(Convolutional Neural Network, CNN)常被用于图像识别、语音识别等各种场合。它在计算机视觉领域表现尤为出色,广泛应用于图像分类、目标检测、图像分割等任务。
CNN的灵感来自动物视觉皮层组织的神经连接方式:单个神经元只对有限区域内的刺激作出反应,不同神经元的感知区域相互重叠,从而覆盖整个视野。这就是"局部感受野"思想——后面卷积核的滑动窗口,正是对这个机制的数学复刻。
相比普通神经网络,CNN新出现了卷积层(Convolution层)和池化层(Pooling层),一个典型的CNN结构长这样:
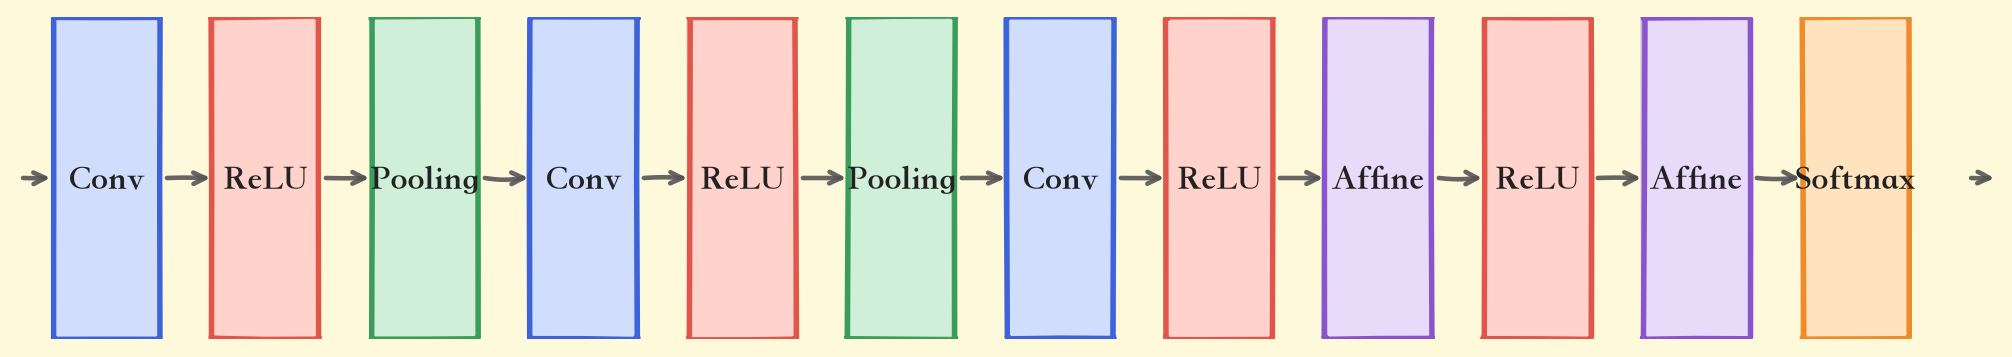
三大件的分工一句话说清:
- 卷积层:提取输入数据的局部特征
- 池化层:降维,增强鲁棒性并防止过拟合
- 全连接层:整合特征并输出结果
# 1.7 卷积层:保住形状的特征提取器
# 1.7.1 为什么全连接层搞不定图像
全连接层中,相邻层的神经元全部连接在一起,输出的数量可以任意决定,但它忽视了数据的形状。输入数据为图像时,图像通常是长、宽、通道方向上的3维数据,向全连接层输入时却需要拉平为1维——3维形状中的空间信息就这样被丢掉了。
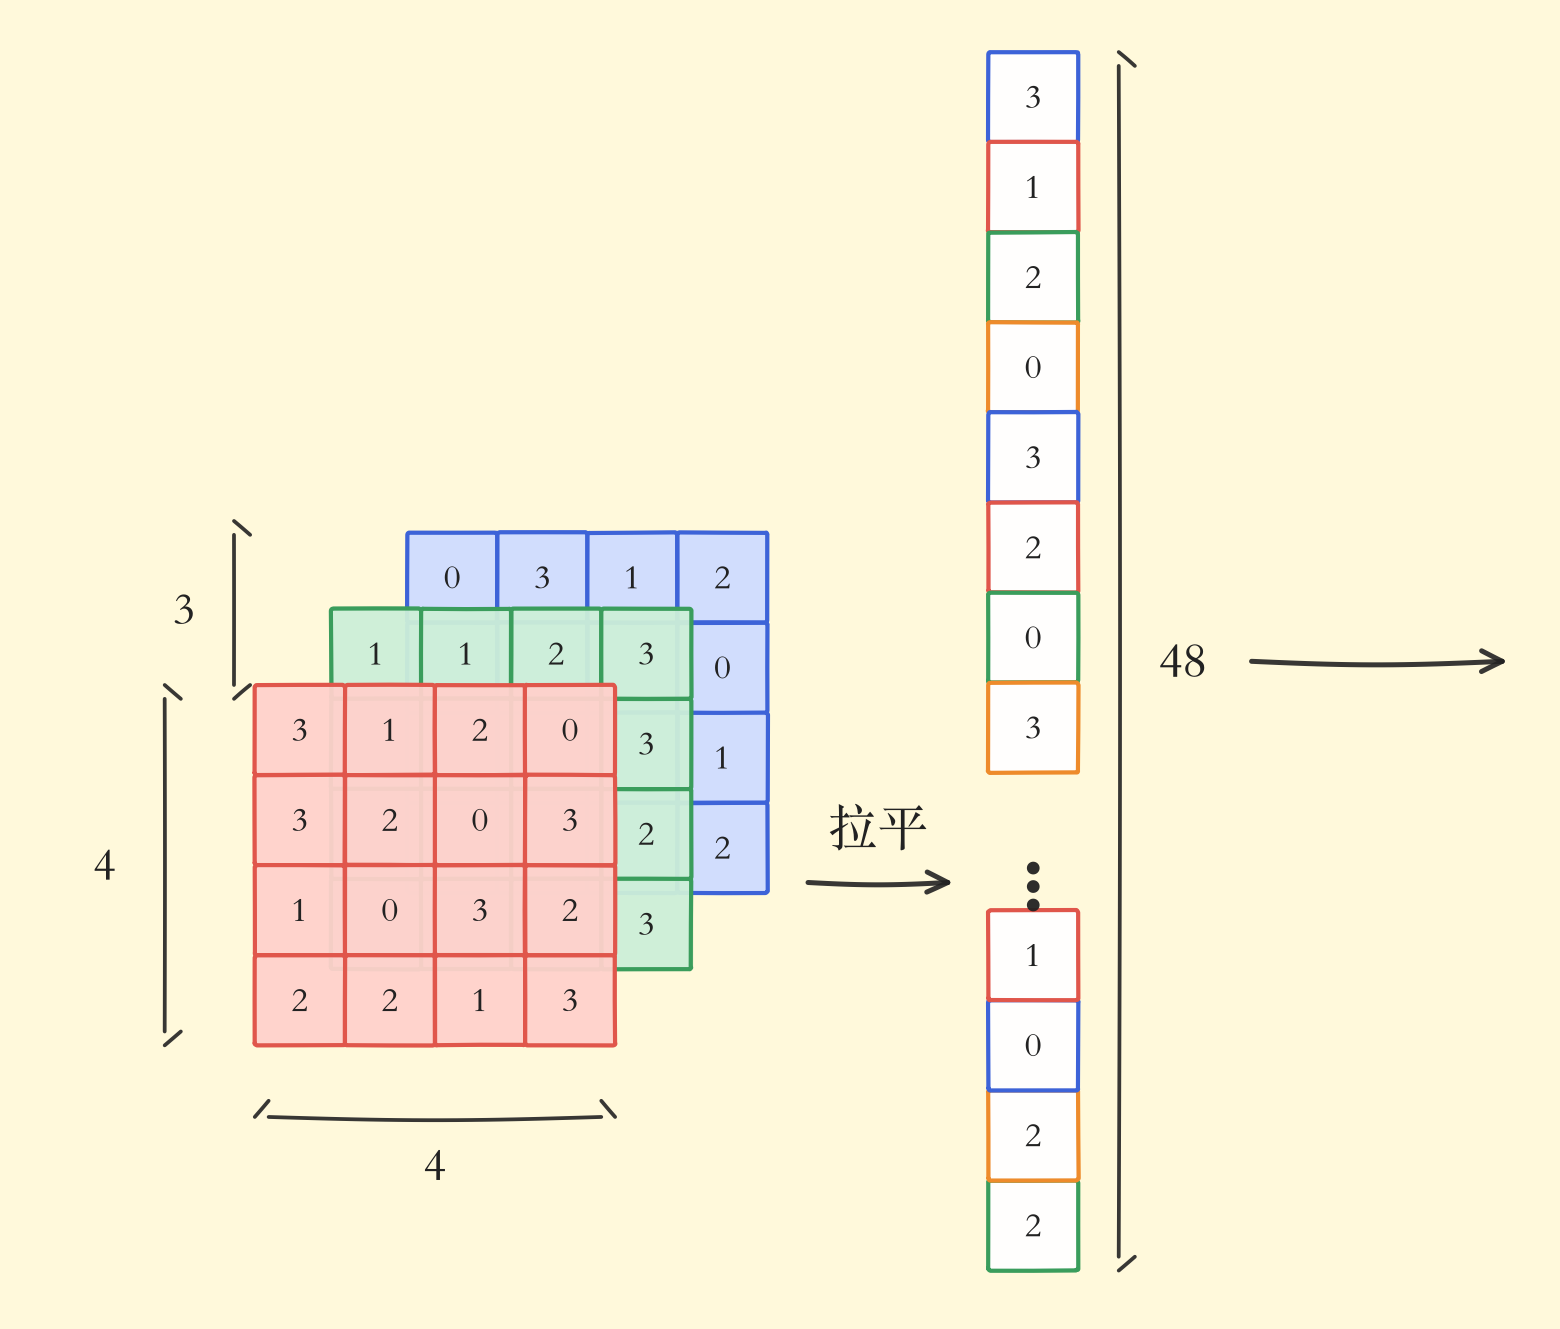
而卷积层可以保持数据形状不变:接收3维形状的输入数据后,同样以3维形状输出至下一层。在CNN中,卷积层的输入输出数据也称为特征图(feature map)。
# 1.7.2 卷积运算:滑动窗口的乘积累加
卷积层对数据进行卷积运算,卷积运算相当于图像处理中的滤波器运算。
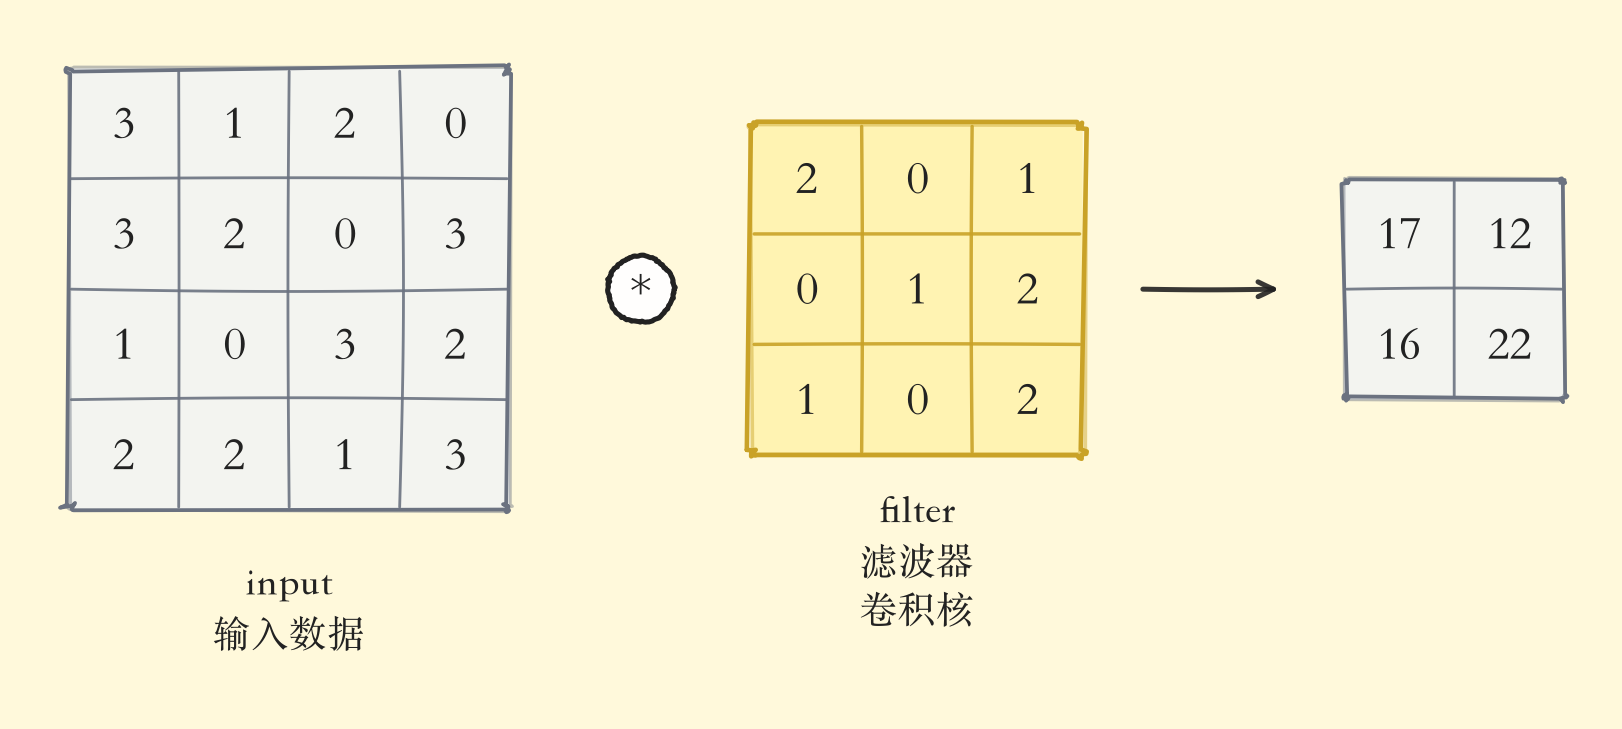
对于输入数据,卷积运算以一定间隔滑动卷积核的窗口并应用:将各个位置上卷积核的元素和输入的对应元素相乘,然后再求和——这个操作也称为乘积累加运算,即矩阵的内积。
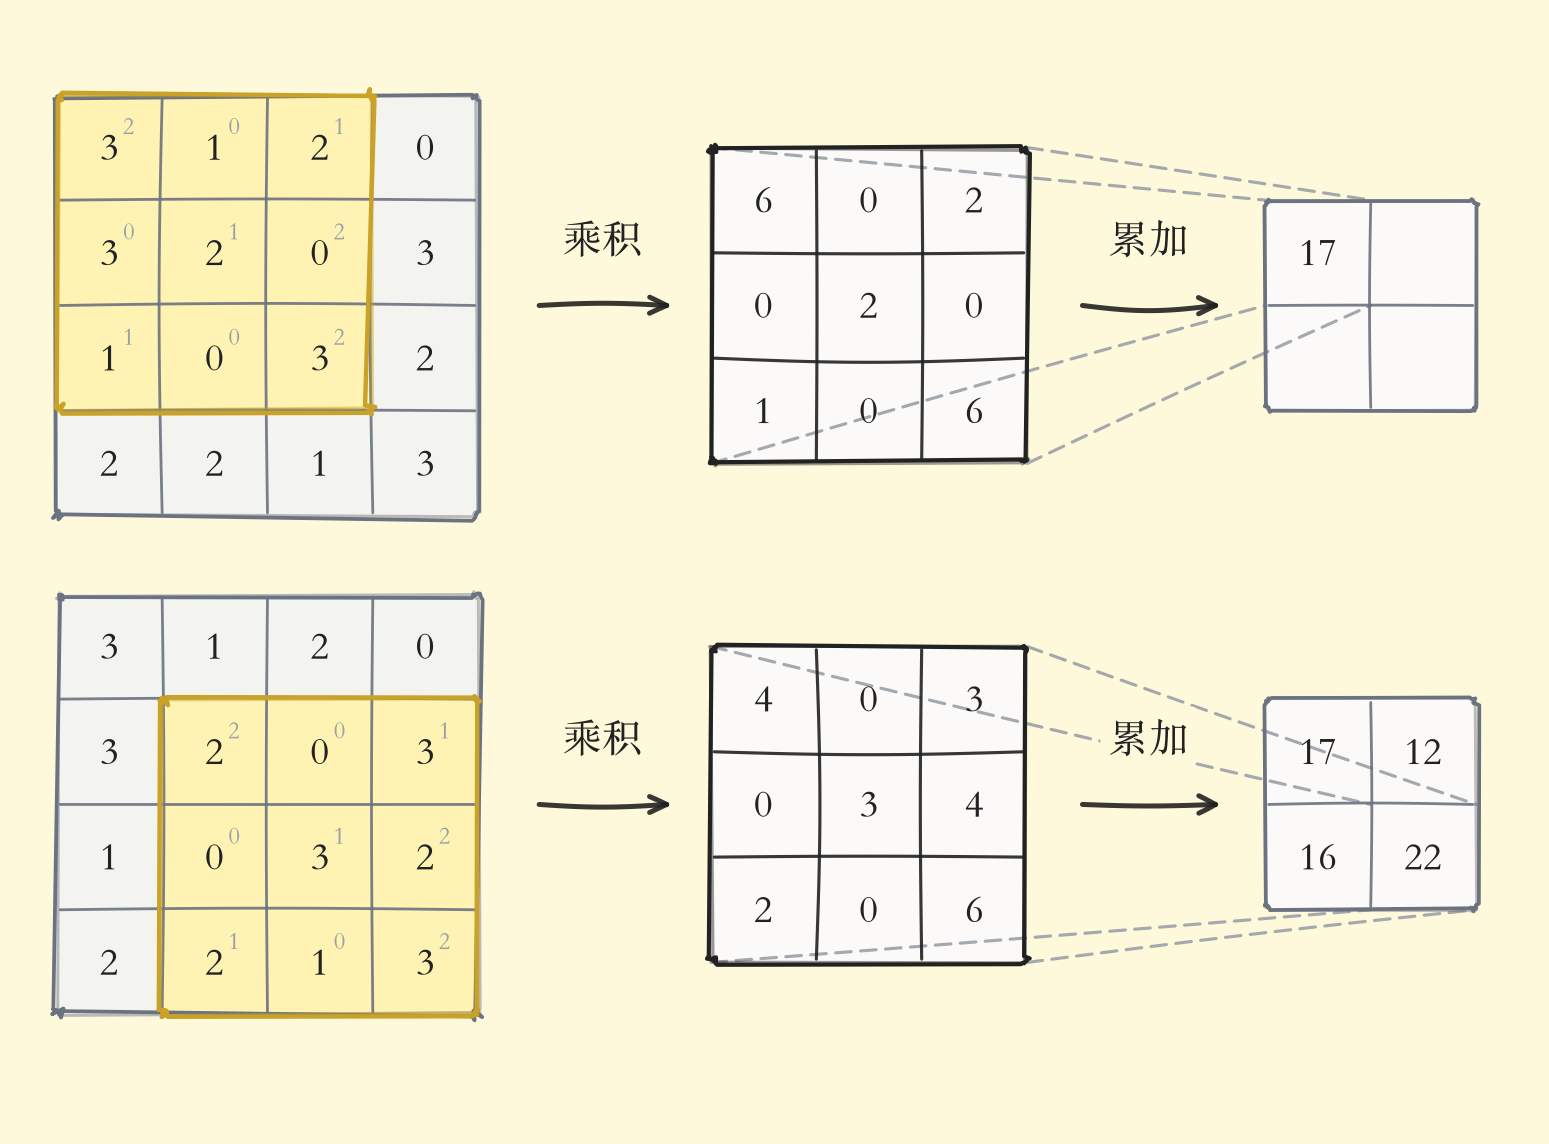
CNN中,卷积核的参数就对应之前的权重,并且CNN中也存在偏置。
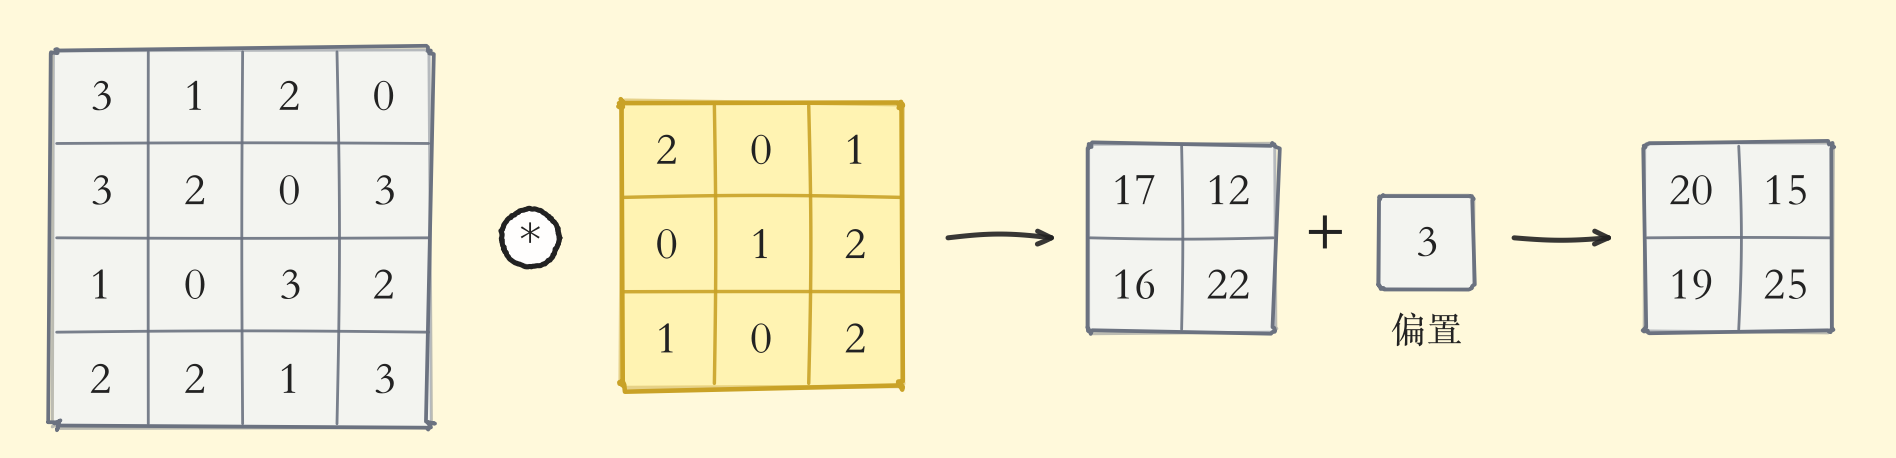
# 1.7.3 填充(padding):给输入"镶边"
在进行卷积层的处理之前,有时要向输入数据的周围填入固定的数据(比如0),这称为填充(padding)。例如对形状为4×4的数据进行幅度为1的填充,即用幅度为1、值为0的数据填充周围:
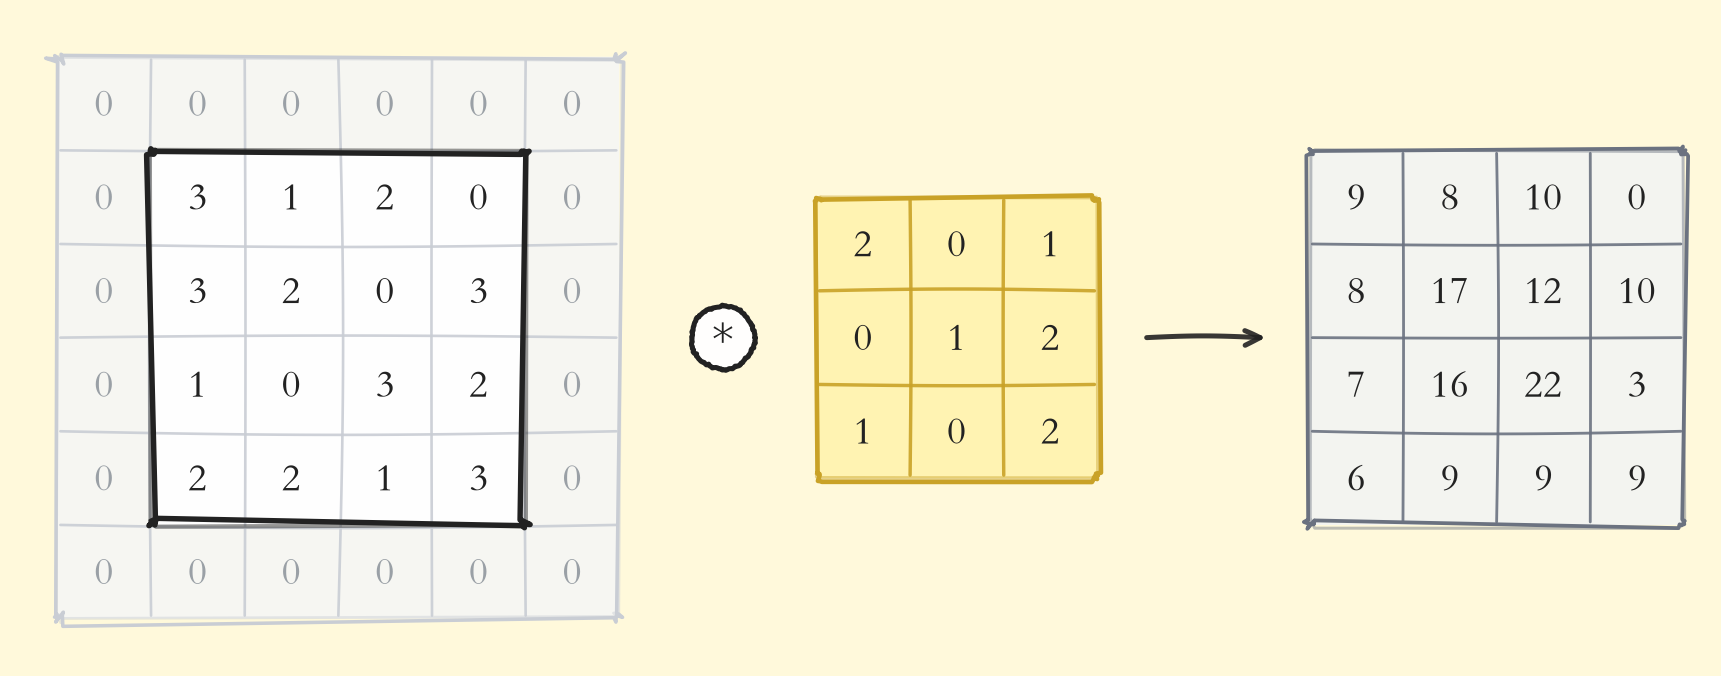
4×4的数据填充幅度1后形状变为6×6,再经过卷积后形状恰好回到4×4。使用填充的主要目的是调整输出数据的形状大小,避免多次卷积后数据越缩越小、小到无法继续卷积。用好填充,可以令数据形状经过卷积运算后保持不变。
# 1.7.4 步幅(stride):卷积核每次走多远
应用卷积核的位置间隔称之为步幅(stride)。
之前的例子中步幅都为1,下面进行步幅为3的卷积运算:
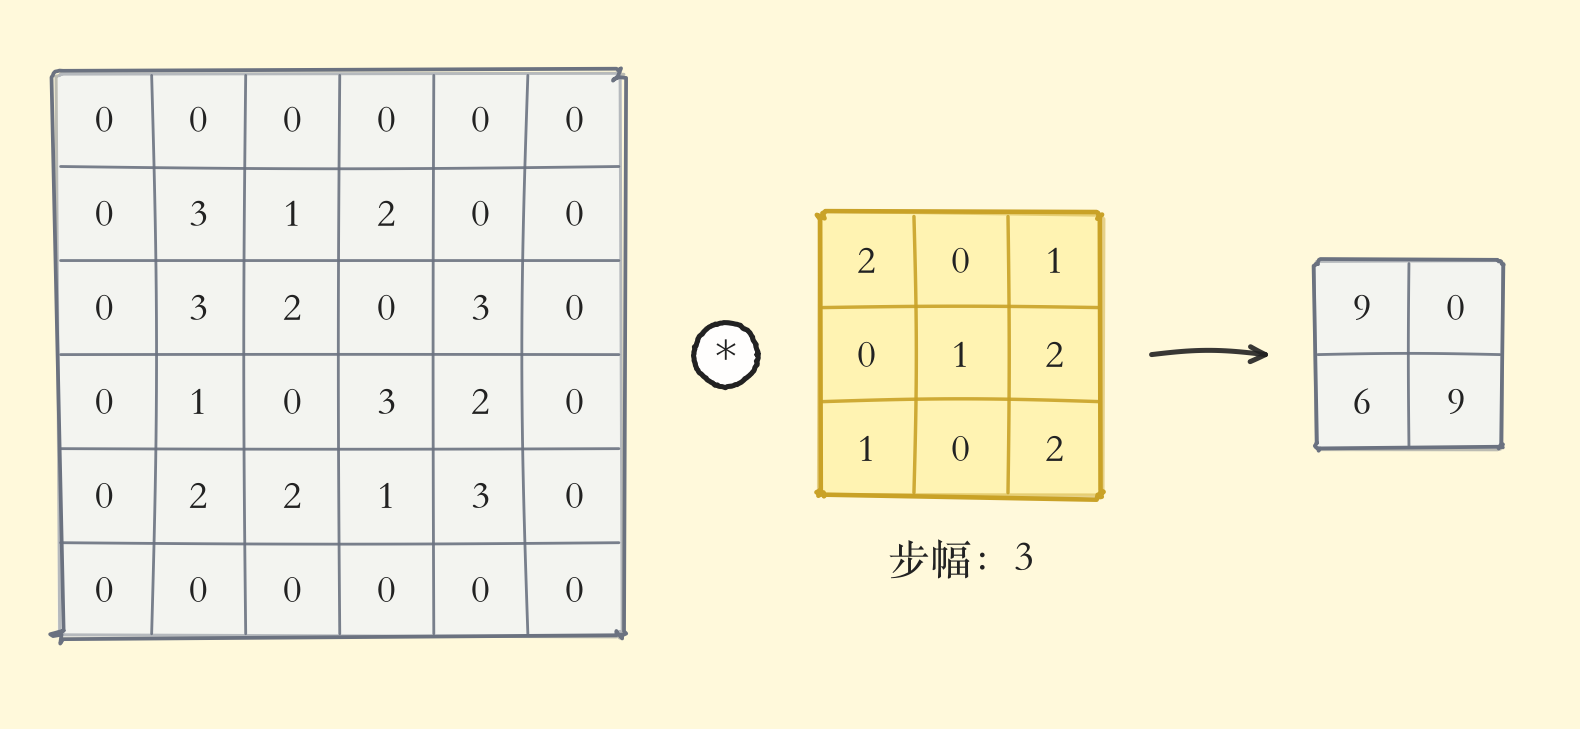
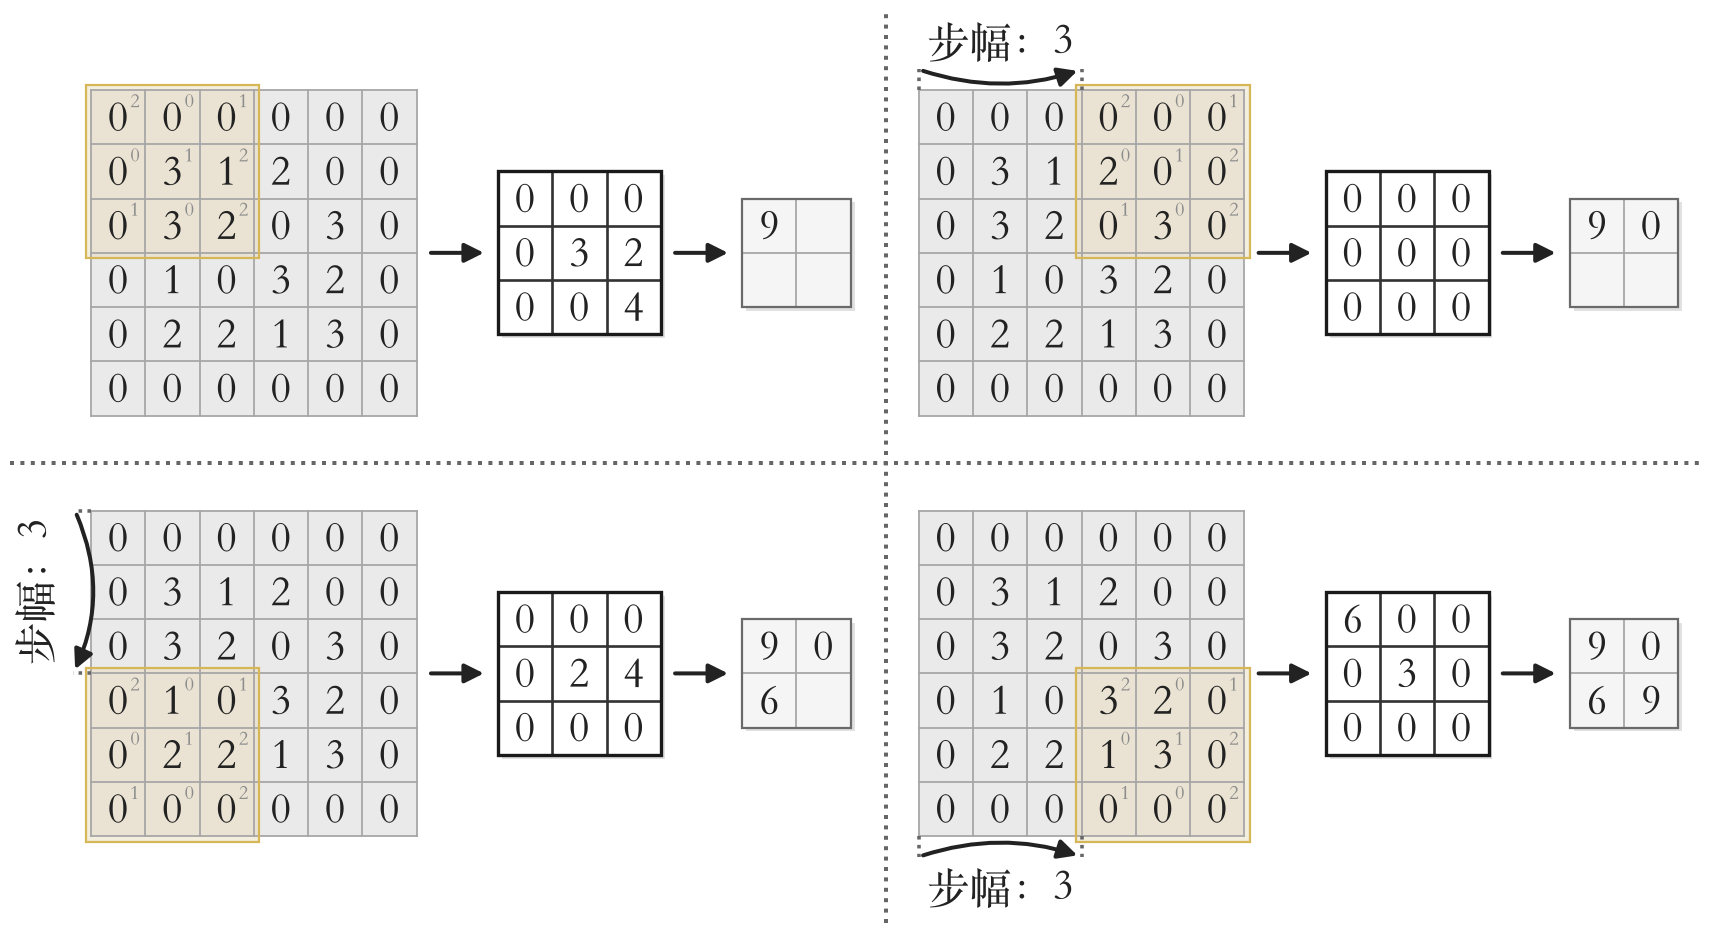
填充和步幅都会影响输出数据的形状大小:增大填充,输出变大;增大步幅,输出变小。给定输入数据形状、卷积核大小、填充、步幅,输出数据形状的计算公式为:
代入验证:对形状的输入数据应用幅度为1的填充,步幅为3,卷积核大小:
得到形状的输出数据。当输出大小无法除尽时,PyTorch卷积层会自动向下取整,输出整数尺寸,舍弃无法覆盖完整卷积核的输入部分。
# 1.7.5 3维数据的卷积运算:通道怎么办
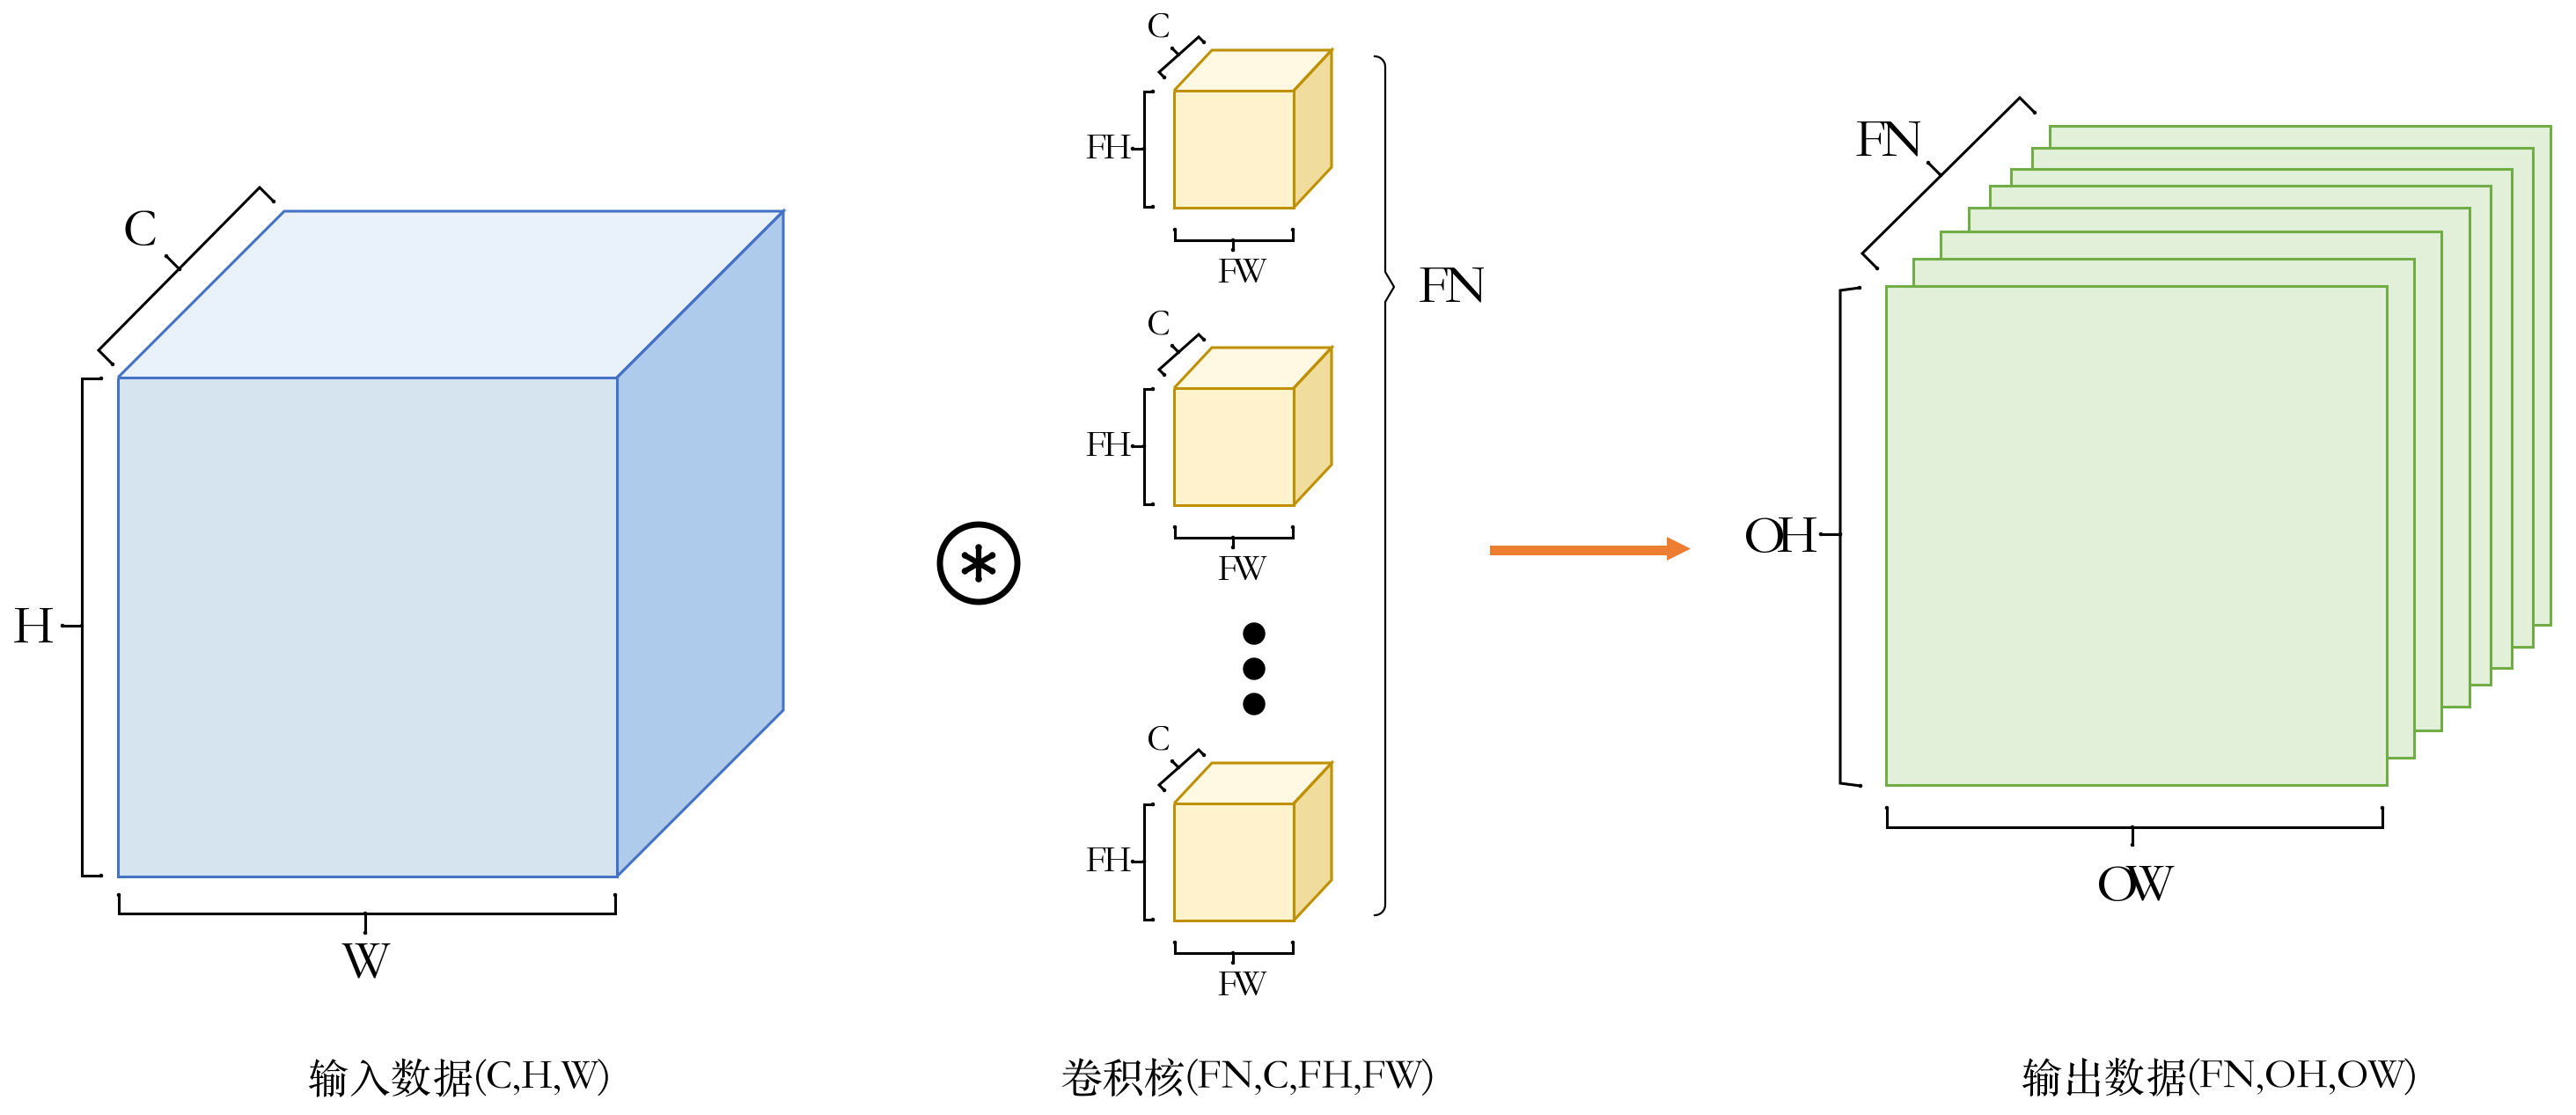
图像是3维数据,除了长、宽外还需要处理通道方向。3维卷积的规矩是:输入数据的通道数和卷积核的通道数必须设为相同的值。有多个通道时,按通道分别进行输入数据和卷积核的卷积运算,并将结果相加得到输出数据。
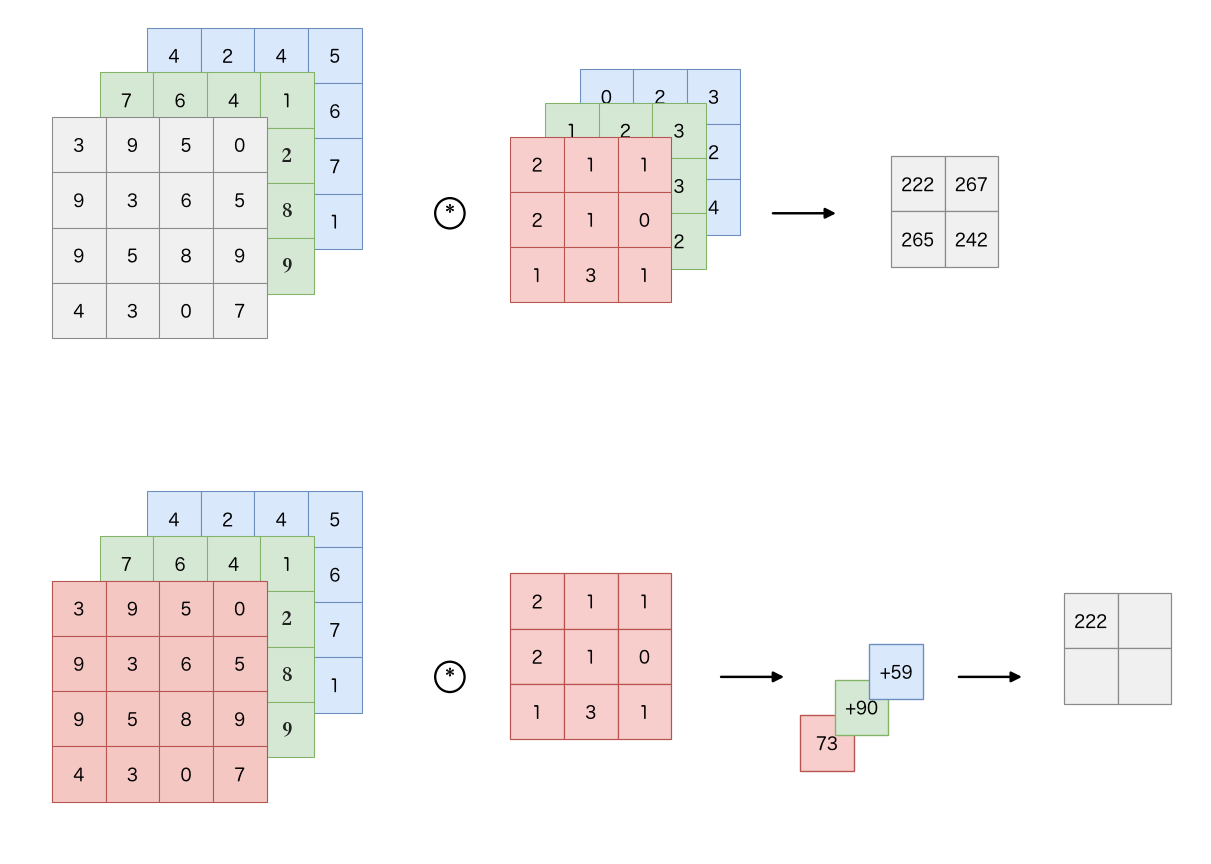
使用1个形状的卷积核,对形状的输入数据进行卷积运算,输出1张形状的特征图,即输出的通道数为1。
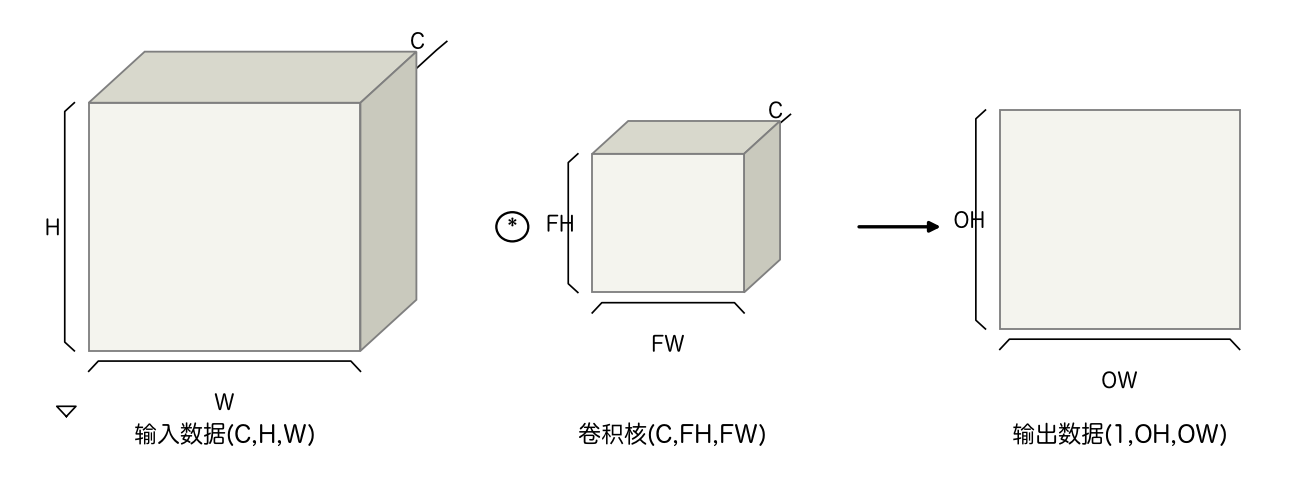
若想在通道方向获得多个卷积运算的输出,需要使用多个卷积核:
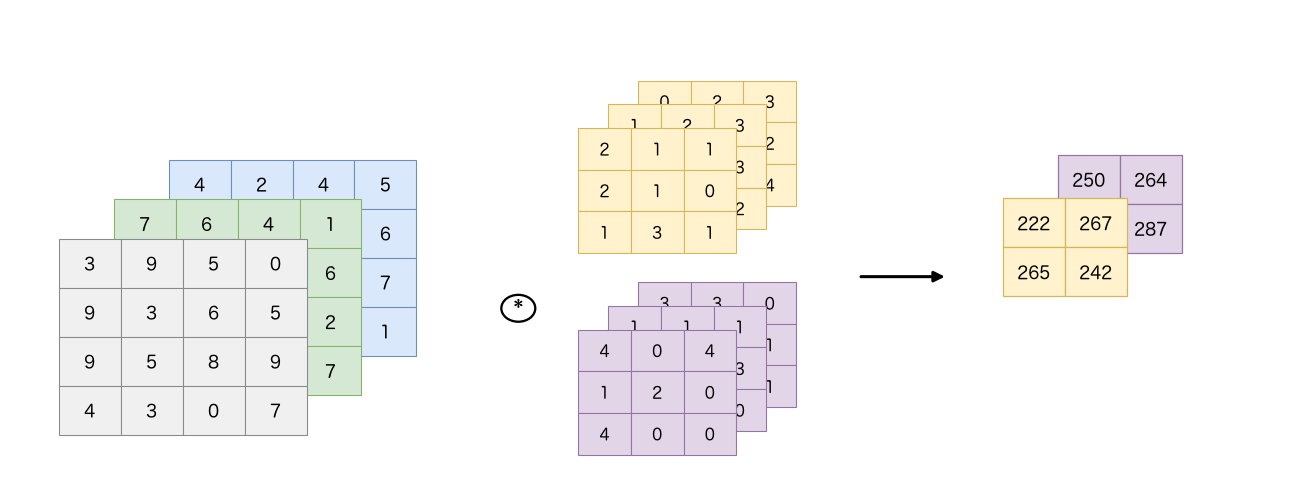
使用个卷积核,输出特征图也变为个:
若考虑偏置,则每个输出通道再加一个偏置:
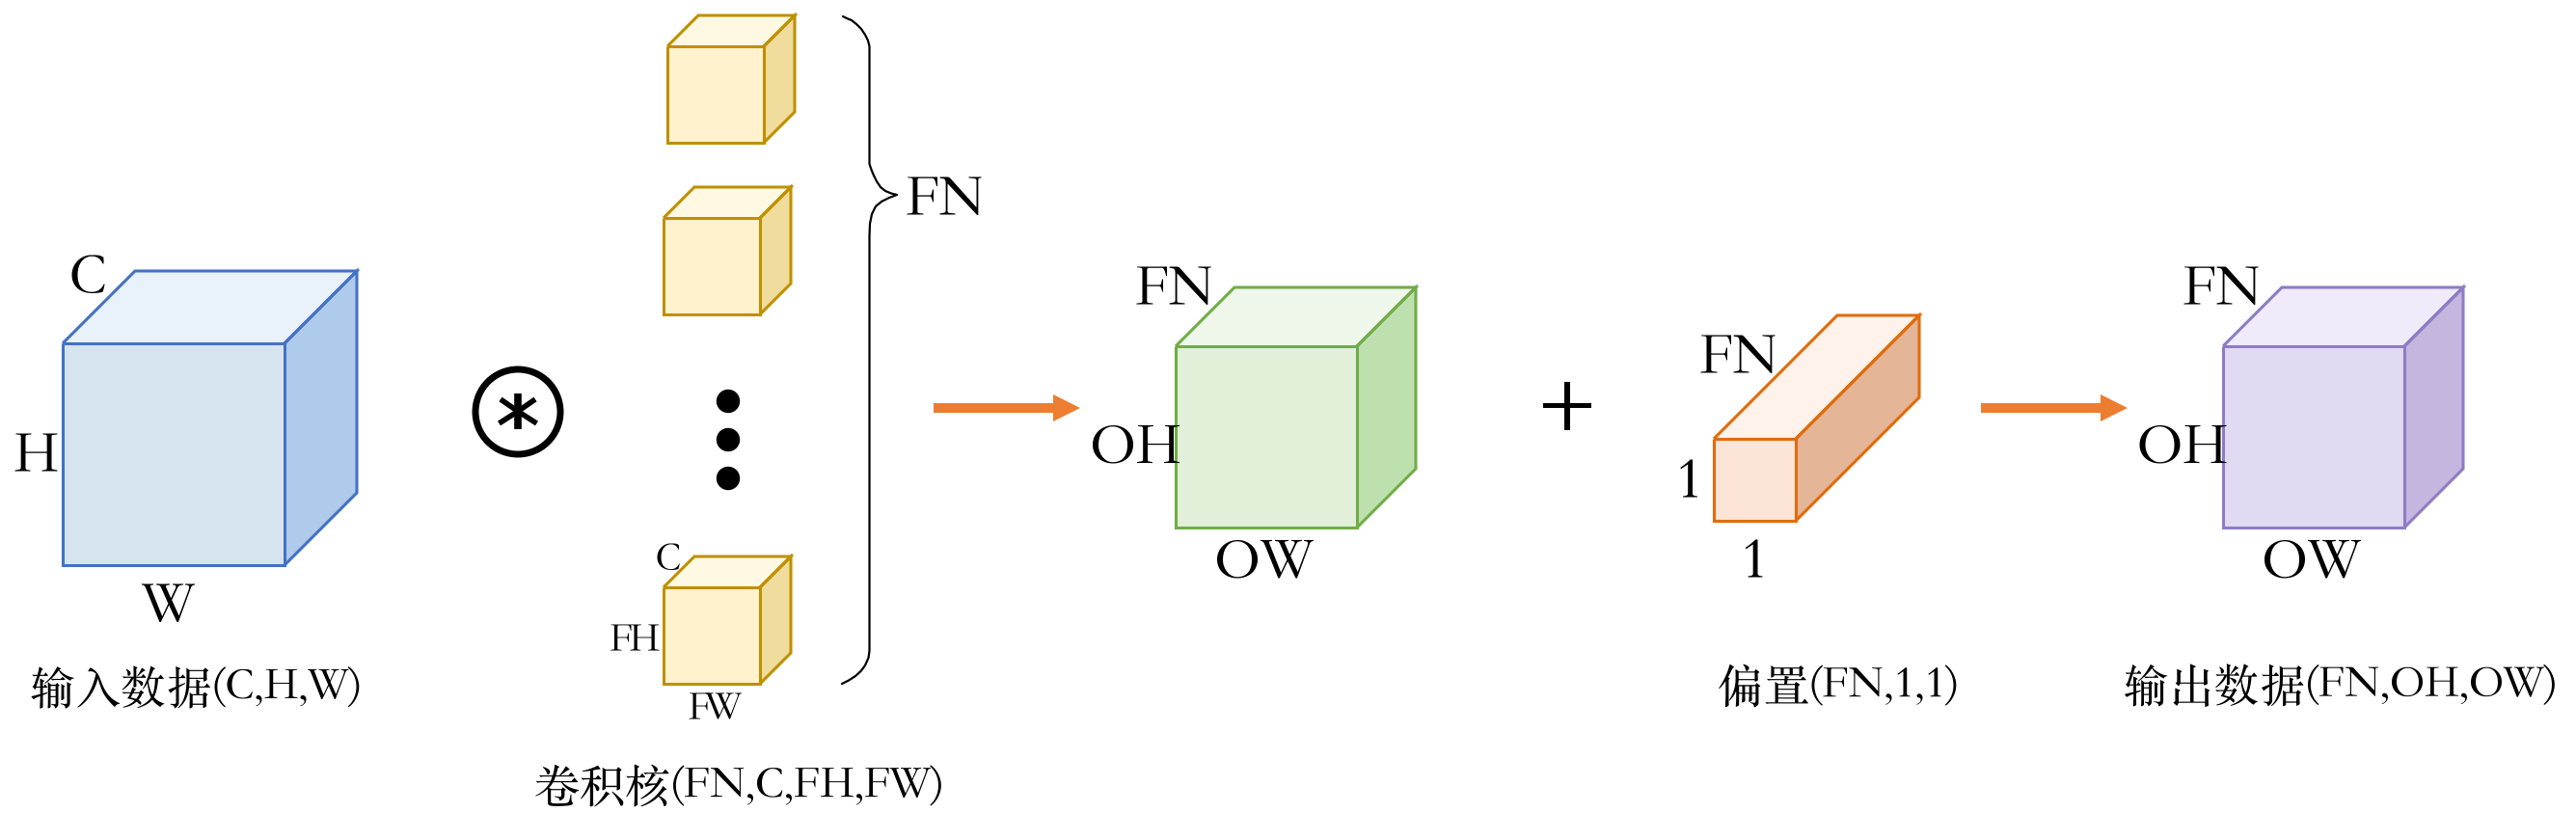
一句话记法:一个卷积核产出一个输出通道,想要多少张特征图,就准备多少个卷积核。
# 1.7.6 API使用:nn.Conv2d五大参数
torch.nn.Conv2d(in_channels, out_channels, kernel_size, stride, padding)
# in_channels:输入通道数
# out_channels:输出通道数
# kernel_size:卷积核大小
# stride:步幅
# padding:填充幅度
2
3
4
5
6
拿一张图片实测:3通道输入、3个9×9卷积核、步幅3,看看卷积后的特征图长什么样。注意nn.Conv2d要求输入是带batch维的4维张量(N,C,H,W),读入的图片只有(H,W,C)三维,需要先permute调整通道顺序,再用unsqueeze(0)补上batch维。优先用本地图片(Kelsen.png或其他图片),离线无图片时用sklearn内置的china示例图片兜底:
import torch
import matplotlib.pyplot as plt
import os

# 读取图片(本地有Kelsen.jpg就用, 没有就用sklearn内置china图片兜底)
if os.path.exists("Kelsen.png"):
    img = plt.imread("Kelsen.png")
else:
    from sklearn.datasets import load_sample_image
    img = load_sample_image("china.jpg")
print("图片数据形状:", img.shape)

# (H,W,C) -> (C,H,W) -> unsqueeze补batch维 -> (1,C,H,W)
input = torch.tensor(img).permute(2, 0, 1).float().unsqueeze(0)
print("输入特征图形状:", input.shape)

# 初始化卷积核
conv = torch.nn.Conv2d(in_channels=3, out_channels=3, kernel_size=9, stride=3, padding=0, bias=False)

# 对输入特征图进行卷积操作
output = conv(input)
print("输出特征图形状:", output.shape)

# 可视化时取第0个样本, 再把通道维挪回最后: (1,C,H',W') -> (C,H',W') -> (H',W',C)
output_img = torch.clamp(output[0].int(), 0, 255).permute(1, 2, 0).numpy()
fig, ax = plt.subplots(1, 2, figsize=(10, 5))
ax[0].imshow(img)
ax[1].imshow(output_img)
plt.axis("off")
plt.show()
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
假设原图是427×640,代入输出形状公式:,,与程序输出一致:
图片数据形状: (427, 640, 3)
输入特征图形状: torch.Size([1, 3, 427, 640])
输出特征图形状: torch.Size([1, 3, 140, 211])
2
3
# 1.8 池化层:降维、鲁棒、零参数
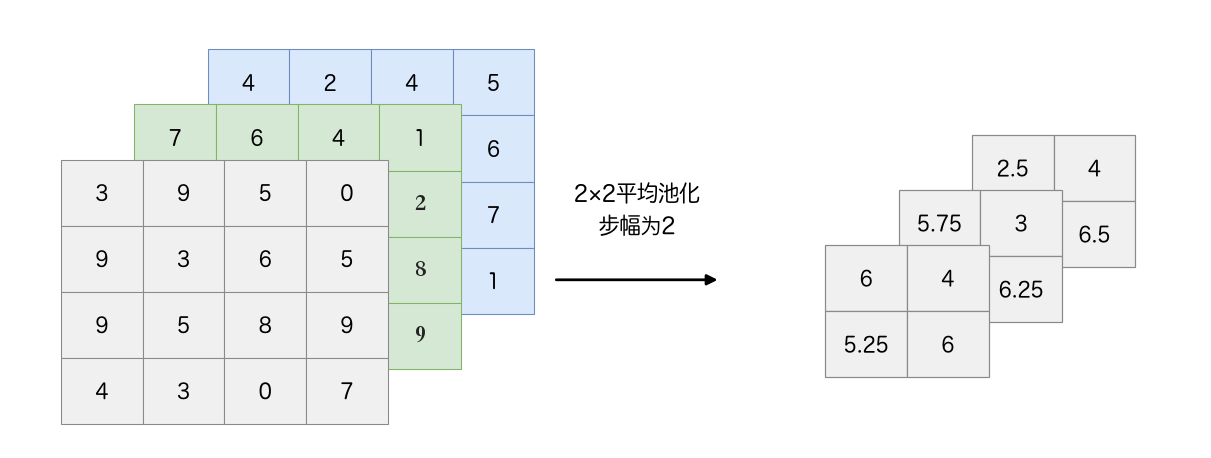
池化层缩小长、宽方向上的空间来进行降维,能够缩减模型的大小并提高计算速度。例如对数据进行步幅为2的2×2 Max池化:
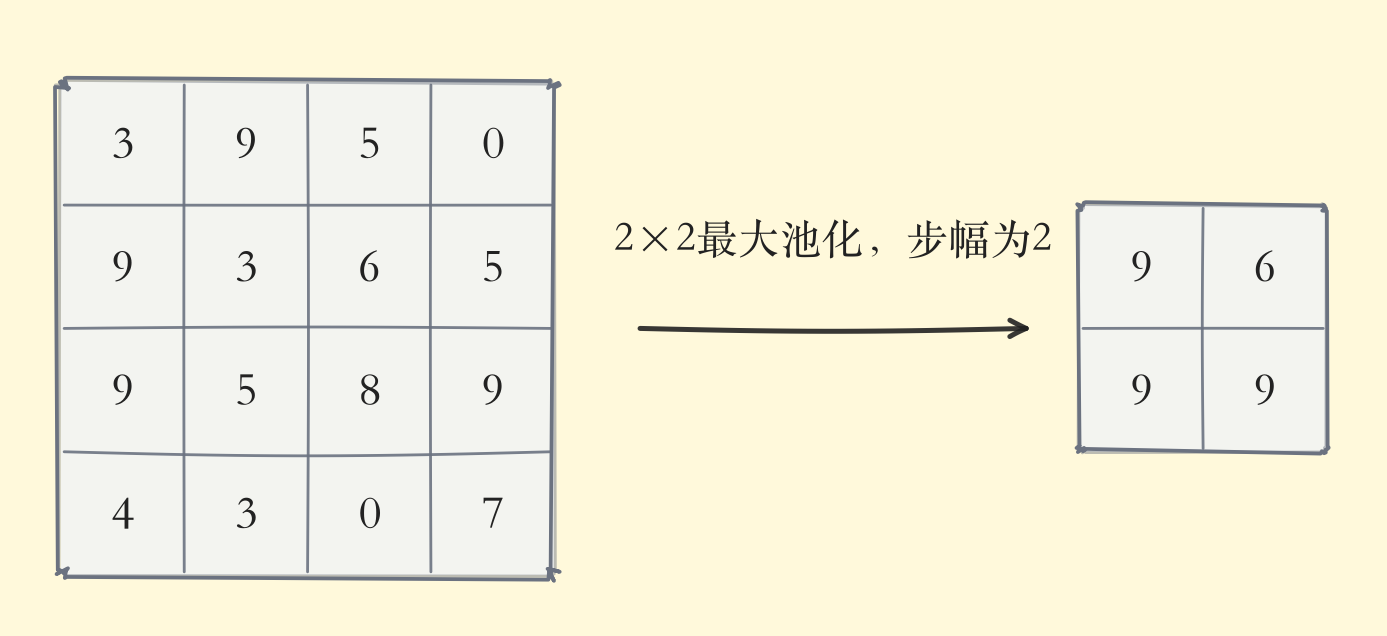
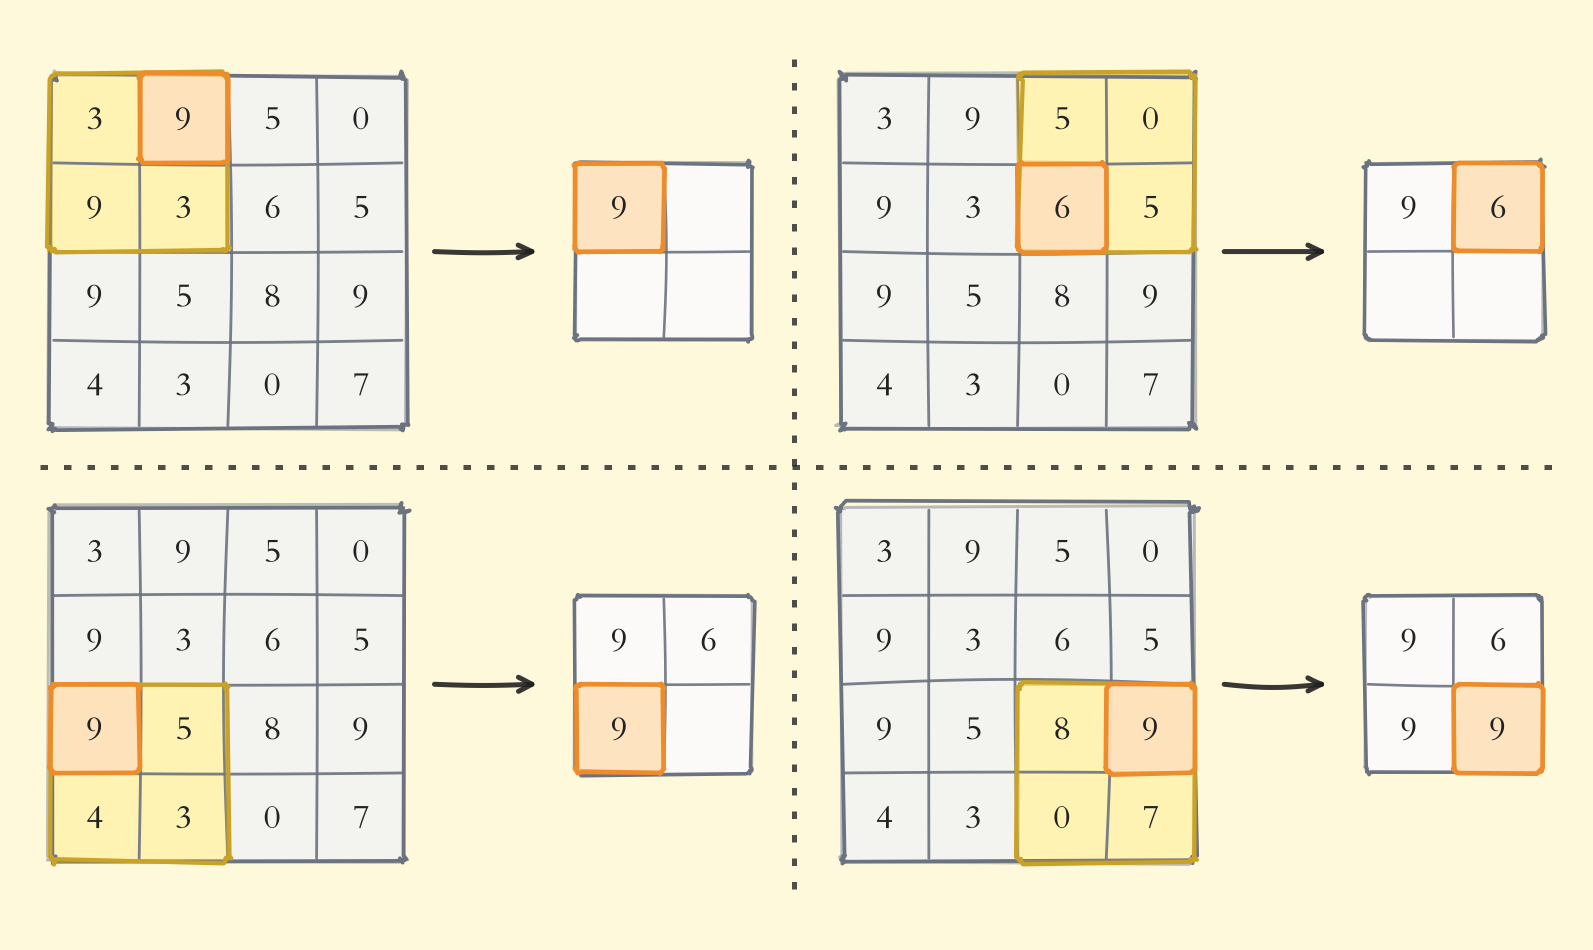
除了Max池化(计算窗口内的最大值),还有Average池化(平均池化,计算窗口内的平均值)等。一般会将池化的大小窗口和步幅设置为相同的值,比如2×2的窗口大小,步幅设置为2。池化同样也可以设置填充。
和卷积层不同,池化层没有要学习的参数,并且池化运算按通道独立进行,经过池化运算后数据的通道数不会发生变化。
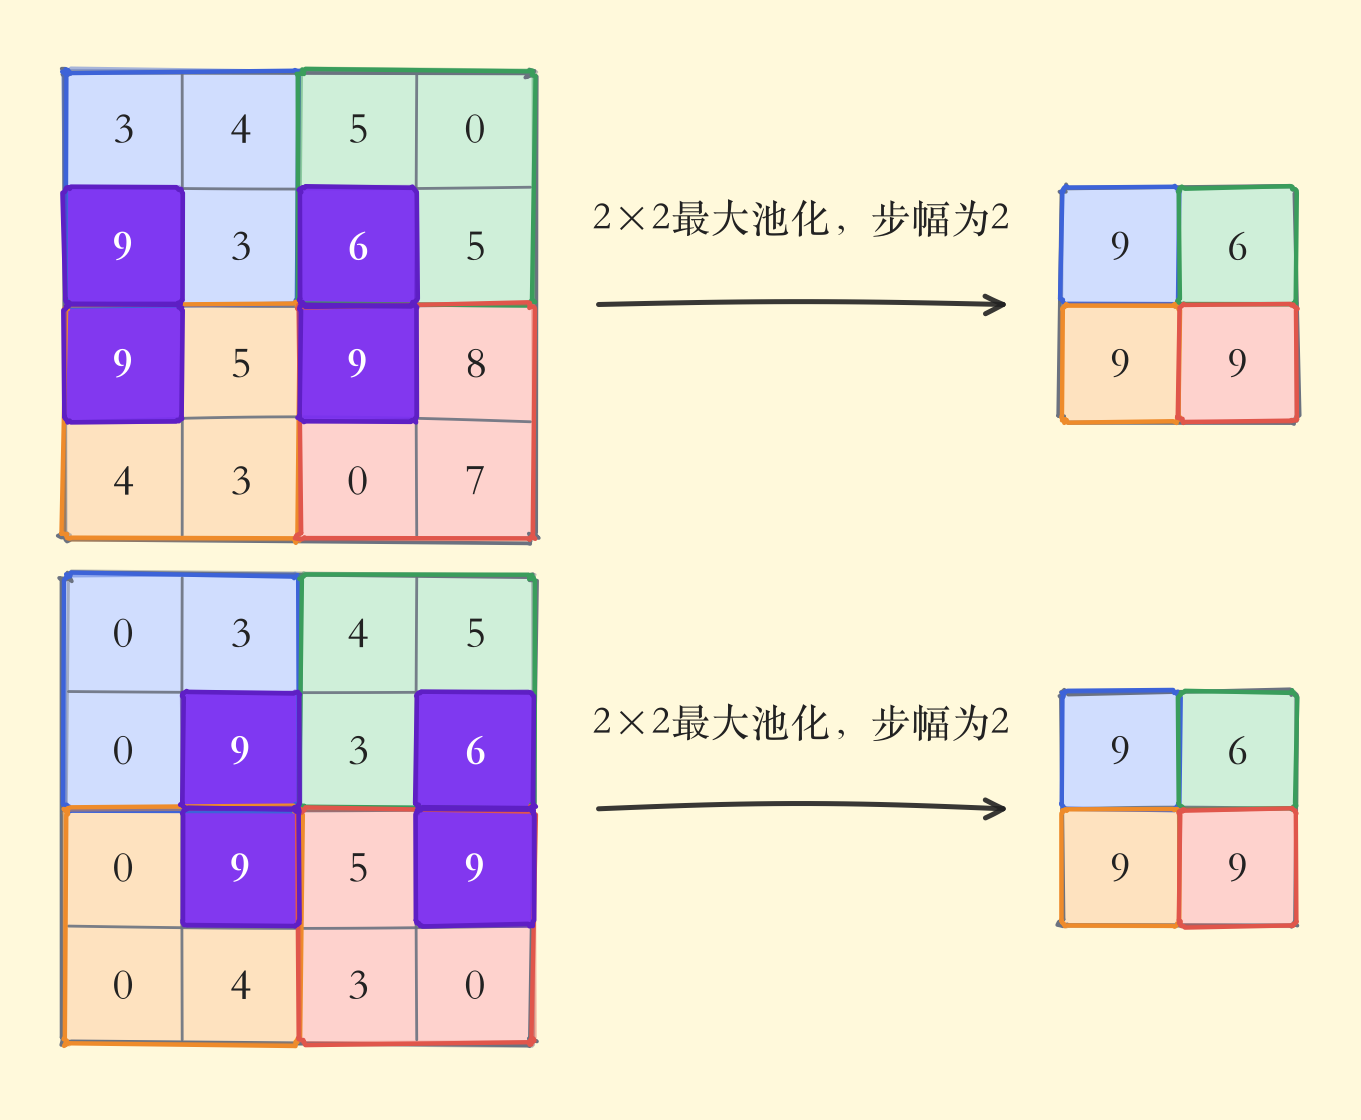
池化的另一个特点是对微小偏差具有鲁棒性:数据发生微小偏差时,池化可能会返回相同的结果。例如数据在宽度方向上偏离1个元素,返回的结果不变。
API使用:
# 最大池化
torch.nn.MaxPool2d(kernel_size, stride, padding)
# 平均池化
torch.nn.AvgPool2d(kernel_size, stride, padding)
2
3
4
接着上面的图片例子,卷积之后再叠一层6×6最大池化,对比原图、卷积后、池化后三个阶段的效果:
import torch
import matplotlib.pyplot as plt
import os

# 读取图片(本地有Kelsen.jpg就用, 没有就用sklearn内置china图片兜底)
if os.path.exists("Kelsen.jpg"):
    img = plt.imread("Kelsen.jpg")
else:
    from sklearn.datasets import load_sample_image
    img = load_sample_image("china.jpg")
print("图片数据形状:", img.shape)

# 补batch维: (H,W,C) -> (1,C,H,W)
input = torch.tensor(img).permute(2, 0, 1).float().unsqueeze(0)
print("输入特征图形状:", input.shape)

# 初始化卷积核
conv = torch.nn.Conv2d(in_channels=3, out_channels=3, kernel_size=9, stride=3, padding=0, bias=False)

# 对输入特征图进行卷积操作
output1 = conv(input)
print("卷积后输出特征图形状:", output1.shape)

# 初始化池化层
pool = torch.nn.MaxPool2d(kernel_size=6, stride=6, padding=1)

# 进行池化操作
output2 = pool(output1)
print("池化后输出特征图形状:", output2.shape)

# 可视化: 取第0个样本并把通道维挪回最后
vis1 = torch.clamp(output1[0].int(), 0, 255).permute(1, 2, 0).numpy()
vis2 = torch.clamp(output2[0].int(), 0, 255).permute(1, 2, 0).numpy()

fig, ax = plt.subplots(1, 3, figsize=(15, 5))
ax[0].imshow(img)
ax[1].imshow(vis1)
ax[2].imshow(vis2)
plt.axis("off")
plt.show()
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
图片数据形状: (427, 640, 3)
输入特征图形状: torch.Size([1, 3, 427, 640])
卷积后输出特征图形状: torch.Size([1, 3, 140, 211])
池化后输出特征图形状: torch.Size([1, 3, 23, 35])
2
3
4
# 1.9 深度卷积神经网络:四大经典架构
将神经网络的层数加深,可以更有效地提取层次信息,还可以减少参数数量,从而让学习更加高效。基于CNN构建深度神经网络,可以提取出更多的图片信息,大幅提高图像识别精度——在人工智能的发展历程中,正是深度卷积神经网络,掀起了最近一轮深度学习的热潮。
# 1.9.1 AlexNet:深度学习兴起的标志
2012年由Alex Krizhevsky、Ilya Sutskever与Geoffrey Hinton合作提出,是一个基于CNN构建的神经网络模型,主要架构包含8层(5个卷积层+3个全连接层),激活函数使用ReLU,最后经全连接层输出结果,并且使用了Dropout。
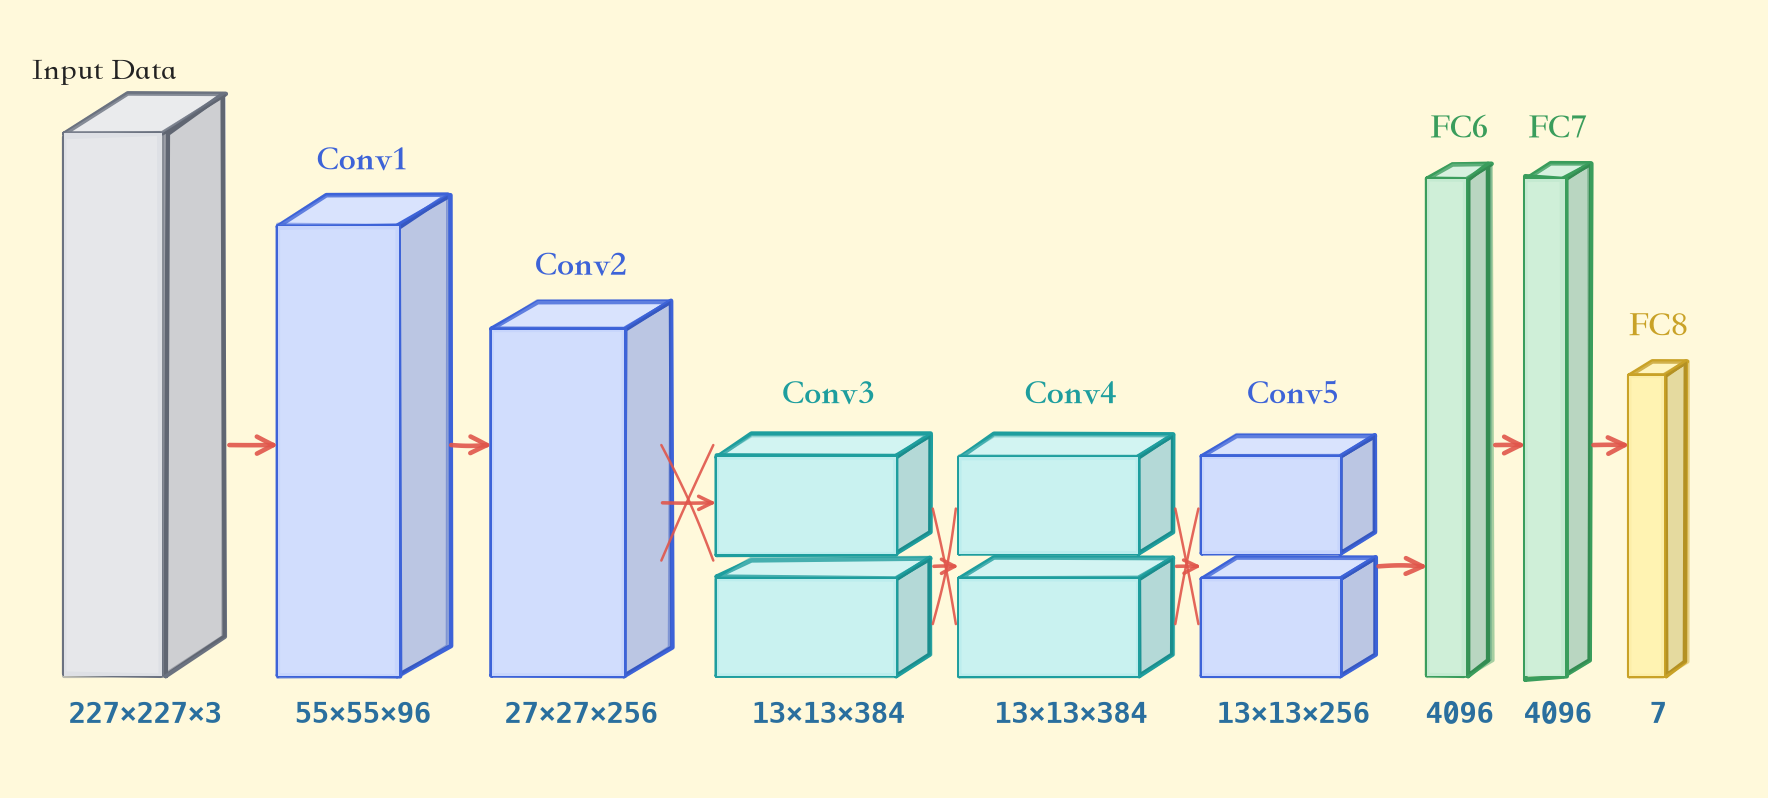
AlexNet在当年的ImageNet图像分类挑战赛中大幅刷新性能纪录,引发广泛关注——这被认为是深度学习兴起的标志。
# 1.9.2 VGG:简单即美
2014年由牛津大学Visual Geometry Group(视觉几何组)提出。VGG网络由多个卷积-池化层堆叠构成,将有权重的层(卷积层或全连接层)叠加至16或19层,也被称为VGG-16和VGG-19。
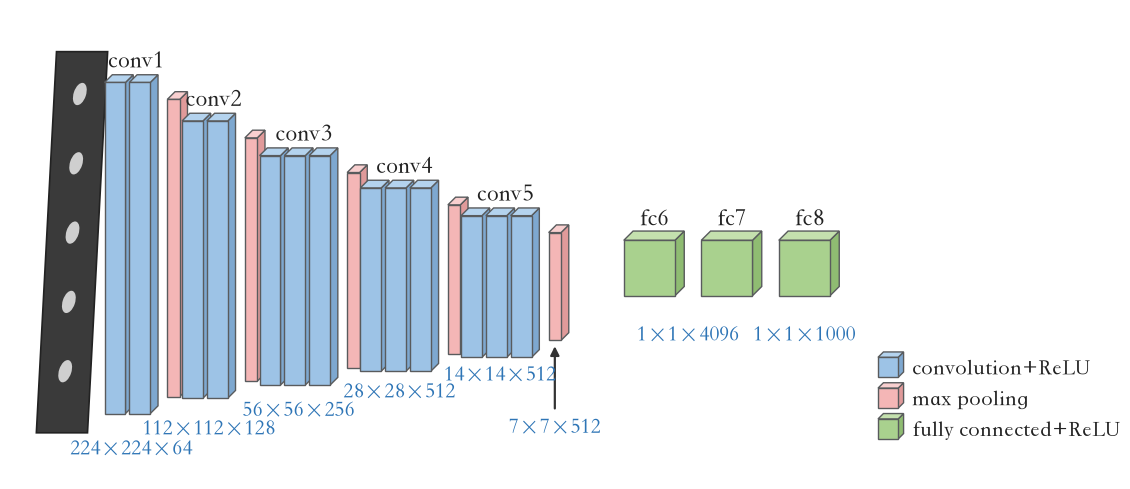
VGG结构简单,应用性强,因此得到了大量技术人员的青睐。
# 1.9.3 GoogleNet:纵向有深度,横向也有深度
2014年由Google团队提出的深度卷积神经网络架构。
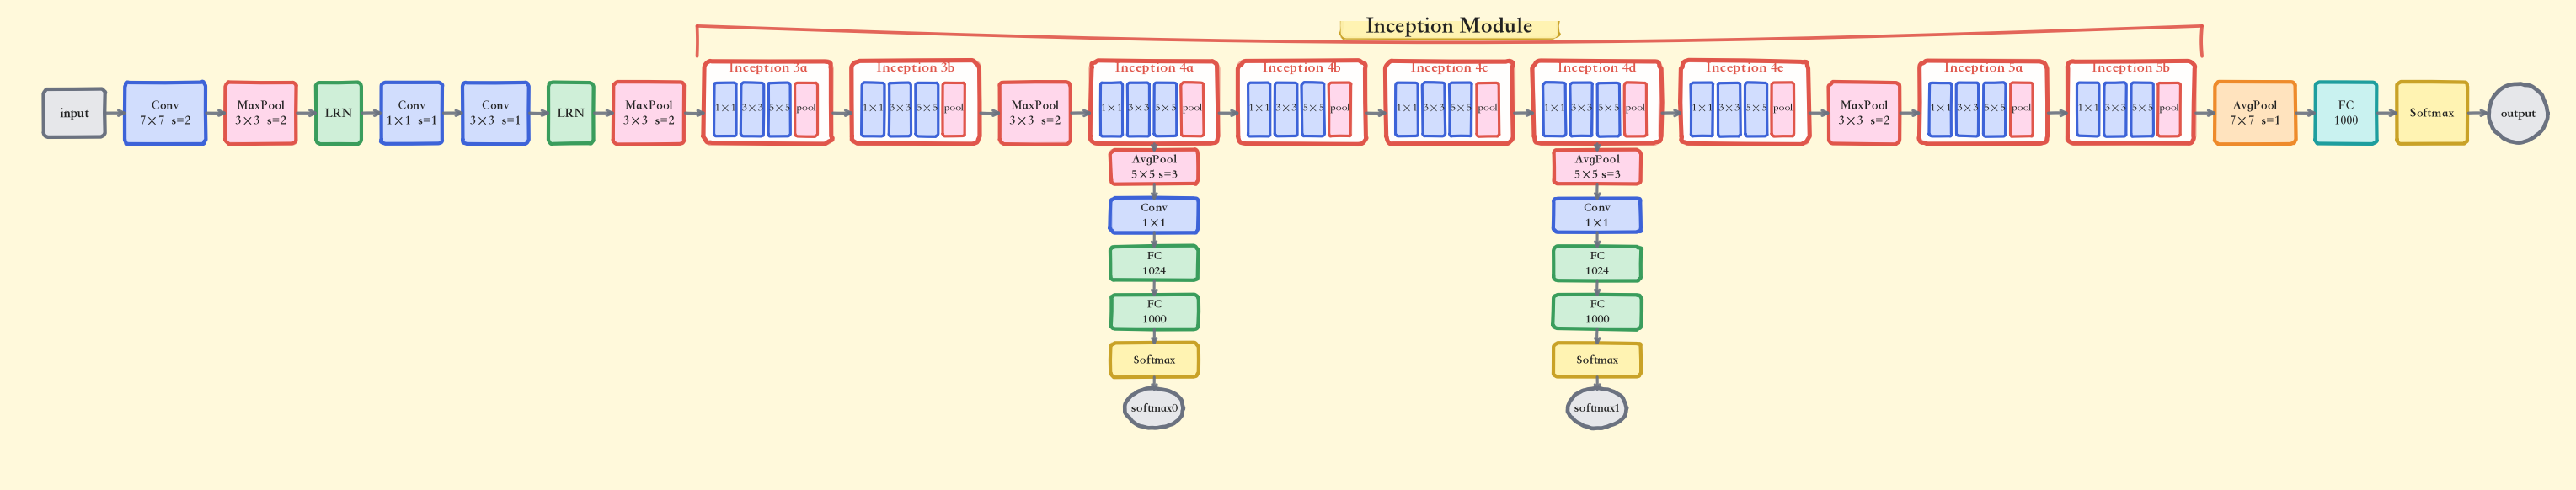
整体上看,GoogleNet有更加复杂的网络结构,不过它的底层依然和CNN相同。它的特点是引入了Inception结构,使得网络不仅纵向上有深度,在横向上也有深度:
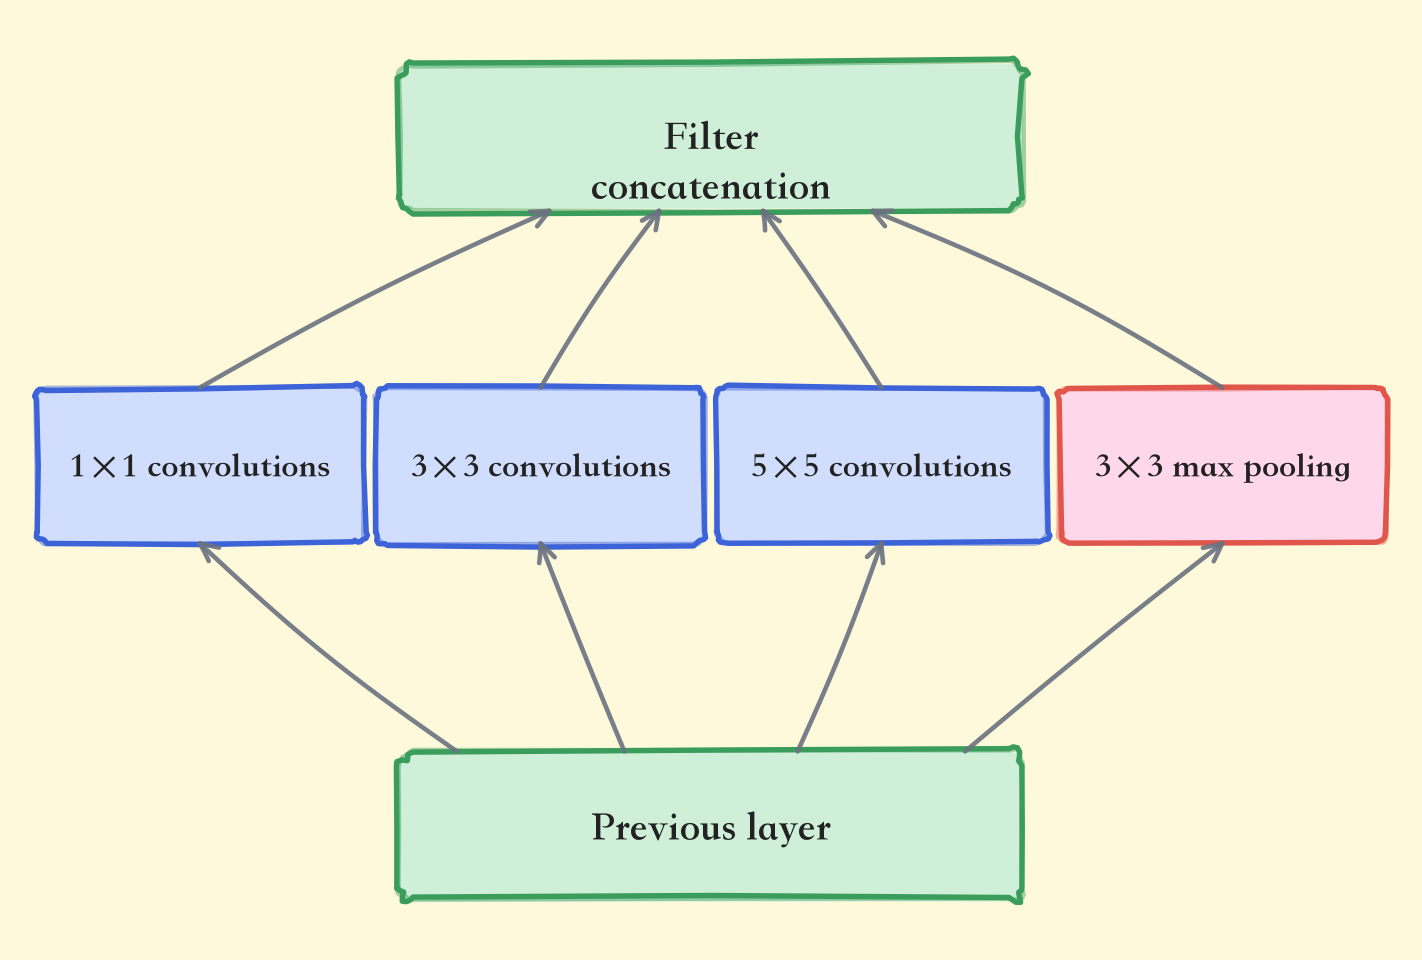
横向上使用多个大小不同的滤波器、最后再合并,有利于减少参数数量、解决梯度消失问题。
# 1.9.4 ResNet:残差连接治好梯度消失
2015年由微软团队(何恺明等人)提出,比之前的网络具有更深的结构。
为了解决深度网络的梯度消失问题,ResNet以VGG为基础,引入了快捷结构。这样一来,网络学习的目标就由原始的输出变为了,这被称为残差学习;引入的这个恒等映射被称为残差连接(或者跳跃连接),这种网络结构也被称为残差网络(Residual Network, ResNet)。
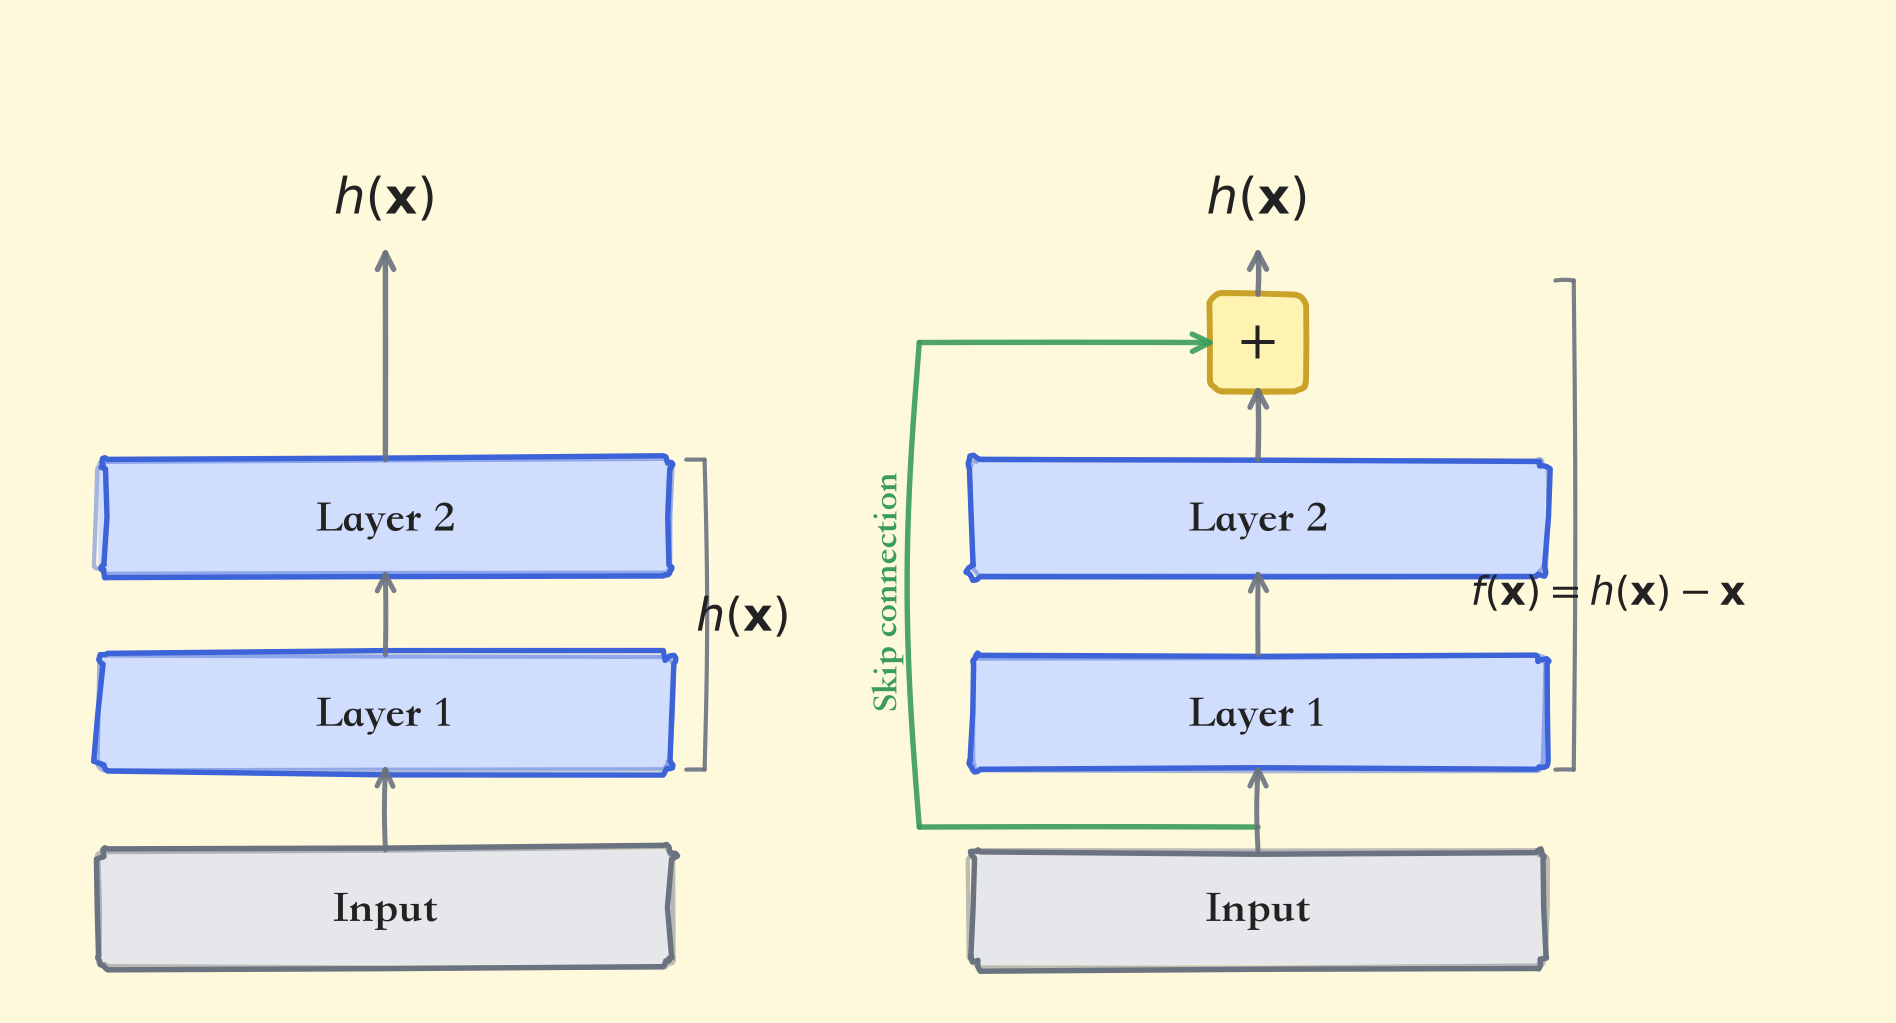
ResNet有效地解决了深度网络中的梯度消失和梯度爆炸问题,在加深层的同时,提高了网络性能。
# 1.10 案例:Fashion MNIST服装分类
使用Fashion MNIST数据集:https://www.kaggle.com/datasets/zalando-research/fashionmnist (opens new window)。
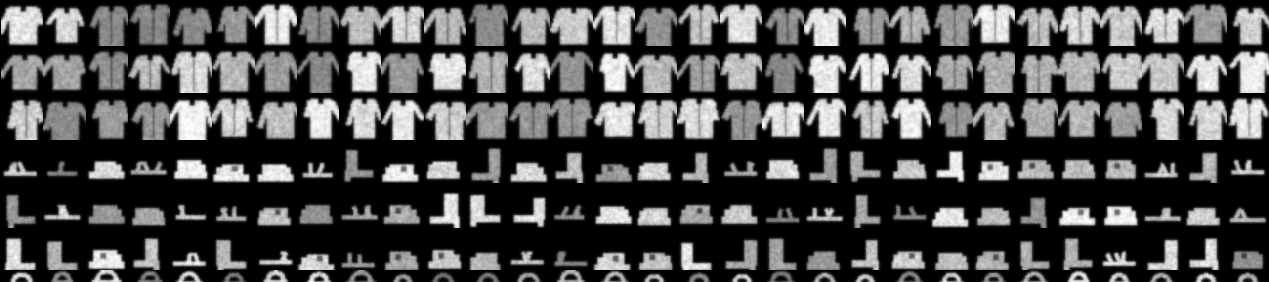
数据集中每个样本都是28×28的灰度图像,与来自10个类别的标签相关联。标签对应如下:
- 0:T恤/上衣
- 1:裤子
- 2:套头衫
- 3:连衣裙
- 4:外套
- 5:凉鞋
- 6:衬衫
- 7:运动鞋
- 8:包
- 9:靴子
# 1.10.1 加载数据
数据在csv文件中,每行数据为1个样本,第1列为标签,2到785列为784个像素,需要将其转换为28×28的形状。像素归一化是最容易漏掉的一步:原始像素是0~255的整数,数值过大会让Sigmoid一开始就落在饱和区、Xavier初始化的尺度假设也失效,所以统一除以255缩放到0~1:
import torch
import pandas as pd
import torch.nn as nn
import matplotlib.pyplot as plt
import os
from torch.utils.data import TensorDataset, DataLoader

# 读取数据: 优先用本地CSV; 没有就用torchvision自动下载(首次联网, 之后走缓存)
def load_fashion_mnist():
    train_csv = "fashion-mnist_train.csv"
    test_csv = "fashion-mnist_test.csv"
    if os.path.exists(train_csv) and os.path.exists(test_csv):
        # 本地CSV格式: 第一列是标签, 后784列是像素值
        train = pd.read_csv(train_csv)
        test = pd.read_csv(test_csv)
        X_train = torch.tensor(train.iloc[:, 1:].values, dtype=torch.float32).reshape(-1, 1, 28, 28) / 255.
        y_train = torch.tensor(train.iloc[:, 0].values, dtype=torch.int64)
        X_test = torch.tensor(test.iloc[:, 1:].values, dtype=torch.float32).reshape(-1, 1, 28, 28) / 255.
        y_test = torch.tensor(test.iloc[:, 0].values, dtype=torch.int64)
    else:
        from torchvision import datasets
        train = datasets.FashionMNIST(root=".", train=True, download=True)
        test = datasets.FashionMNIST(root=".", train=False, download=True)
        X_train = train.data.float().reshape(-1, 1, 28, 28) / 255.
        y_train = train.targets
        X_test = test.data.float().reshape(-1, 1, 28, 28) / 255.
        y_test = test.targets
    return X_train, y_train, X_test, y_test

X_train, y_train, X_test, y_test = load_fashion_mnist()
print(X_train.shape, X_train.min().item(), X_train.max().item())
plt.imshow(X_train[12345, 0, :, :], cmap="gray")
plt.show()
# 构建数据集
train_dataset = TensorDataset(X_train, y_train)
test_dataset = TensorDataset(X_test, y_test)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
torch.Size([60000, 1, 28, 28]) 0.0 1.0
# 1.10.2 搭建模型
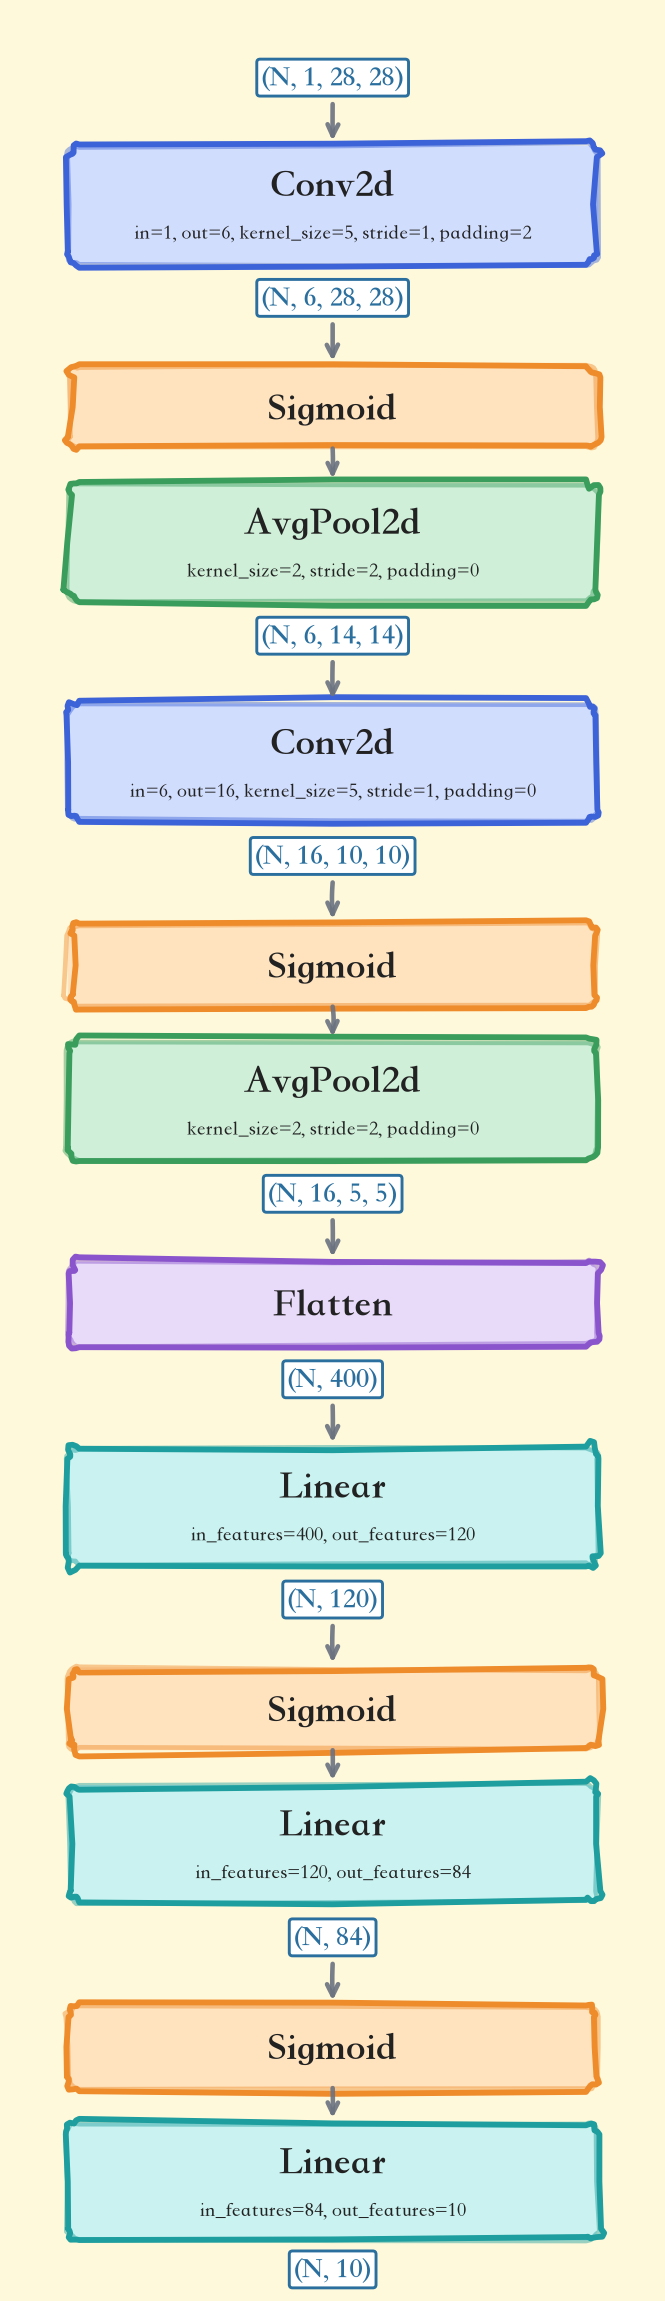
搭建一个经典LeNet-5风格的网络:卷积→池化→卷积→池化→拉平→三层全连接。这是1998年Yann LeCun为手写数字识别提出的结构,也是今天所有CNN的雏形。
# 搭建模型
model = nn.Sequential(
    nn.Conv2d(1, 6, kernel_size=5, padding=2),
    nn.Sigmoid(),
    nn.AvgPool2d(kernel_size=2, stride=2),
    nn.Conv2d(6, 16, kernel_size=5),
    nn.Sigmoid(),
    nn.AvgPool2d(kernel_size=2, stride=2),
    nn.Flatten(),  # 拉平
    nn.Linear(400, 120),
    nn.Sigmoid(),
    nn.Linear(120, 84),
    nn.Sigmoid(),
    nn.Linear(84, 10),
)


# 给模型一个输入,逐层前向, 打印各层输出形状是否符合预期
X = torch.rand(size=(1, 1, 28, 28), dtype=torch.float32)
for layer in model:
    X = layer(X)
    print(f"{layer.__class__.__name__:<12}output shape: {X.shape}")
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
Conv2d      output shape: torch.Size([1, 6, 28, 28])
Sigmoid     output shape: torch.Size([1, 6, 28, 28])
AvgPool2d   output shape: torch.Size([1, 6, 14, 14])
Conv2d      output shape: torch.Size([1, 16, 10, 10])
Sigmoid     output shape: torch.Size([1, 16, 10, 10])
AvgPool2d   output shape: torch.Size([1, 16, 5, 5])
Flatten     output shape: torch.Size([1, 400])
Linear      output shape: torch.Size([1, 120])
Sigmoid     output shape: torch.Size([1, 120])
Linear      output shape: torch.Size([1, 84])
Sigmoid     output shape: torch.Size([1, 84])
Linear      output shape: torch.Size([1, 10])
2
3
4
5
6
7
8
9
10
11
12
拿着1.7.4的公式逐层核对一遍,这套形状变换就彻底通了:
- 第一层卷积核5×5、
padding=2,输出保持28×28,通道数变成6; - 2×2池化把空间尺寸减半:28×28 → 14×14;
- 第二层卷积无填充:,得到10×10、16通道;
- 再池化减半:10×10 → 5×5;
Flatten把16张5×5特征图拉成一维:,这正是下一层nn.Linear(400, 120)输入维度必须是400的原因;- 最后84 → 10,输出10个类别的logits。注意最后一层不加Softmax——
CrossEntropyLoss内部已包含。
# 1.10.3 模型训练
先用model.apply对线性层和卷积层做Xavier均匀初始化,损失用交叉熵,优化器用SGD。每个epoch中:训练集上前向→反向→更新,测试集上只前向、算准确率。训练阶段model.train()、评估阶段model.eval()+torch.no_grad()这对开关要养成肌肉记忆(虽然LeNet里没有Dropout/BN,但今天先把规矩立起来)。
# 模型训练
def train(model, train_dataset, test_dataset, lr, epoch_num, batch_size, device):
    def init_weights(layer):
        # 对线性层和卷积层使用Xavier均匀分布初始化参数
        if type(layer) == nn.Linear or type(layer) == nn.Conv2d:
            nn.init.xavier_uniform_(layer.weight)

    model.apply(init_weights)  # 初始化参数
    model.to(device)  # 将模型加载到设备
    loss = nn.CrossEntropyLoss()  # 损失函数
    optimizer = torch.optim.SGD(model.parameters(), lr=lr)  # 优化器
    # DataLoader在循环外构建一次即可; 测试集不需要打乱顺序
    train_loader = DataLoader(dataset=train_dataset, batch_size=batch_size, shuffle=True)
    test_loader = DataLoader(dataset=test_dataset, batch_size=batch_size, shuffle=False)
    for epoch in range(epoch_num):

        # 训练过程
        model.train()  # 将模型设置为训练模式
        loss_accumulate = 0
        train_correct_accumulate = 0
        for batch_count, (X, y) in enumerate(train_loader):
            # 前向传播
            X, y = X.to(device), y.to(device)
            output = model(X)
            # 反向传播: 清零梯度 -> 反向传播 -> 更新参数, 顺序不能乱
            loss_value = loss(output, y)
            optimizer.zero_grad()
            loss_value.backward()
            optimizer.step()
            # 累加损失
            loss_accumulate += loss_value.item()
            # 累加正确输出的数量
            _, pred = output.max(1)
            train_correct_accumulate += pred.eq(y).sum()
            # 打印进度条
            print(f"\repoch:{epoch:0>2}[{'='*(int((batch_count+1) / len(train_loader) * 50)):<50}]", end="")
        this_loss = loss_accumulate / len(train_loader)  # 计算平均损失
        this_train_correct = train_correct_accumulate / len(train_dataset)  # 计算训练准确率

        # 测试过程
        model.eval()  # 将模型设置为评估模式
        test_correct_accumulate = 0
        with torch.no_grad():  # 关闭梯度计算
            for X, y in test_loader:
                # 前向传播
                X, y = X.to(device), y.to(device)
                output = model(X)
                # 累加正确输出的数量
                _, pred = output.max(1)
                test_correct_accumulate += pred.eq(y).sum()
        this_test_correct = test_correct_accumulate / len(test_dataset)  # 计算测试准确率

        # 打印损失,训练准确率,测试准确率
        print(f" loss:{this_loss:.6f}, train_acc:{this_train_correct:.6f}, test_acc:{this_test_correct:.6f}")

# N卡用cuda, Mac芯片用mps, 都没有就退回cpu
device = torch.device("cuda" if torch.cuda.is_available()
                      else "mps" if torch.backends.mps.is_available() else "cpu")
train(model, train_dataset, test_dataset, lr=0.9, epoch_num=20, batch_size=256, device=device)
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
下面是Mac M系列芯片(MPS)上的真实运行结果,20个epoch约44秒:
epoch:00[==================================================] loss:2.293881, train_acc:0.119850, test_acc:0.241600
epoch:01[==================================================] loss:1.166366, train_acc:0.534333, test_acc:0.637000
...
epoch:09[==================================================] loss:0.472361, train_acc:0.820917, test_acc:0.795500
...
epoch:19[==================================================] loss:0.362123, train_acc:0.865767, test_acc:0.841500
2
3
4
5
6
第0个epoch准确率还在12%附近瞎猜(Sigmoid网络起步慢是正常现象,从第1个epoch开始就快速爬升),20个epoch后训练准确率86.6%、测试准确率84.2%,两条线同步上升、差距很小,没有明显过拟合——说明卷积+池化提取的特征确实抓住了服装的形状而不是像素噪声。想再涨几个点,可以把Sigmoid换成ReLU、He初始化、优化器换Adam,这些改动Day21现代CNN里会系统地做一遍。这里严格说还有一个工程规范没做:训练过程中我们直接"盯"着测试集调参,规范做法应再划出一份独立验证集——这件事连同学习曲线诊断、早停和超参搜索,统一放到Day21训练工程化里解决。
# 1.11 今日回顾与下一站:从LeNet到现代CNN
今天我们完整走了一遍卷积神经网络:卷积层用滑动窗口做乘积累加,靠填充保形状、靠步幅缩尺寸,通道维度上"一个卷积核产出一张特征图";池化层用零参数的窗口运算降维并增强鲁棒性;AlexNet/VGG/GoogleNet/ResNet四代架构展示了"加深"这条主线如何被一步步推进;最后的Fashion MNIST实战里,1998年的LeNet结构在归一化后的数据上依然拿到84%的测试准确率。
有两个细节值得特意记住:一是卷积核扫过全图共享同一组参数,这是CNN参数少、还能识别"无论猫出现在哪个位置"的根本原因;二是网络最后一层输出的是logits,Softmax已内含在交叉熵损失中,不要再加一次。
# 小结
PyTorch训练链路和CNN五大件今天都齐了。但一个能跑的训练循环离"工程可用"还有距离——怎么让每次结果可复现?怎么切数据?怎么早停和存权重?Day21把训练工程化、现代CNN的残差与数据增强、以及CIFAR-10上的架构对决一次讲透。